
Linux 与服务器运维 / 系统课时
为发布失败设计快速回滚
为发布失败设计快速回滚
本课给发布流程补上失败出口:切换新版本前记录稳定版本,切换后执行健康检查;如果新版本没有在限定次数内恢复健康,脚本立即把 current 切回旧版本,并再次验证服务是否真正恢复。
学习目标
- 在发布前可靠记录当前稳定版本,为自动回滚提供明确目标
- 用有限次数的健康检查判定新版本是否可接受,而不是无限等待
- 回滚后再次验证服务状态,区分“链接已切回”和“业务已恢复”
先确定可以回到哪里
自动回滚不能临时猜测“上一个版本”是什么。最简单可靠的来源就是发布开始前的 current 软链接:如果它当前指向一个已经稳定运行的版本,就把这个目标保存下来,再进行新版本切换。
例如发布前状态是:
current -> /opt/demo-app/releases/20260914-001准备发布 20260914-002 时,应先记录 /opt/demo-app/releases/20260914-001。如果新版本健康检查失败,回滚目标就是这个路径,而不是按目录名排序推测上一版。
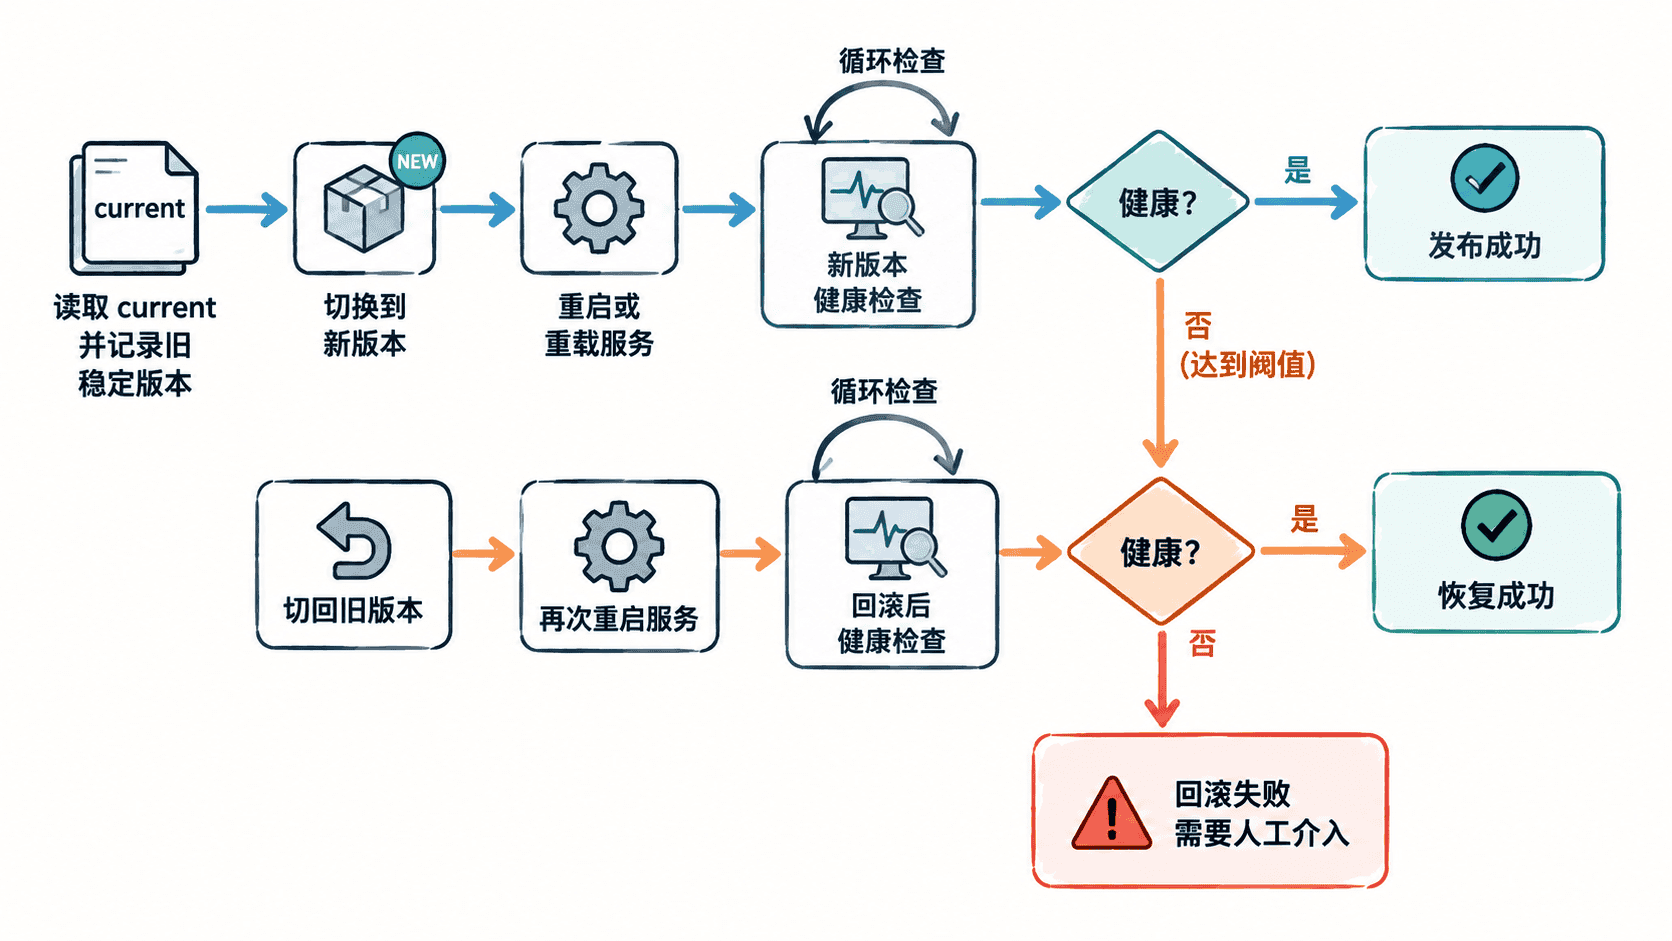
这种做法还有一个好处:即使版本命名不是连续数字,甚至同时保留灰度、候选版本目录,回滚仍然只依赖发布前真实运行的稳定入口。
把健康检查接入回滚脚本
下面脚本演示完整边界:读取旧版本、切换新版本、重启服务、检查 HTTP 健康接口;失败时恢复旧链接并再次检查。示例使用 systemctl 和本机 8080 端口,实际服务名和端口应按部署环境调整。
#!/usr/bin/env bash
set -Eeuo pipefail

APP_ROOT="/opt/demo-app"
RELEASES_DIR="$APP_ROOT/releases"
CURRENT_LINK="$APP_ROOT/current"
SERVICE_NAME="demo-app"
HEALTH_URL="http://127.0.0.1:8080/health"
MAX_RETRIES=5
RETRY_INTERVAL=2

NEW_VERSION="${1:-}"
NEW_DIR="$RELEASES_DIR/$NEW_VERSION"

if [[ -z "$NEW_VERSION" || ! -d "$NEW_DIR" ]]; then
  echo "Usage: $0 <existing-version>" >&2
  exit 2
fi

if [[ ! -L "$CURRENT_LINK" ]]; then
  echo "Current link does not exist" >&2
  exit 3
fi

PREVIOUS_DIR="$(readlink -f "$CURRENT_LINK")"

check_health() {
  local attempt
  for ((attempt = 1; attempt <= MAX_RETRIES; attempt++)); do
    if curl --fail --silent --show-error --max-time 2 "$HEALTH_URL" >/dev/null; then
      return 0
    fi
    sleep "$RETRY_INTERVAL"
  done
  return 1
}

switch_to() {
  local target="$1"
  ln -sfn "$target" "$APP_ROOT/current.next"
  mv -Tf "$APP_ROOT/current.next" "$CURRENT_LINK"
}

switch_to "$NEW_DIR"
systemctl restart "$SERVICE_NAME"

if check_health; then
  echo "Deployment healthy: $NEW_VERSION"
  exit 0
fi

echo "Health check failed, rolling back" >&2

# 回滚目标来自发布前真实运行的版本,不根据目录名推算。
switch_to "$PREVIOUS_DIR"
systemctl restart "$SERVICE_NAME"

if check_health; then
  echo "Rollback succeeded"
  echo "restored=$PREVIOUS_DIR"
  exit 10
fi

echo "Rollback failed, manual intervention required" >&2
exit 20
假设 current 原先指向 20260914-001,而 20260914-002 已经存在,可以这样执行:
sudo bash deploy-with-rollback.sh 20260914-002
printf 'exit=%s\n' "$?"
如果新版本健康,预期输出为:
Deployment healthy: 20260914-002
exit=0
如果新版本健康检查失败、旧版本恢复正常,预期结果类似:
Health check failed, rolling back
Rollback succeeded
restored=/opt/demo-app/releases/20260914-001
exit=10
脚本故意让“发布成功”“已自动回滚”“回滚失败”使用不同退出码。这样 CI/CD 平台或上层调度脚本可以准确区分三种状态,而不是把已经发生故障并回滚的发布误报成正常成功。
健康检查必须代表真实可用
只检查进程存在并不足以证明发布成功。进程可能已经启动,但数据库连接失败、依赖服务不可达,或者 HTTP 线程还没有完成初始化。健康接口应至少覆盖“服务能够接受请求”这一层条件,关键业务还可以增加轻量依赖检查。
同时要给健康检查明确上限。示例最多检查 5 次,每次失败后等待 2 秒,因此它不会因为新版本永远无法启动而无限阻塞发布流水线。生产环境可以根据实际启动时间调整次数和间隔,但应保持“最终一定得到成功或失败结论”。
不要把具有副作用的业务接口当健康检查,例如创建订单、扣减库存或写入正式数据。发布验证应尽量只读、快速、可重复,否则健康检查本身可能成为新的故障来源。
回滚后还要重新验收
执行 ln 或 mv 成功,只能证明软链接恢复了,并不能证明旧进程已经正常工作。因此脚本在切回 PREVIOUS_DIR 后重新启动服务,并再次调用同一个健康检查函数。
可以在自动化结束后再核对当前入口:
readlink -f /opt/demo-app/current
systemctl is-active demo-app
curl --fail --silent http://127.0.0.1:8080/health
旧版本恢复正常时,预期结果应包含旧版本路径、服务活动状态以及健康接口的真实响应。假设示例健康接口返回 OK:
/opt/demo-app/releases/20260914-001
active
OK
如果回滚后的健康检查仍失败,脚本必须停止继续自动尝试其他版本,并返回需要人工介入的状态。连续向更老版本递归回滚看似自动化程度更高,实际却可能掩盖数据库迁移、配置变更或基础设施故障,使现场状态越来越难判断。
识别不能只靠切链接回滚的发布
版本目录加软链接特别适合应用文件本身可逆的发布,但它不能自动撤销所有外部变化。如果新版本同时执行了不兼容的数据库结构修改、删除了共享文件、修改了无法向后兼容的配置,单纯切回旧代码可能仍然无法启动。
因此发布流程应把“代码切换”和“不可逆变更”分开设计。数据库变更优先采用向前兼容的扩展方式,让新旧两个应用版本在发布窗口内都能运行。只有这样,健康检查失败时的快速回滚才真正具备确定性:旧版本目录仍在、回滚目标已记录、入口可以立即切回,并且回滚后的业务状态还能被再次验证。