
Rust / 系统课时
跨 IO 解析与领域错误做转换
跨 IO 解析与领域错误做转换
读取配置文件时,一个函数往往会连续遇到文件读取、文本解析和业务校验三类失败。本节把它们收敛成单一应用错误,让上层只依赖稳定边界,同时仍保留底层错误用于日志和追踪。
学习目标
- 区分 IO、解析与领域错误各自应该出现在哪一层
- 使用
From与?把底层错误统一转换为应用错误 - 在统一错误类型中保留
source,避免丢失根因
先按失败来源划分错误
文件不存在、权限不足属于 IO 失败;字符串不能解析成数字属于格式失败;数值能解析但违反业务规则,则属于领域失败。三者的处理策略不同,因此不应全部压成一个字符串,也不应把 std::io::Error、ParseIntError 直接暴露给更高层。
应用边界可以定义一个稳定的 AppError,内部再携带原始错误。这样调用者只面对 Result<T, AppError>,底层库类型不会扩散到每一层函数签名。
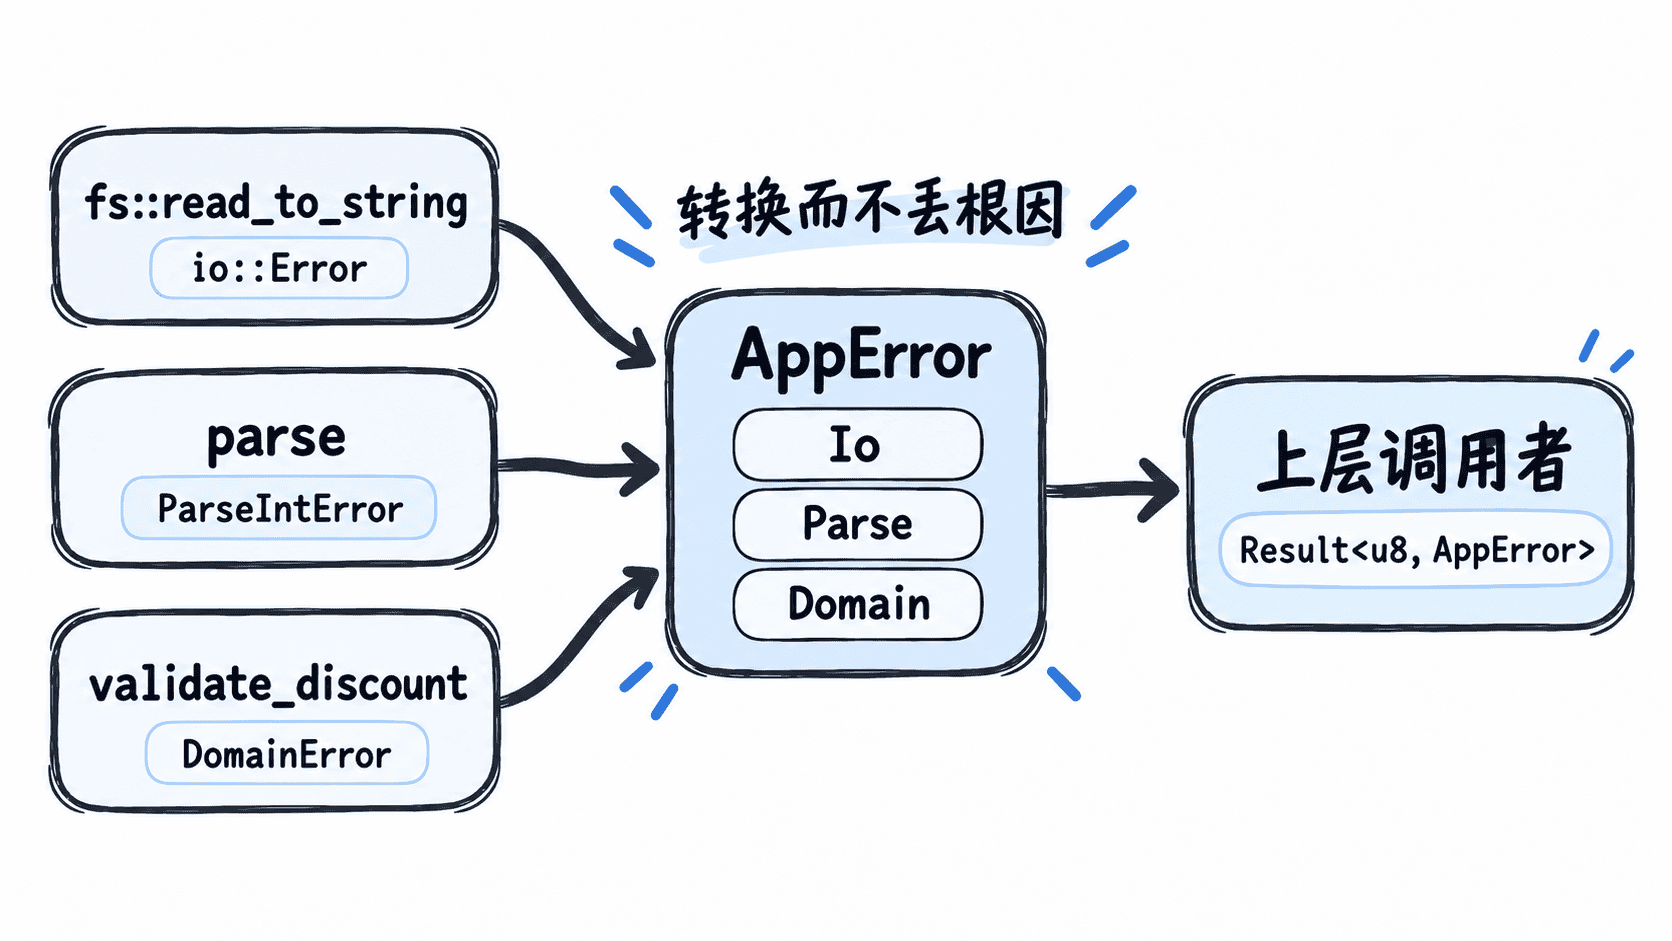
在应用边界完成统一转换
下面的完整程序用 From 实现三种错误到 AppError 的转换。load_discount 内部因此可以连续使用 ?,而返回类型始终保持为 Result<u8, AppError>。
use std::{error::Error, fmt, fs, io, num::ParseIntError};

#[derive(Debug)]
struct DomainError(u8);

impl fmt::Display for DomainError {
    fn fmt(&self, f: &mut fmt::Formatter<'_>) -> fmt::Result {
        write!(f, "折扣必须在 1..=100,实际为 {}", self.0)
    }
}

impl Error for DomainError {}

#[derive(Debug)]
enum AppError {
    Io(io::Error),
    Parse(ParseIntError),
    Domain(DomainError),
}

impl fmt::Display for AppError {
    fn fmt(&self, f: &mut fmt::Formatter<'_>) -> fmt::Result {
        match self {
            AppError::Io(_) => write!(f, "文件读取失败"),
            AppError::Parse(_) => write!(f, "数字解析失败"),
            AppError::Domain(e) => write!(f, "业务校验失败: {e}"),
        }
    }
}

impl Error for AppError {
    fn source(&self) -> Option<&(dyn Error + 'static)> {
        match self {
            AppError::Io(e) => Some(e),
            AppError::Parse(e) => Some(e),
            AppError::Domain(e) => Some(e),
        }
    }
}

impl From<io::Error> for AppError {
    fn from(value: io::Error) -> Self {
        AppError::Io(value)
    }
}

impl From<ParseIntError> for AppError {
    fn from(value: ParseIntError) -> Self {
        AppError::Parse(value)
    }
}

impl From<DomainError> for AppError {
    fn from(value: DomainError) -> Self {
        AppError::Domain(value)
    }
}

fn validate_discount(value: u8) -> Result<(), DomainError> {
    if (1..=100).contains(&value) {
        Ok(())
    } else {
        Err(DomainError(value))
    }
}

fn load_discount(path: &str) -> Result<u8, AppError> {
    let text = fs::read_to_string(path)?;
    let value = text.trim().parse::<u8>()?;
    validate_discount(value)?;
    Ok(value)
}

fn print_result(name: &str, result: Result<u8, AppError>) {
    match result {
        Ok(value) => println!("{name} -> {value}"),
        Err(AppError::Io(_)) => println!("{name} -> IO"),
        Err(AppError::Parse(_)) => println!("{name} -> PARSE"),
        Err(AppError::Domain(_)) => println!("{name} -> DOMAIN"),
    }
}

fn main() -> Result<(), io::Error> {
    let _ = fs::remove_file("missing-discount.txt");
    print_result("missing", load_discount("missing-discount.txt"));

    fs::write("discount.txt", "abc\n")?;
    print_result("invalid-text", load_discount("discount.txt"));

    fs::write("discount.txt", "120\n")?;
    print_result("invalid-domain", load_discount("discount.txt"));

    fs::write("discount.txt", "15\n")?;
    print_result("valid", load_discount("discount.txt"));

    fs::remove_file("discount.txt")?;
    Ok(())
}
预期输出
missing -> IO
invalid-text -> PARSE
invalid-domain -> DOMAIN
valid -> 15
这里故意按变体输出固定标签,避免不同操作系统的 IO 错误文本影响验证。真正记录日志时,可以打印 AppError,并沿 source() 继续查看原始 io::Error 或 ParseIntError。
转换不等于抹掉错误语义
统一错误类型的目的,是稳定层与层之间的契约,而不是把所有失败变成同一句话。应用层需要知道“读取失败、格式失败还是业务失败”,因此应保留有意义的变体;只有展示给最终用户时,才进一步转换成面向用户的消息或状态码。
把转换放在真正的边界上
如果某个错误只在基础设施层内部使用,就让它停留在那里;当它即将跨到应用层时,再转换成应用层定义的错误。领域校验同理:领域层返回领域错误,应用层负责把它纳入自己的错误枚举。
这种做法让依赖方向清晰:底层可以替换文件库或解析库,上层仍只依赖 AppError;与此同时,错误链仍保留足够上下文用于诊断。