
Rust / 系统课时
让 CI 失败结果可快速定位
让 CI 失败结果可快速定位
这一篇解决“CI 明明失败了,但打开日志后不知道先看哪里”的问题。核心做法是让失败步骤留下可读日志、保留关键上下文,并把测试报告与调试文件作为工件保存,让一次失败可以被快速复盘,而不是只能重新跑一遍。
学习目标
- 能为测试命令保留完整且可读的失败日志
- 能理解缓存、失败步骤和工件在定位问题中的不同职责
- 能设计一条从失败命令到证据文件的最短诊断路径
先区分三类证据
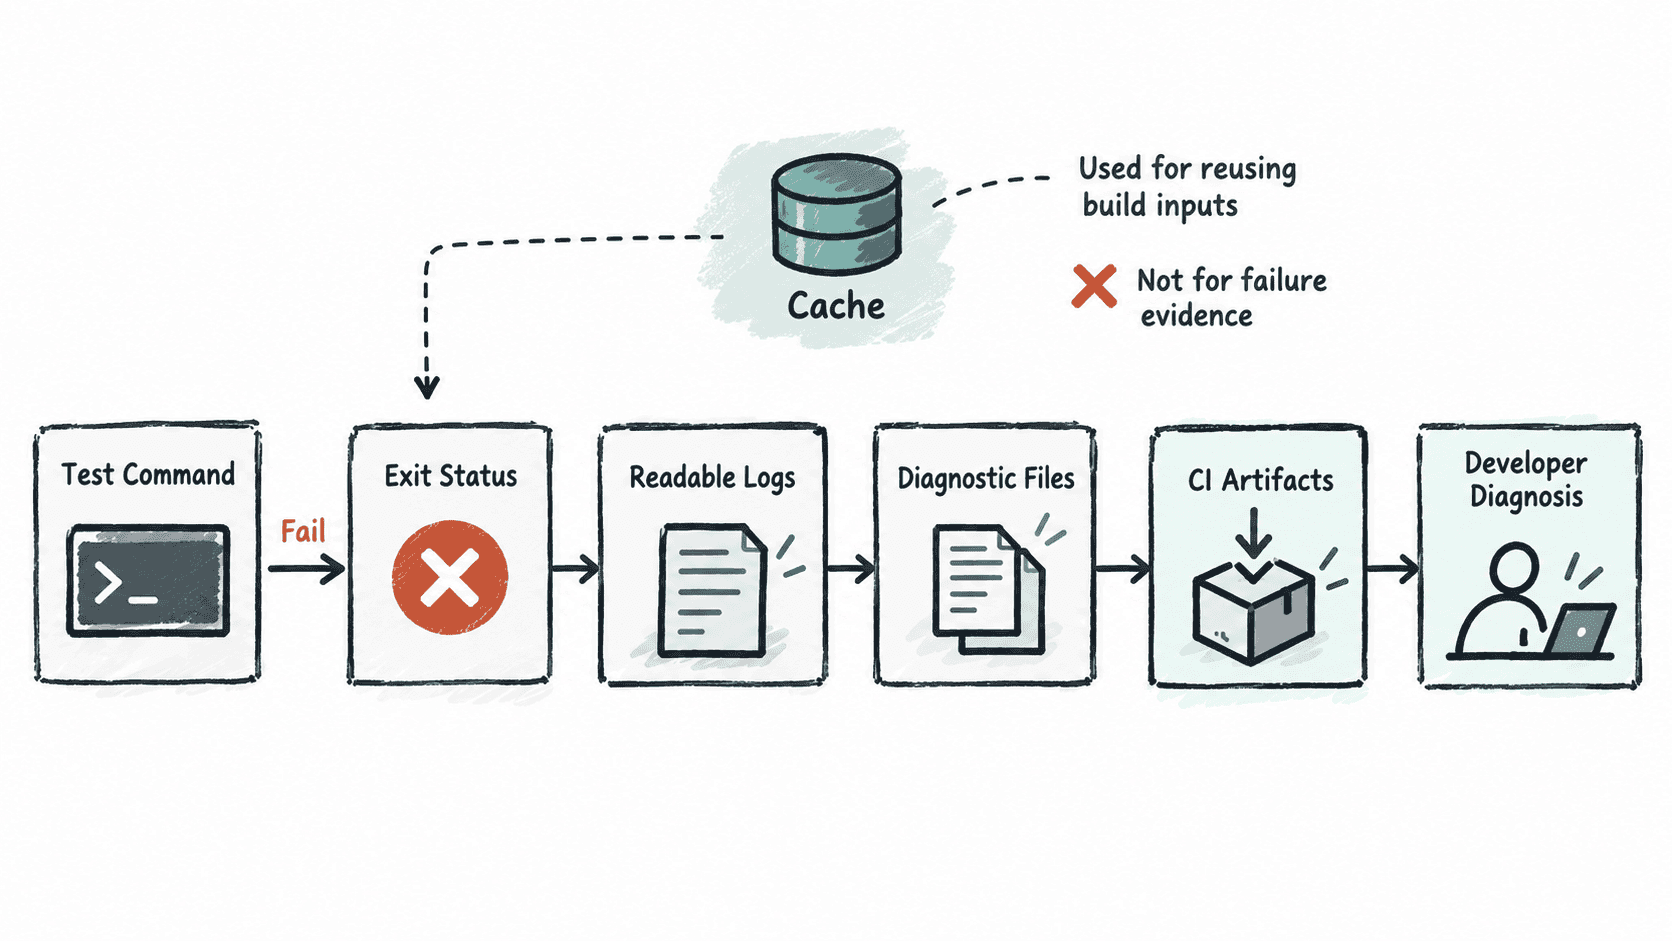
CI 失败后的信息通常不是一份日志就够了。日志回答“哪里失败”,测试输出或报告回答“具体发生了什么”,工件则负责保存失败现场,方便在任务结束后继续分析。
| 证据 | 主要用途 | 典型内容 |
|---|---|---|
| 任务日志 | 快速定位失败步骤 | 命令、错误信息、退出码 |
| 测试输出 | 判断失败行为 | 断言失败、测试名称、回溯信息 |
| 工件 | 保存可离线分析的现场 | 日志文件、报告、覆盖率数据 |
缓存解决的是“减少重复准备时间”,并不等于“保存失败现场”。失败诊断依赖的是可复现命令和明确证据,而不是某一次构建刚好命中了缓存。
先让失败命令留下完整日志
在 shell 环境中,常见问题是直接运行测试命令后,日志只存在于当前终端;CI 页面截断输出后,关键信息可能难以恢复。可以同时输出到终端和文件,并保留原测试进程的退出码。
set -o pipefail
cargo test --all-targets 2>&1 | tee test.log
status=${PIPESTATUS[0]}
printf 'test_exit_code=%s\n' "$status"
exit "$status"
预期结果:当测试命令成功时,终端最后会输出类似下面的退出码信息,同时工作目录中生成 test.log;测试失败时,脚本仍返回原测试命令的非零退出码,不会因为 tee 而被误报为成功。
test_exit_code=0实际测试输出内容和退出码会随项目结果变化。这里固定可验证的事实是:终端保留实时输出,test.log 保留完整日志,最终退出状态由测试命令决定。
让失败步骤足够明确
一个好的 CI 步骤名应该直接告诉排查者“失败的是哪一类动作”。例如把编译、单元测试、覆盖率生成拆成独立步骤,比把所有命令塞进一个大脚本更容易定位。这样日志中的失败点与修复动作可以直接对应。
同时,不要在每个步骤重复打印大量环境信息。只记录会影响判断的版本、关键变量和命令参数,避免真正的错误被噪声淹没。敏感凭据也不应通过普通日志输出。
工件保存什么才有价值
失败工件应围绕“任务结束后还能复原多少现场”来选择。Rust 测试任务中,通常优先保存测试日志、覆盖率文件和测试报告;只有确实用于诊断时,才额外保存构建产物或临时数据。
例如在 CI 的最后阶段,可以先检查文件是否存在,再交给 CI 平台提供的工件上传能力:
for file in test.log lcov.info; do
    if [ -f "$file" ]; then
        printf 'artifact-ready: %s\n' "$file"
    fi
done
预期结果:
artifact-ready: test.log
artifact-ready: lcov.info
这个脚本只负责确认文件是否准备好,并不依赖某个特定 CI 平台的上传接口,因此可以作为上传步骤之前的通用检查。实际上传应使用你所选 CI 平台的工件机制。
缓存为什么不能替代诊断现场
缓存应该服务于“复用不会频繁变化的输入”,例如依赖下载结果或构建中间产物;失败日志和覆盖率报告则属于一次运行产生的证据。把两者混在一起会导致一个常见问题:下一次任务命中缓存后更快了,却没有保留上一次失败时真正需要分析的文件。
因此,CI 的诊断链路应保持清晰:命令退出码告诉你失败,日志告诉你失败位置,测试报告告诉你失败行为,工件让你在任务结束后继续分析,缓存只负责缩短重复工作。 这样即使失败发生在夜间或远程 runner 上,也能根据同一批证据完成定位。