
Rust / 系统课时
定位 flaky test 的真实原因
定位 flaky test 的真实原因
flaky test 指同一版本、同一输入下,测试结果会在通过与失败之间偶发变化。解决它不能靠反复点击重跑,而要把一次偶发失败转化为可观察、可复现、可分类的问题,再修复真正的共享状态、时间依赖、网络抖动或并发竞争。
学习目标
- 区分测试本身不稳定与外部环境偶发异常
- 建立从复现、分类到修复的排查顺序
- 用重复执行和日志证据验证修复是否真正生效
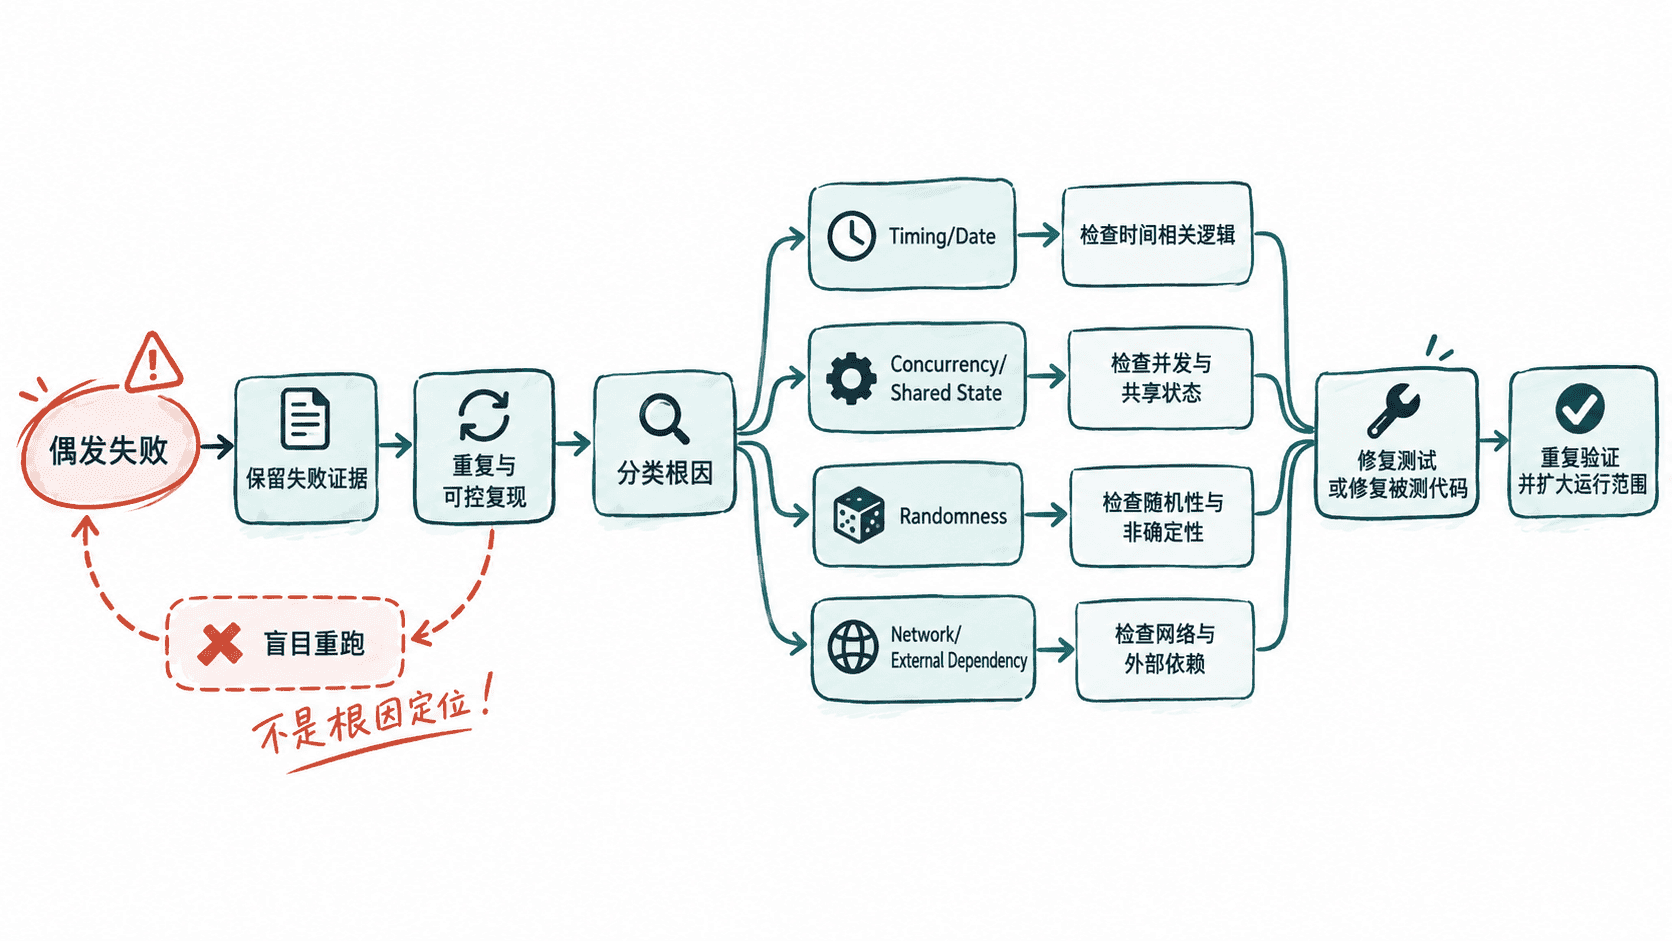
先保留失败证据
第一次失败时,不要马上修改测试或只记录一句“rerun passed”。先保存失败时的测试名称、提交版本、执行参数、线程数、环境变量、日志和相关时间戳。flaky 问题最大的损失不是失败本身,而是失败证据被重跑覆盖。
特别要注意失败是否集中在某个测试、某个执行模式或某类资源上。若同一个测试在并行模式下失败、串行模式下稳定通过,竞争条件的嫌疑会明显增加;若两个模式都失败,则应继续检查逻辑、外部依赖和时间假设。
把偶发问题变成可复现问题
第一次复现目标不是“百分之百失败”,而是提高失败信号。可以增加执行次数、固定随机种子、固定时区或切换单线程执行,然后比较结果。一次命令可以先快速跑固定次数。
cargo test flaky_case -- --exact --nocapture
cargo test flaky_case -- --exact --nocapture --test-threads=1
预期结果
running 1 test
test flaky_case ... ok
两次命令针对同一个测试,但第二次限制测试线程数。实际输出中的执行时间和测试结果会随代码与环境不同而变化;这里应关注的是测试是否只在并行模式下暴露问题。
若问题与概率有关,还可以在 CI 或本地连续运行测试。对于不依赖外部系统的纯逻辑测试,可以增加重复次数;对于依赖真实网络、时钟或共享服务的测试,则更应该先检查外部状态,而不是无限增加重跑次数。
按证据分类根因
时间相关问题常见于直接比较当前时间、依赖本地时区,或假定某个任务会在固定毫秒内完成。并发问题通常表现为固定执行顺序时通过、并行执行时失败,或错误信息指向资源已经被其他测试修改。
随机性问题则应检查随机种子是否固定、生成的测试数据是否真的可回放。外部依赖问题包括网络服务、共享文件系统和远端数据库,这类测试即使代码没有变化,也可能因为服务端状态变化而失败。
分类时不要只看最后一行断言。真正有价值的是“失败前发生了什么”。例如断言说“记录不存在”,但日志显示另一个测试在几十毫秒前删除了这条记录,那么断言只是症状,并不是根因。
修复应针对不稳定来源
发现竞争条件后,应拆分共享状态;发现时间依赖后,应注入可控时钟;发现随机性后,应保存并回放种子;发现外部网络依赖后,应优先使用稳定的测试替身或明确标记这类集成测试。
修复 flaky test 时不要简单增加 sleep。休眠只能改变时间窗口,通常无法证明状态真的已经准备好。更可靠的做法是等待明确的条件、使用同步原语,或者让被测代码提供可观察的完成信号。
例如下面这个测试用轮询检查条件,而不是猜测固定等待时间。它适合说明“等待状态”而非“等待时间”的原则;具体超时值应结合系统行为设置。
use std::time::{Duration, Instant};

fn wait_until_ready<F>(mut ready: F) -> bool
where
    F: FnMut() -> bool,
{
    let deadline = Instant::now() + Duration::from_secs(2);
    while Instant::now() < deadline {
        if ready() {
            return true;
        }
        std::thread::sleep(Duration::from_millis(10));
    }
    false
}

#[test]
fn waits_for_state_instead_of_fixed_delay() {
    let mut checks = 0;
    let ready = wait_until_ready(|| {
        checks += 1;
        checks >= 3
    });

    assert!(ready);
}
预期结果
running 1 test
test waits_for_state_instead_of_fixed_delay ... ok
这里的 sleep 只是轮询间隔,不承担“保证系统已经完成”的责任。真正的成功条件由 ready 决定,因此即使执行速度发生变化,测试仍然围绕状态而不是固定时长判断。
修复后要扩大验证范围
修复后不能只运行一次目标测试。至少应先连续运行目标测试,再运行相关模块,最后放回完整测试集。若问题只在并行环境暴露,还要保持默认线程数验证,不能只用串行模式证明修复成功。
一个实用的验收记录可以关注三个维度:目标测试连续执行是否稳定、并行与串行结果是否一致、CI 环境是否仍出现相同症状。若修复后仍有偶发失败,继续保留失败证据并重新分类,而不是把失败次数暂时压低就认为问题已经结束。
flaky test 的修复标准不是“今天重跑通过”,而是找到能够解释失败与恢复的机制,并让测试在不同执行顺序或合理环境波动下仍保持确定的行为。