
半导体与芯片 / 系统课时
用简化CPU框图追踪指令执行
用简化CPU框图追踪指令执行
一条加法指令进入 CPU 后,究竟由哪个部件读取、谁决定运算方式、结果又存到哪里?本课用一个包含 PC、指令寄存器、译码控制、寄存器堆和 ALU 的简化处理器,逐拍追踪一条指令,并检查每个阶段发生的状态变化。
学习目标
- 识别简化 CPU 的主要部件及其数据连接关系。
- 按取指、译码、执行、写回顺序追踪指令和数据。
- 使用具体寄存器数值,判断每个时钟边沿后哪些状态发生变化。
认识简化 CPU 的组成
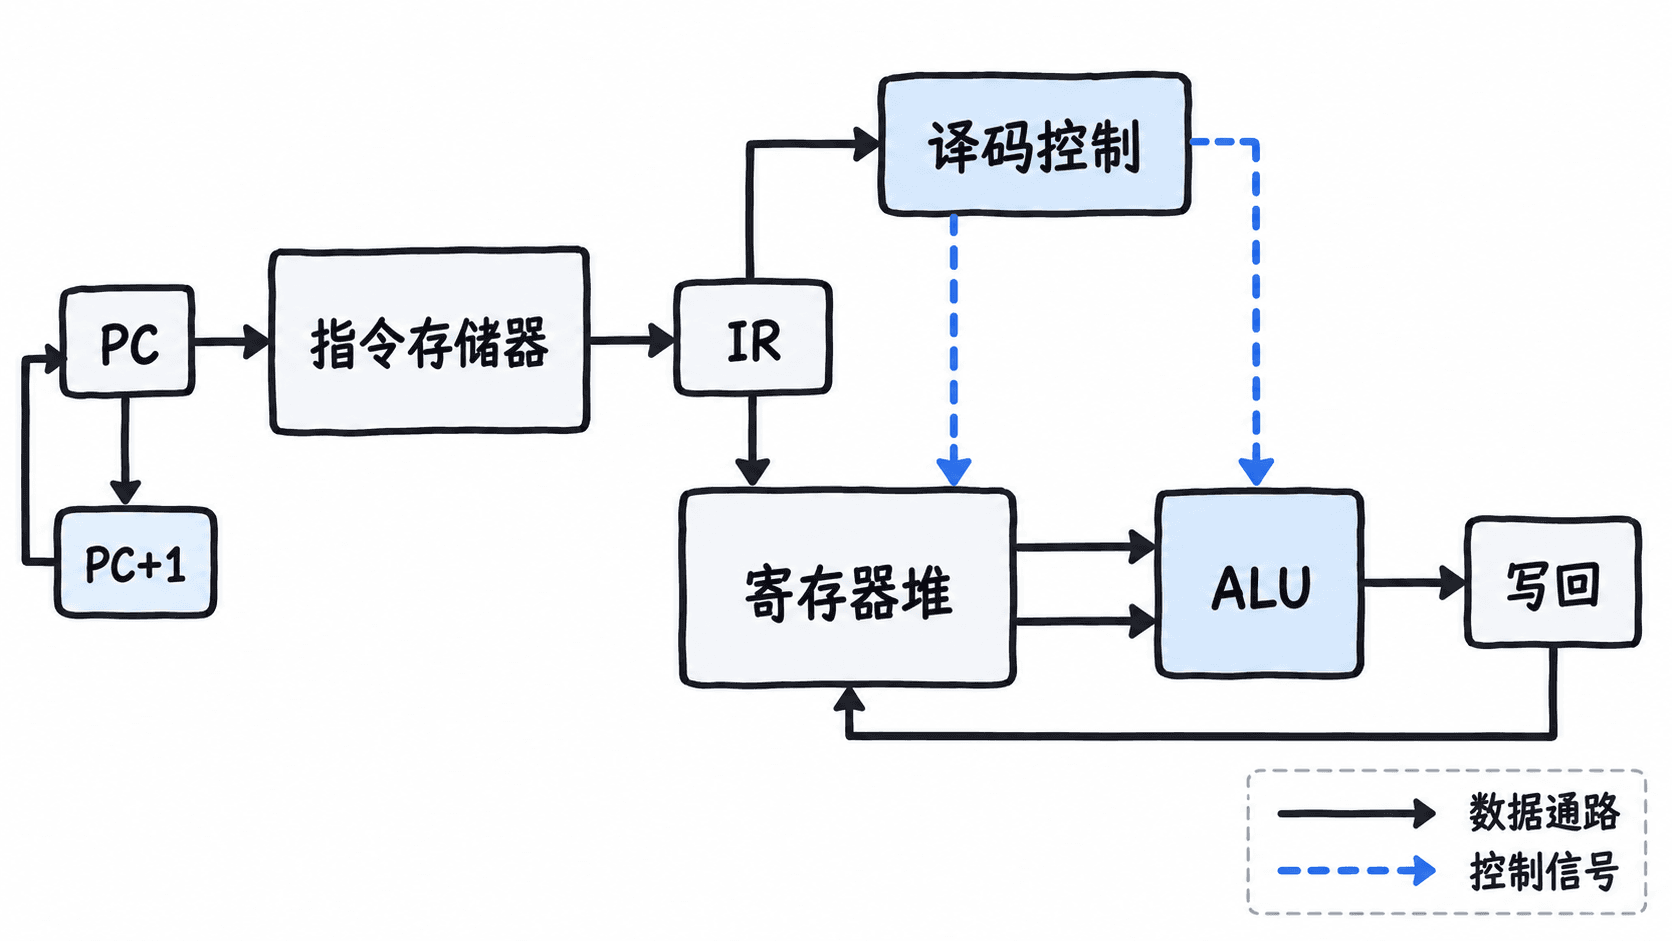
先考虑一个教学用的 16 位定长指令 CPU:每条指令占用一个 16 位存储单元,PC 保存指令存储单元的地址,顺序执行时 PC 加 1。这里的地址约定只用于本例,实际处理器可能按字节编址,指令长度也可能不同。
| 部件 | 保存或处理的内容 | 在本例中的作用 |
|---|---|---|
| PC(程序计数器) | 下一条待取指令的地址 | 初始值为 0x0010 |
| 指令存储器 | 地址到 16 位指令的映射 | 根据 PC 提供指令 |
| IR(指令寄存器) | 当前指令的 16 位编码 | 在取指结束时锁存指令 |
| 译码控制 | 操作码及控制信号 | 选择寄存器、ALU 操作和写回时机 |
| 寄存器堆 | R0~R7,每个寄存器 16 位 | 提供源操作数并接收结果 |
| ALU(算术逻辑单元) | 组合逻辑运算 | 完成 16 位加法 |
数据通路负责传输地址、指令和操作数,控制通路负责决定选择哪条路径以及何时写入状态。ALU 本身通常是组合逻辑,输入改变后经过传播延迟产生新结果;PC、IR 和通用寄存器才是本例按时钟边沿更新的状态单元。
定义要执行的加法指令
为了能够逐位检查,我们自定义一种教学指令格式。16 位指令分成四段,最高 4 位为操作码,其余字段各占 4 位;本例只使用寄存器编号 0~7。
| 位范围 | 含义 | 示例值 |
|---|---|---|
| 15~12 | opcode | 0001,表示 ADD |
| 11~8 | rd,目标寄存器 | 0011,表示 R3 |
| 7~4 | rs1,源寄存器 A | 0001,表示 R1 |
| 3~0 | rs2,源寄存器 B | 0010,表示 R2 |
整条指令为 0001 0011 0001 0010,十六进制表示为 0x1312,含义是 ADD R3, R1, R2,即把 R1 与 R2 相加并写入 R3。这是本课定义的示例编码,不是 x86、ARM 或 RISC-V 的真实机器码。
设定初始状态如下:
| 状态 | 初始值 |
|---|---|
| PC | 0x0010 |
| 指令存储器[0x0010] | 0x1312 |
| IR | 0x0000 |
| R1 | 7 |
| R2 | 5 |
| R3 | 99 |
预期最终状态是 R3 从 99 变成 12,PC 从 0x0010 变成 0x0011,而 R1、R2 不变。假设 16 位加法按模 65536 处理,暂不考虑标志位、异常、中断与存储器等待周期。
按时钟追踪取指到写回
这里采用非流水线、多周期 CPU:一个阶段占用一个时钟周期,寄存器在时钟上升沿锁存新值。为方便观察,把译码和执行分别安排在独立周期;实际 CPU 的阶段划分可能不同。
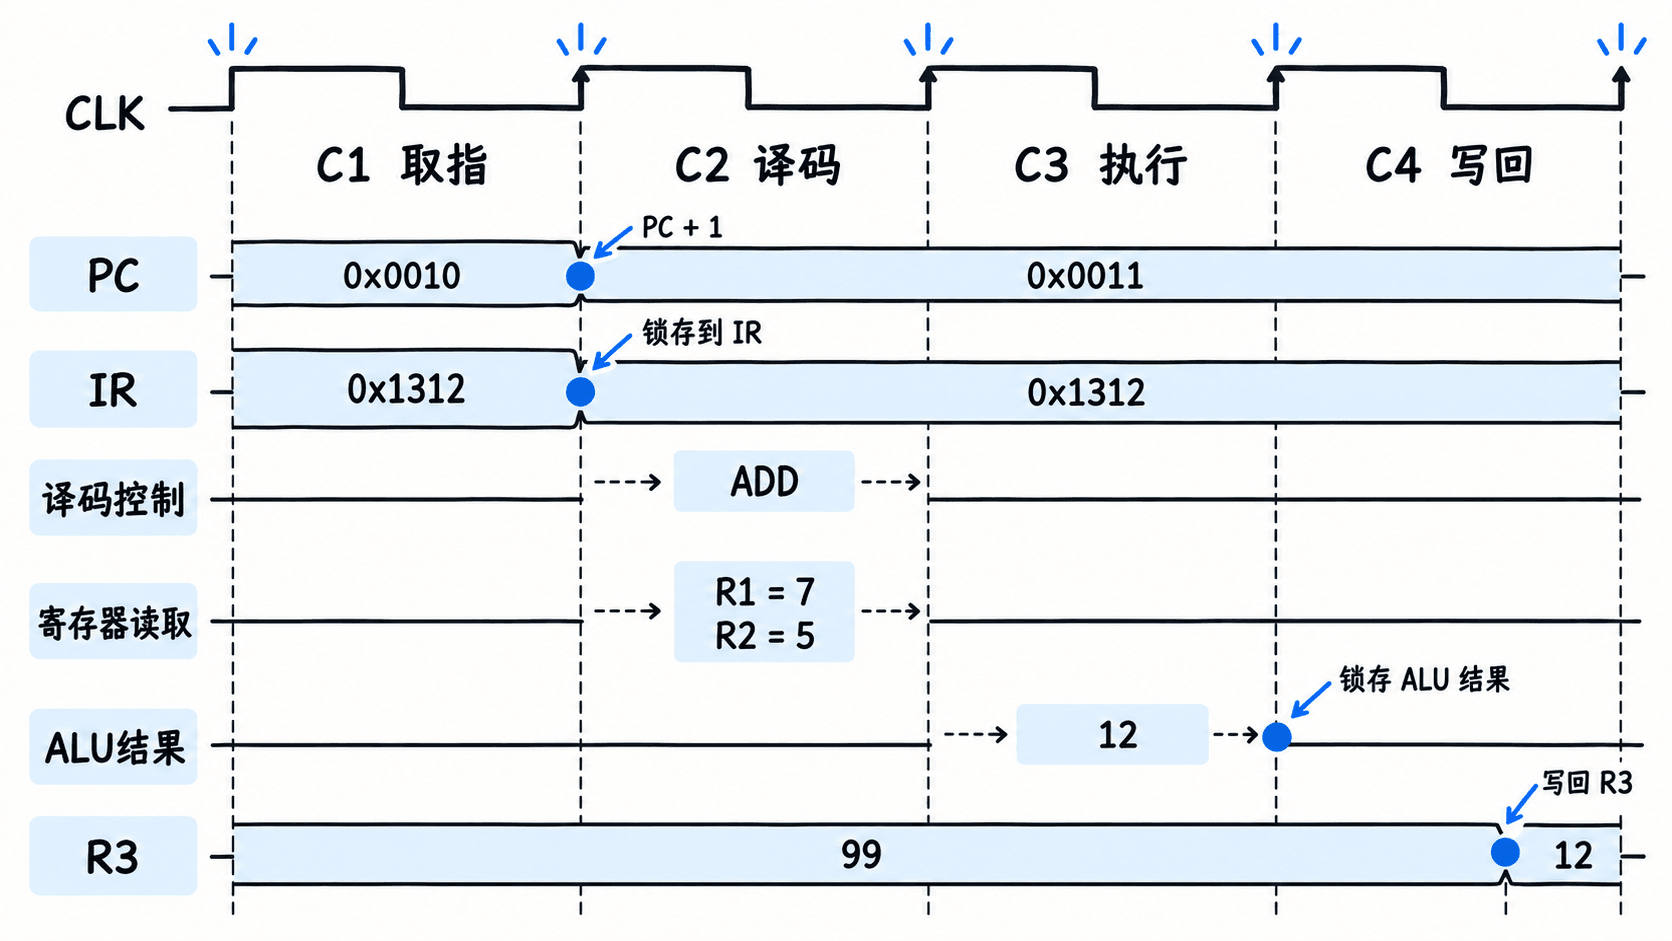
- 取指 C1:PC 输出地址 0x0010,指令存储器读出 0x1312;在 C1 结束的上升沿,IR 锁存 0x1312,PC 同时更新为 0x0011。由于两者使用边沿前的旧值,IR 取得的仍然是地址 0x0010 对应的指令。
- 译码 C2:控制逻辑识别 opcode=0001,选择 ADD 操作,指定读取 R1 和 R2,目标为 R3。读端口提供数值 7、5。本例此周期不写通用寄存器。
- 执行 C3:ALU 接收 7 和 5,产生 12。在 C3 结束时将结果 12 锁存进教学模型的 ALU 结果暂存寄存器,保证下一周期写回的数据不受输入变化影响。
- 写回 C4:控制逻辑使能寄存器堆写端口,写地址为 R3,写数据为 12。在 C4 结束的上升沿,R3 更新为 12,指令完成。
其中译码控制并非必然需要独立的状态寄存器。本例假设 IR 和寄存器堆在相关周期保持稳定,控制逻辑可由 IR 组合产生控制信号;额外的 ALU 结果暂存寄存器用于保存跨周期的数据。
检查每个阶段的状态变化
区分组合逻辑的即时输出和时序逻辑保存的值,可以避免把“ALU 已算出 12”误认为“R3 已经等于 12”。
| 时间点 | PC | IR | ALU结果暂存 | R3 |
|---|---|---|---|---|
| 初始 | 0x0010 | 0x0000 | 未定义 | 99 |
| C1 末 | 0x0011 | 0x1312 | 未定义 | 99 |
| C2 末 | 0x0011 | 0x1312 | 未定义 | 99 |
| C3 末 | 0x0011 | 0x1312 | 12 | 99 |
| C4 末 | 0x0011 | 0x1312 | 12 | 12 |
这是单条指令的观察窗口。在下一条指令开始取指前,PC 已指向 0x0011;下一次取指才会用该地址读取指令,并在对应时钟边沿更新 IR。不能把 PC 指向下一条指令等同于下一条已经执行。
检查时重点核对三个条件:取指结束 IR 是否为 0x1312;执行结束暂存结果是否为 12;写回之前 R3 是否一直保持 99。如果 C3 末 R3 就变成 12,说明实现的是提前写回或不同的时序设计,不能再套用本例四周期状态表。
遇到分支或数据相关时怎样思考
顺序 ADD 指令的 PC 更新很简单,但分支指令可能根据比较条件选择跳转目标。以相同的按指令单元编址约定为例,若当前 PC 为 0x0010,分支目标为 0x0020,并且分支条件成立,那么 PC 最终应指向 0x0020,而不是继续按顺序使用 0x0011。具体哪个周期改写 PC 由微架构决定,本例不把它混入 ADD 的执行时序。
再考虑连续两条指令:第一条 ADD R3, R1, R2 产生 12,第二条读取 R3。当前非流水线设计在第一条 C4 写回后才执行下一条,因此第二条能读到 12。若改成流水线,两条指令可能重叠运行,就必须检查读取时间与写回时间,并按需要设置暂停或数据前递。
一个有效的自测是把初始 R1 改为 65535、R2 改为 2。若本例使用 16 位无符号结果并丢弃最高进位,R3 应写入 1;PC 仍只前进一个指令地址单位。只需重新计算 ALU 结果与写回值,便能检查是否真正区分了指令地址、运算数据和寄存器状态。