
半导体与芯片 / 系统课时
从加法器追踪算术数据处理路径
从加法器追踪算术数据处理路径
当处理器执行一次二进制加法时,数据要经过逻辑门产生和位、逐级处理进位,最后形成运算结果。本篇从半加器和全加器出发,追踪一次 4 位加法的完整路径,理解进位传播为何限制速度,以及算术逻辑单元如何组织运算。
学习目标
- 理解半加器、全加器的输入输出及逻辑关系。
- 能手工追踪 4 位二进制加法中的和位与进位。
- 解释进位传播延迟,并识别 ALU 中的数据选择和结果输出路径。
半加器如何计算一个二进制位
半加器(Half Adder)接收两个 1 位输入 A、B,产生和位 S 与进位 C。它不接收来自低位的进位,因此适合解释加法的基础逻辑。
| A | B | 和位 S | 进位 C |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 1 | 0 |
| 1 | 0 | 1 | 0 |
| 1 | 1 | 0 | 1 |
对应的布尔表达式为:
- 和位:,使用异或(XOR)运算。
- 进位:,使用与(AND)运算。
例如 A=1、B=1 时,十进制计算得到 2,对应二进制 10。因此当前位输出 S=0,向更高位输出 C=1,而不是在一个输出位里存放数字 2。
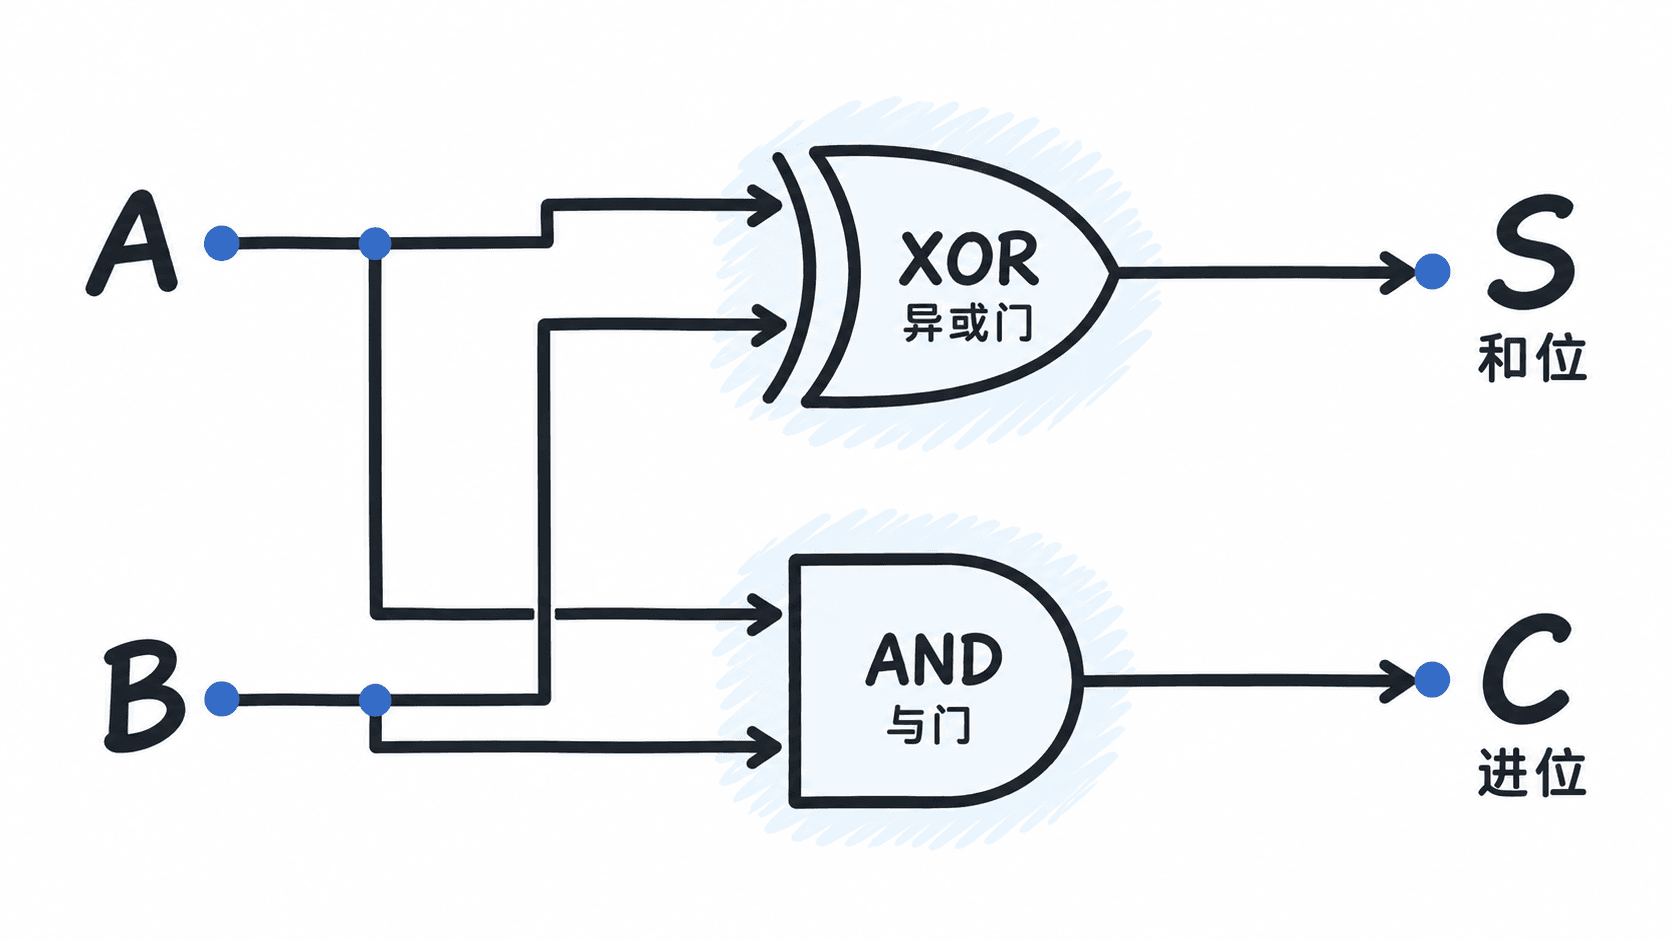
半加器的局限是没有进位输入。例如计算某一位上的 1+0+1,第三个 1 是低位传来的进位,此时必须使用全加器。
全加器怎样接收低位进位
全加器(Full Adder)具有三个输入:当前位 A、B,以及低位进位 Cin;输出是和位 S 与高位进位 Cout。
其逻辑关系为:
可以把全加器理解为两个半加器与一个或门的组合:
- 第一个半加器计算 A、B,得到中间和 P,以及进位 G。
- 第二个半加器计算 P、Cin,得到最终和位 S,以及另一个进位 T。
- 将 G、T 通过或门合并,得到 Cout。
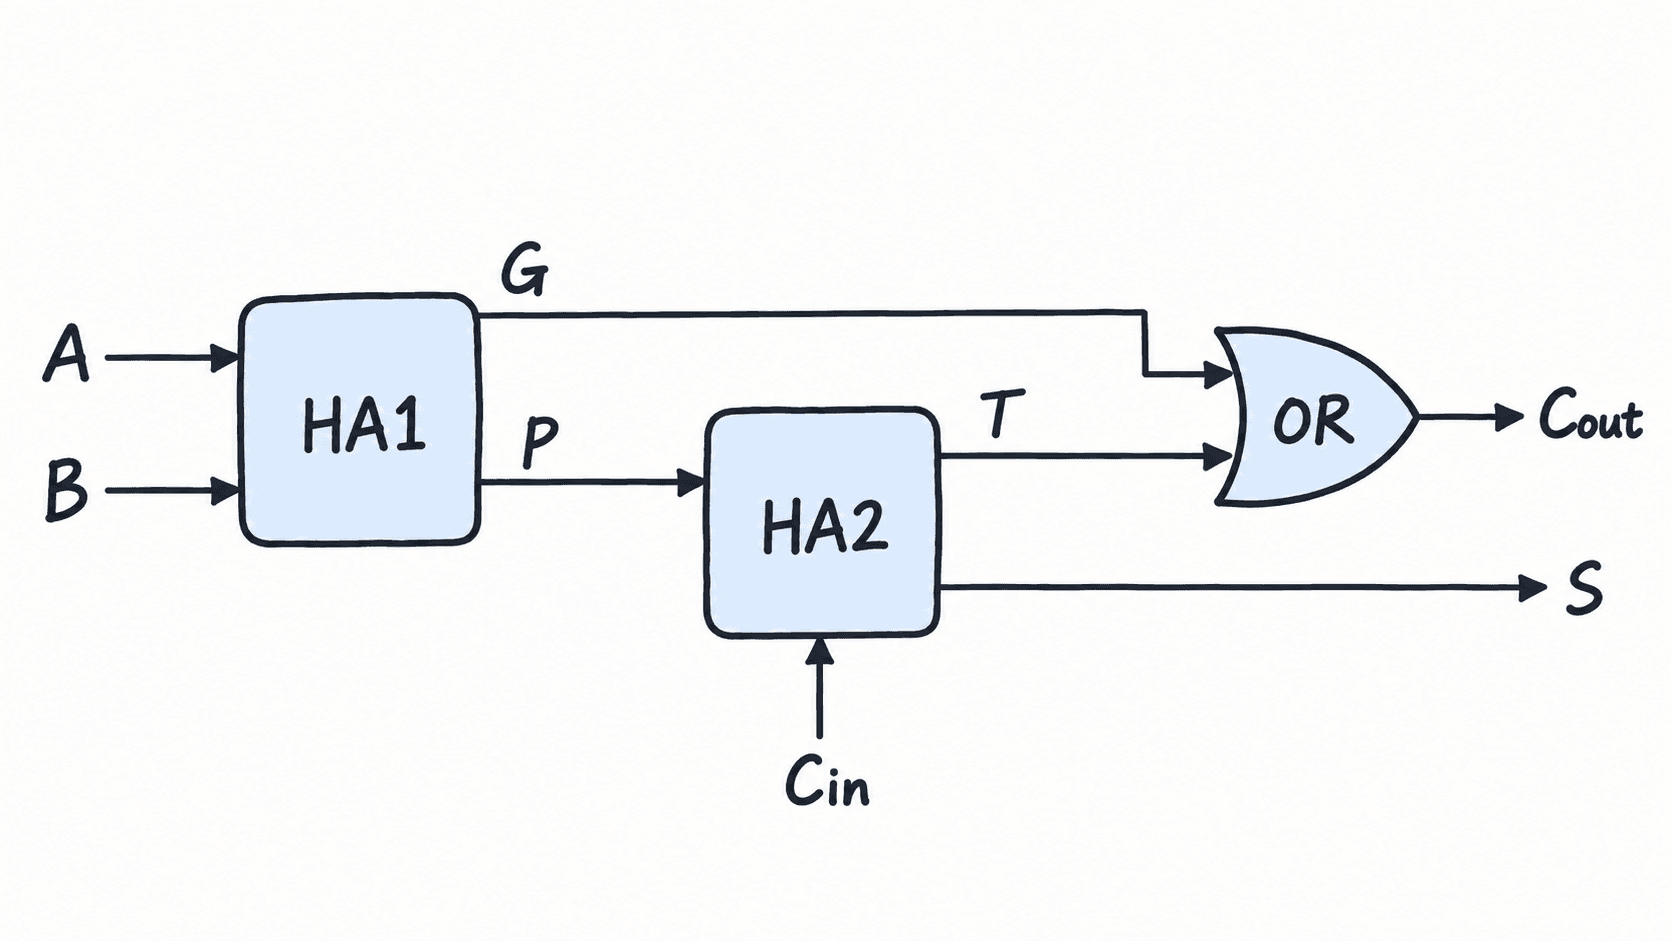
以 A=1、B=0、Cin=1 为例:先计算 P=1、G=0,再计算 S=0、T=1,最终 Cout=1。输出 Cout S 为二进制 10,正好等于十进制 2。
实际硬件可以使用优化后的门级网络实现同一布尔函数,不一定真的实例化两个独立半加器。
追踪一次四位二进制加法
多位加法器可以由若干全加器串联构成。最低位的 Cin 通常设为 0;每一级的 Cout 连接到相邻高位的 Cin,这种结构称为行波进位加法器(Ripple-Carry Adder)。
以无符号 4 位整数 1011 与 0110 相加为例,分别对应十进制 11 和 6。
按最低有效位 bit0 到最高有效位 bit3 计算:
| 位 | A | B | Cin | S | Cout |
|---|---|---|---|---|---|
| bit0 | 1 | 0 | 0 | 1 | 0 |
| bit1 | 1 | 1 | 0 | 0 | 1 |
| bit2 | 0 | 1 | 1 | 0 | 1 |
| bit3 | 1 | 0 | 1 | 0 | 1 |
按照 bit3 到 bit0 的顺序排列和位,得到 0001,最高位还产生 Cout=1。完整的 5 位结果为 10001,即十进制 17。
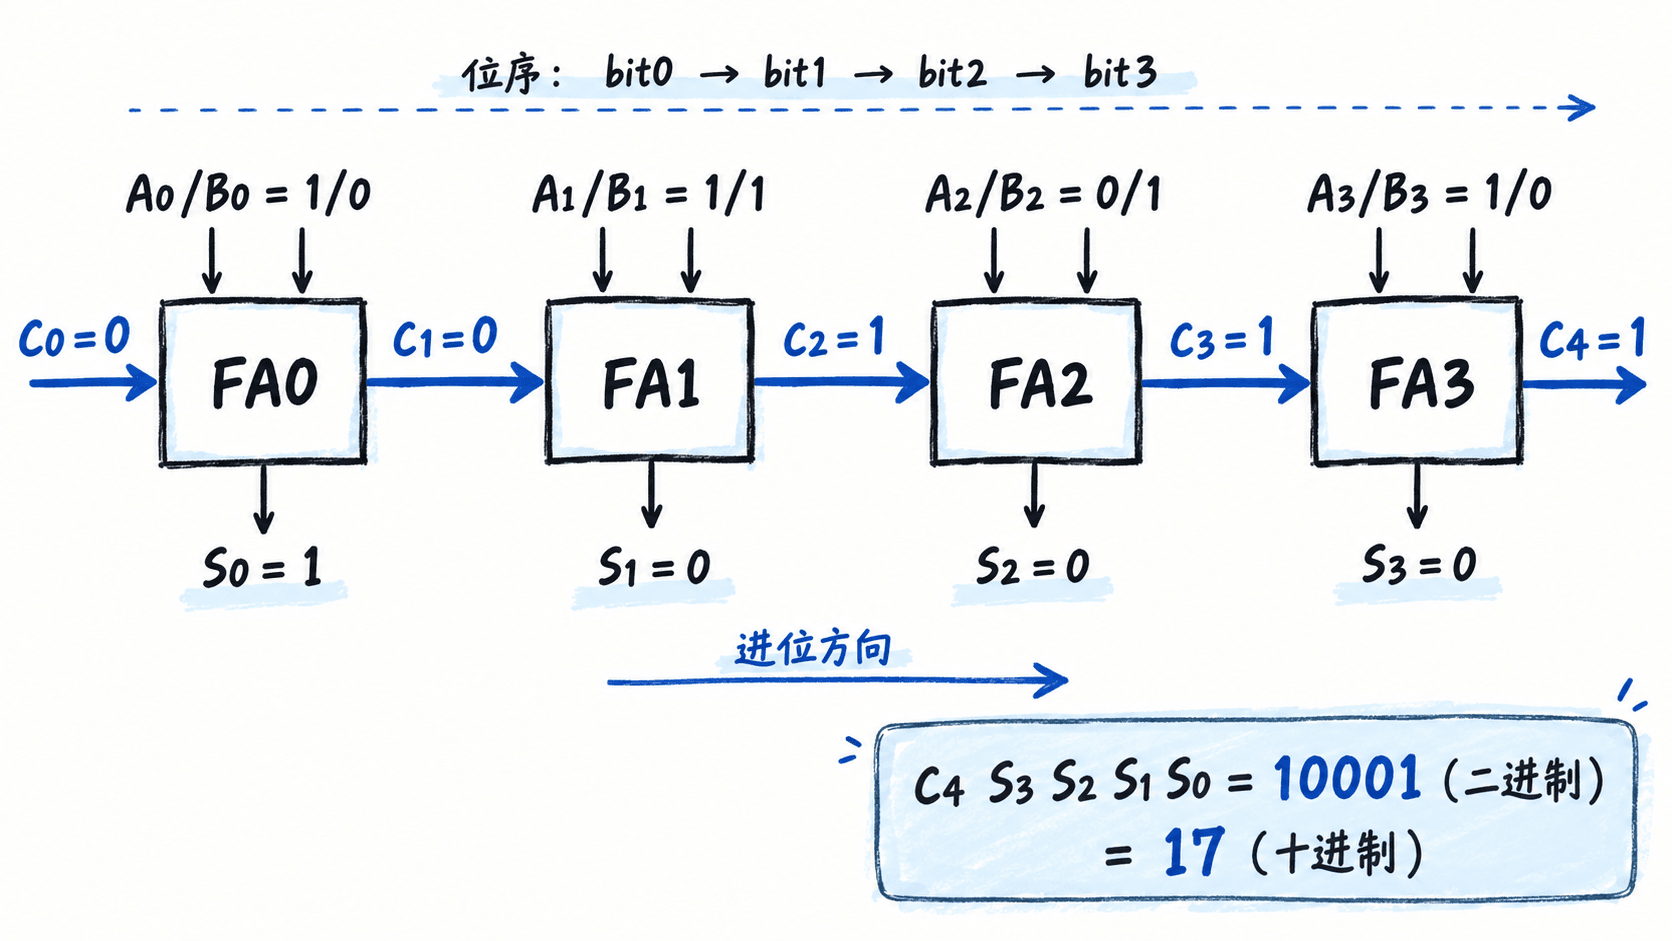
注意:如果只保留 4 位结果寄存器,写入的是 0001;最高进位需要另行保存或通过状态标志反映。不能把丢弃最高进位后的 0001 误认为完整的数学结果。
对 4 位有符号二进制补码来说,1011 代表 -5,0110 代表 6,相加后的 0001 代表 1,且没有有符号溢出。最高进位 Cout=1 并不等价于有符号溢出;两者必须分开判断。
进位传播为何决定运算延迟
组合逻辑加法器不需要等待时钟才逐位计算,但信号经过逻辑门需要传播时间。对于行波进位结构,高位输出依赖低位进位,因此最坏情况下存在逐级等待。
例如计算 0111+0001,最低位首先产生进位,随后进位依次影响 bit1、bit2、bit3,最终形成 1000。每一级都需要等待前一级的进位稳定。
假设采用一个简化时序模型:每一级的进位传播延迟为 0.20 ns,最高位最终和位还需要 0.10 ns。若四级进位全部串行传播,最高 Cout 的估算延迟为:
若最高和位需要经过前三级进位传播以及最后一级的和位逻辑,则估算为 0.70 ns。这些数值仅用于演示,不代表某种工艺或芯片的真实规格;实际时序取决于逻辑门实现、负载、布线与工艺条件。
对于 N 位行波进位加法器,最坏进位链延迟通常随 N 近似线性增长,即 。
改进方向之一是超前进位(Carry Lookahead),先为每一位计算:
- 进位生成信号:。
- 进位传播信号:。
- 进位关系:。
例如第二位的进位可展开为 ,从而减少对逐级串行计算的依赖。具体延迟改善取决于超前进位网络的层级、扇入和实际电路实现,不能简单理解为加法没有传播延迟。
算术逻辑单元如何组织数据路径
算术逻辑单元(ALU)通常不仅执行加法,还执行按位 AND、OR、XOR 等运算。组合逻辑的输入由寄存器或其他电路提供,运算控制信号决定最终选择哪个结果。
以一个简化的 4 位 ALU 为例,定义控制信号 op:
| op | 运算 | A=1011、B=0110 时的 4 位结果 |
|---|---|---|
| 00 | A+B | 0001 |
| 01 | A AND B | 0010 |
| 10 | A OR B | 1111 |
| 11 | A XOR B | 1101 |
这里的 op 编码仅是教学示例,不代表某种 CPU 的指令编码。加法分支还可以提供独立的进位输出,其余逻辑运算不应直接沿用加法进位作为有效结果。
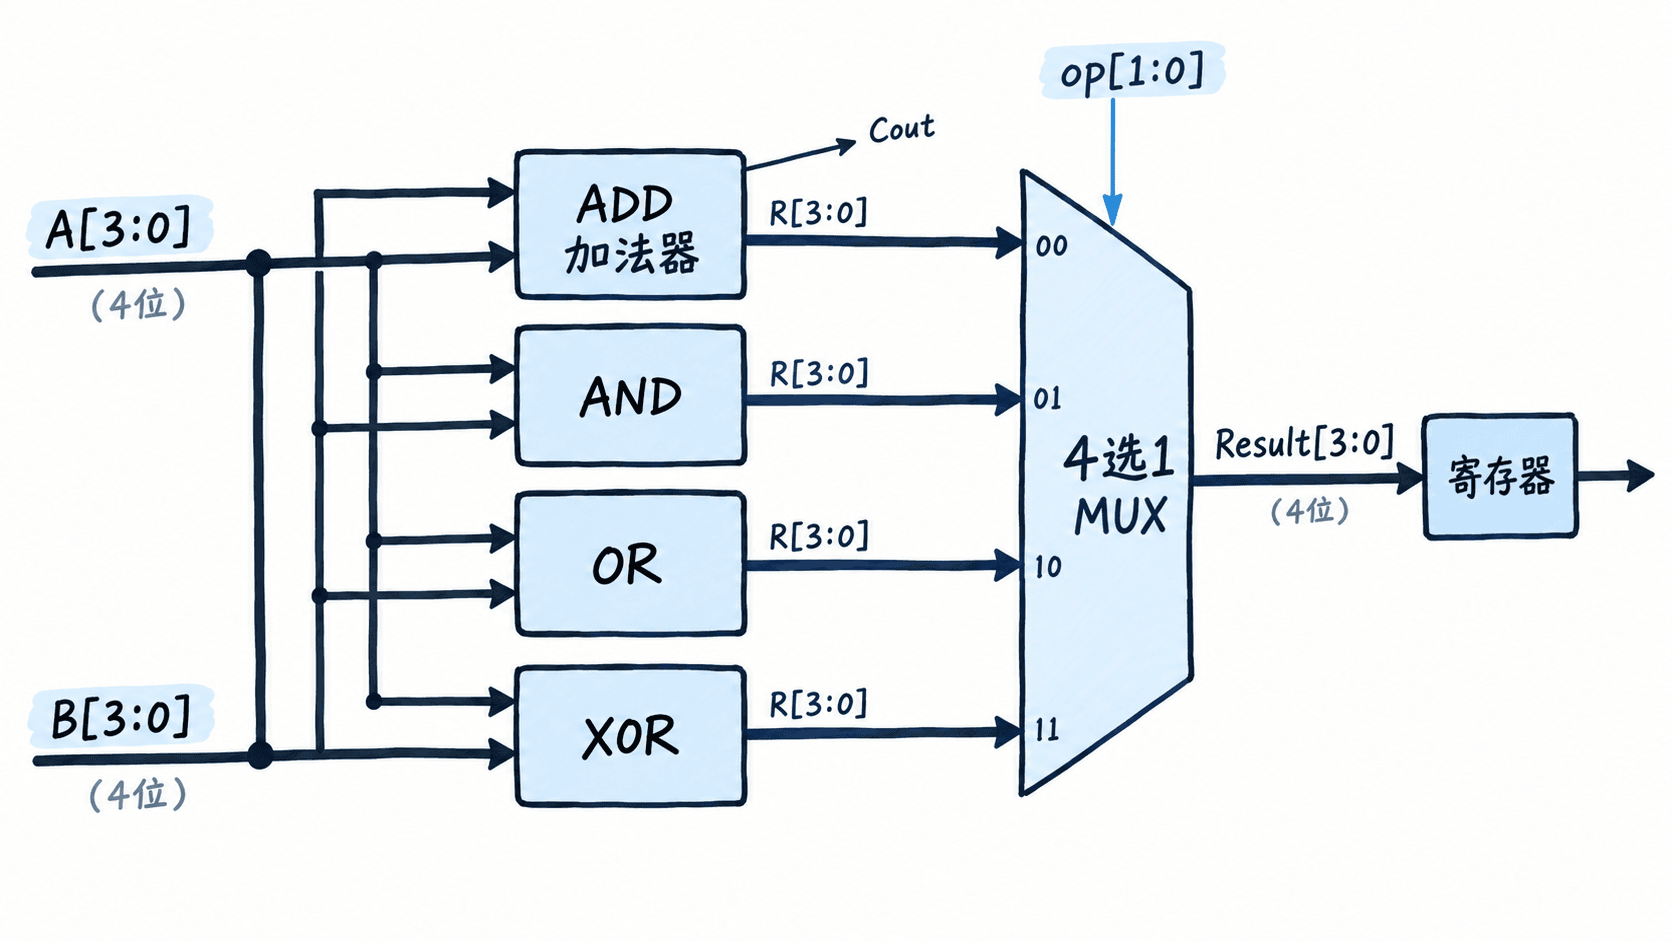
在同步数字系统中,典型的数据处理过程是:
- 时钟有效沿使源寄存器更新或保持已存数据。
- 寄存器输出经过 ALU 的组合逻辑,经过传播延迟后形成稳定结果。
- 控制逻辑选择目标寄存器是否在下一有效时钟沿采样该结果。
- 目标寄存器满足建立时间与保持时间要求时,才能可靠保存计算值。
因此,时钟周期不仅需要容纳 ALU 延迟,还需要考虑源寄存器的时钟到输出延迟、线路延迟以及目标寄存器的建立时间等因素。若忽略时钟偏斜等附加项,一个基本的建立时间约束为:
例如源寄存器时钟到输出延迟 0.10 ns,组合数据路径延迟 0.80 ns,目标寄存器建立时间 0.10 ns,则理想化的最小时钟周期为 1.00 ns。实际设计还必须计入布线、时钟偏斜与时序裕量。
用可检查的算例验证理解
给定两个无符号 4 位输入 A=1111、B=0001,初始 Cin=0,按全加器规则逐位计算,可得到:
| 位 | A | B | Cin | S | Cout |
|---|---|---|---|---|---|
| bit0 | 1 | 1 | 0 | 0 | 1 |
| bit1 | 1 | 0 | 1 | 0 | 1 |
| bit2 | 1 | 0 | 1 | 0 | 1 |
| bit3 | 1 | 0 | 1 | 0 | 1 |
完整无符号结果为 10000,即十进制 16;如果目标只保存低 4 位,结果为 0000,并产生最高进位 Cout=1。
可以再检查两个问题:
- 将 B 改为 0000,进位链不再由本次加法产生,4 位结果应为 1111,Cout=0。
- 将同一组输入 1111、0001 解释为有符号补码,分别表示 -1 和 1,结果为 0,不发生有符号溢出,即使 Cout=1。
能够同时写出每一级 Cin、S、Cout,并区分低 4 位结果、最高进位和有符号溢出,就能完整追踪这类基础算术数据路径。行波进位加法器适合建立直观模型;当位宽增加且时钟周期受限时,再评估超前进位或其他更快的加法器结构。