
Java 后端 / 系统课时
规划读写分离方案
规划读写分离方案
本节解决数据库读请求压力过高的问题。通过读写分离将写入流量集中到主库,将查询流量分配到只读副本,并明确一致性、路由和验证边界。
学习目标
- 理解读写分离架构中的主库、副本和请求流向
- 掌握应用层实现读写路由的基本方式
- 识别复制延迟带来的数据一致性风险
读写分离的基本模型
读写分离通常由一个主库和多个只读副本组成。主库负责 INSERT、UPDATE、DELETE 等写操作,并通过复制机制同步数据;查询请求根据业务规则路由到副本。
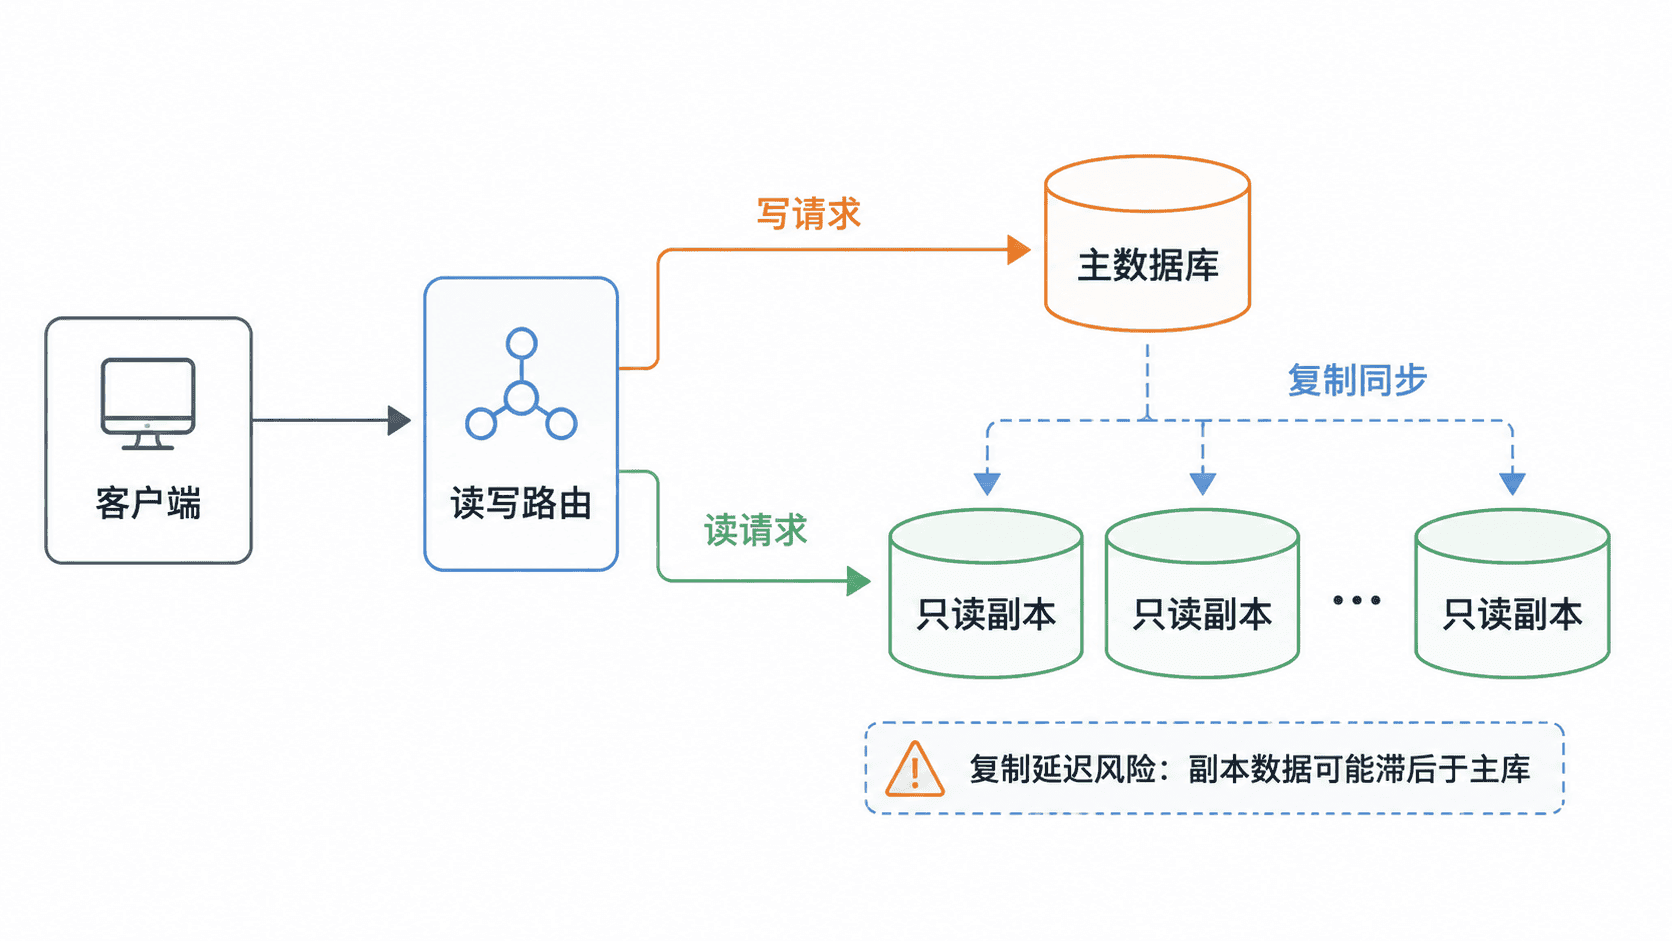
读写分离不是简单增加数据库节点,而是需要根据业务场景判断哪些查询允许读取延迟数据,哪些请求必须保证立即读取最新状态。
设计应用层读写路由
应用通常在数据访问层完成读写分离。写操作固定访问主库,普通查询访问副本,涉及强一致要求的查询则根据业务策略回退到主库。
java
public class UserService {
    private final UserRepository masterRepository;
    private final UserRepository replicaRepository;

    public User findUser(long id) {
        // 普通查询使用只读副本
        return replicaRepository.findById(id);
    }

    public void updateUser(User user) {
        // 修改操作必须进入主库
        masterRepository.update(user);
    }
}
预期输出
text
查询请求调用 replicaRepository。
更新请求调用 masterRepository。
生产环境通常会结合数据库中间件、连接池路由或框架多数据源能力实现,避免在每个业务方法中手动判断数据库节点。
处理复制延迟问题
读写分离最大的风险是主从复制存在延迟。刚提交的数据可能还未同步到副本,如果立即读取副本,用户可能看到旧数据。
常见处理方式包括:
- 写入后的短时间窗口内强制读取主库
- 关键查询携带一致性要求并选择主库
- 根据副本延迟动态调整路由策略
验证复制状态和方案效果
评估读写分离效果时,需要同时关注连接数、主库压力、副本延迟和接口响应时间。下面示例适用于 PostgreSQL 流复制环境,用于查看副本回放延迟;非流复制环境或其他复制方案需要使用对应监控指标替代。
sql
SELECT now() - pg_last_xact_replay_timestamp() AS replication_delay;预期结果
text
 replication_delay
------------------
 <TIME>
如果 PostgreSQL 实例未启用支持该函数的物理流复制架构,该查询可能不可用,不能直接作为所有数据库复制延迟检测方案。生产环境还需要配合复制状态监控、故障切换和容量规划,避免副本异常时全部查询回流主库。
按自己的节奏,确认真正理解。