
Java 后端 / 系统课时
处理N+1查询问题
处理N+1查询问题
本篇解决 Java 数据访问层中关联查询导致的 N+1 查询问题,帮助开发者识别隐性数据库访问次数增长,并通过批量查询或连接查询减少无效数据库交互。
学习目标
- 理解 N+1 查询产生的原因和性能影响
- 掌握批量查询与 JOIN 查询的优化方式
- 能够通过 SQL 日志和链路信息定位重复查询问题
认识 N+1 查询的形成原因
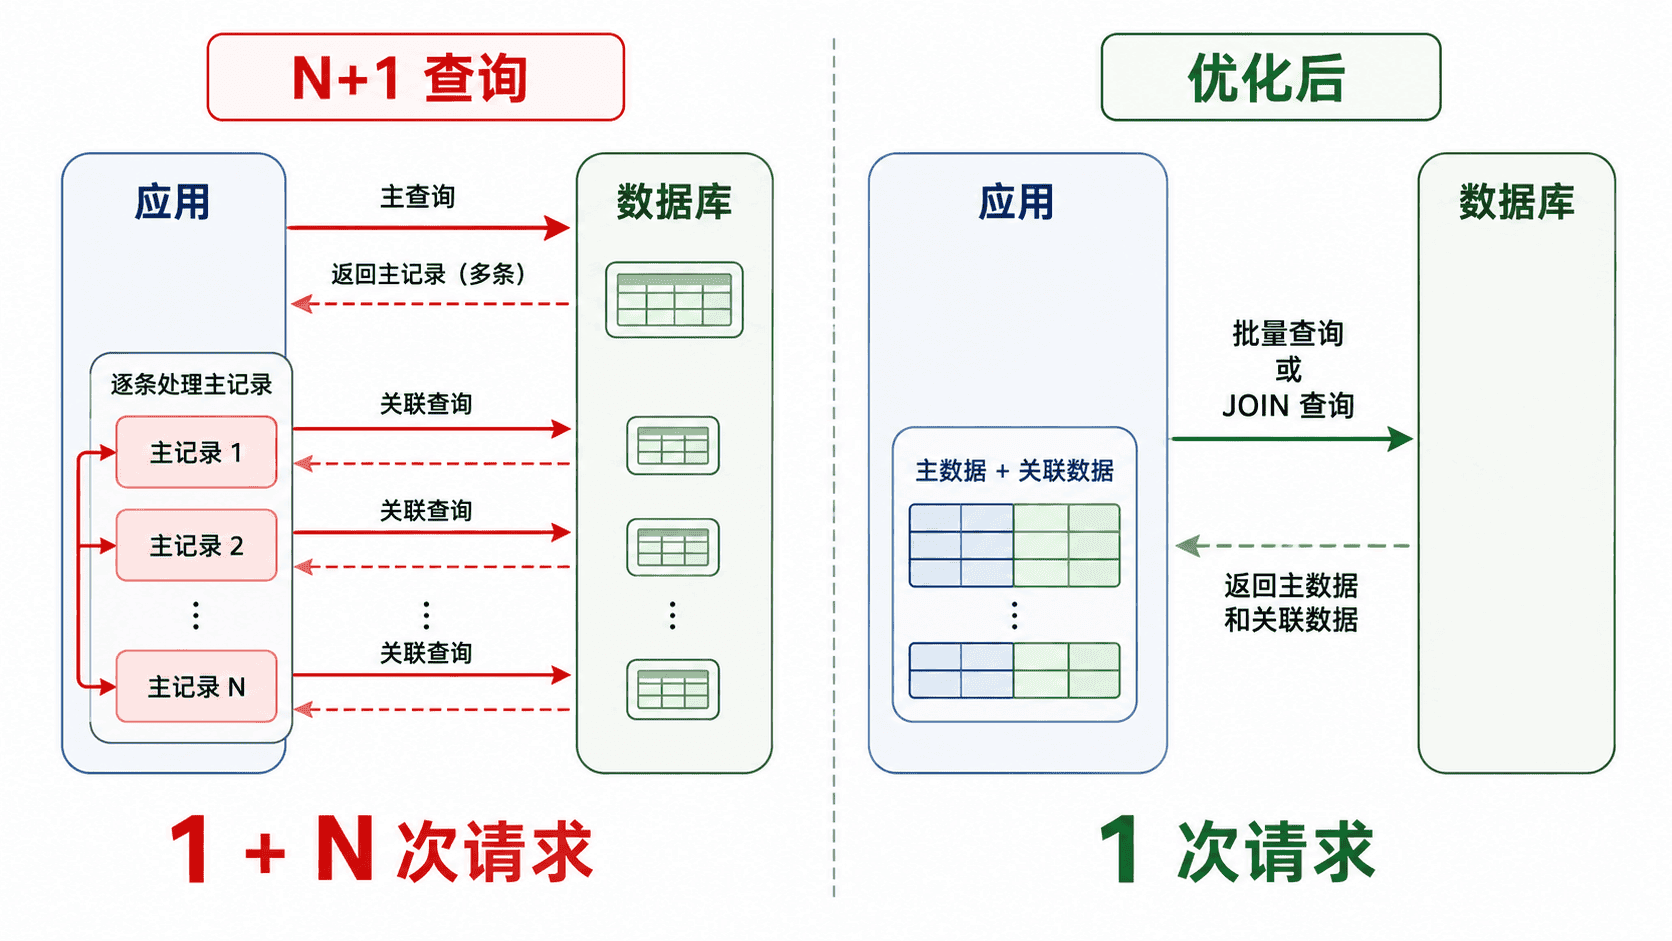
N+1 查询通常发生在查询一批主数据后,再循环访问关联数据。例如查询 100 个订单时,先执行 1 次订单查询,然后每个订单再次查询用户信息,最终产生 101 次数据库请求。
问题的核心不是某一条 SQL 慢,而是应用层访问模式让数据库交互次数随着数据量增长。额外的连接建立、网络传输和 SQL 执行都会增加接口耗时。
使用批量查询解决关联访问
当业务需要返回主对象和关联对象时,可以先收集所有关联 ID,再使用一次批量查询获取数据,最后在内存中完成对象关联。这种方式适合需要复杂业务处理的场景。
下面示例展示订单查询用户信息时,如何避免循环查询数据库。
java
import java.util.List;
import java.util.Map;
import java.util.function.Function;
import java.util.stream.Collectors;

class OrderService {
    private final OrderRepository orderRepository;
    private final UserRepository userRepository;

    List<OrderDTO> queryOrders() {
        List<Order> orders = orderRepository.findAll();
        List<Long> userIds = orders.stream()
                .map(Order::getUserId)
                .toList();

        // 一次批量查询全部用户,避免循环访问数据库
        Map<Long, User> users = userRepository.findByIds(userIds)
                .stream()
                .collect(Collectors.toMap(User::getId, Function.identity()));

        return orders.stream()
                .map(order -> new OrderDTO(order, users.get(order.getUserId())))
                .toList();
    }
}
预期输出
text
查询订单 SQL 执行 1 次
查询用户 SQL 执行 1 次
接口返回订单列表及对应用户信息
数据库交互次数: 2
批量查询减少了数据库访问次数,但需要注意一次加载的数据规模。如果关联数据量过大,应结合分页、分批加载等方式控制内存占用。
使用 JOIN 查询优化读取场景
如果关联数据主要用于展示,且关联关系稳定,可以直接通过数据库 JOIN 完成关联查询,减少应用层对象拼装成本。
sql
SELECT
    o.id AS order_id,
    o.amount,
    u.id AS user_id,
    u.name AS user_name
FROM orders o
JOIN users u ON o.user_id = u.id
WHERE o.status = 'PAID';
预期输出
text
order_id | amount | user_id | user_name
1001     | 88.00  | 20      | Alice
1002     | 120.00 | 21      | Bob
JOIN 适合数据库完成关联读取的场景,批量查询更适合需要复杂业务加工的场景。实际选择需要结合分页方式、返回字段数量和数据规模判断。
排查 N+1 查询的方法
生产环境可以通过 SQL 日志、APM 链路追踪和数据库监控定位 N+1 问题。如果发现一个接口执行大量结构相同、仅参数不同的 SQL,需要重点检查循环中的数据访问逻辑。
使用 ORM 框架时,还需要关注懒加载策略。隐藏触发的关联查询可能在业务代码之外发生,因此应结合实际 SQL 执行记录验证优化效果。
按自己的节奏,确认真正理解。