
Java 后端 / 系统课时
使用缓存降低数据库压力
使用缓存降低数据库压力
本节解决高并发读取场景下数据库压力过大的问题,通过缓存减少重复查询,并掌握缓存读取、回填以及一致性处理方法。
学习目标
- 理解缓存降低数据库压力的基本机制
- 掌握 Java 服务中缓存读取与回填流程
- 能够根据业务一致性要求选择缓存策略
认识缓存解决的问题
数据库查询通常需要经过连接获取、SQL 执行、索引访问和结果返回等过程。当大量请求重复读取相同数据时,数据库会持续消耗 CPU、磁盘和连接资源。
缓存通过保存访问频率较高的数据,让后续请求优先读取缓存。典型流程是先查询缓存,命中后直接返回;未命中时查询数据库,再将结果写入缓存供后续请求使用。
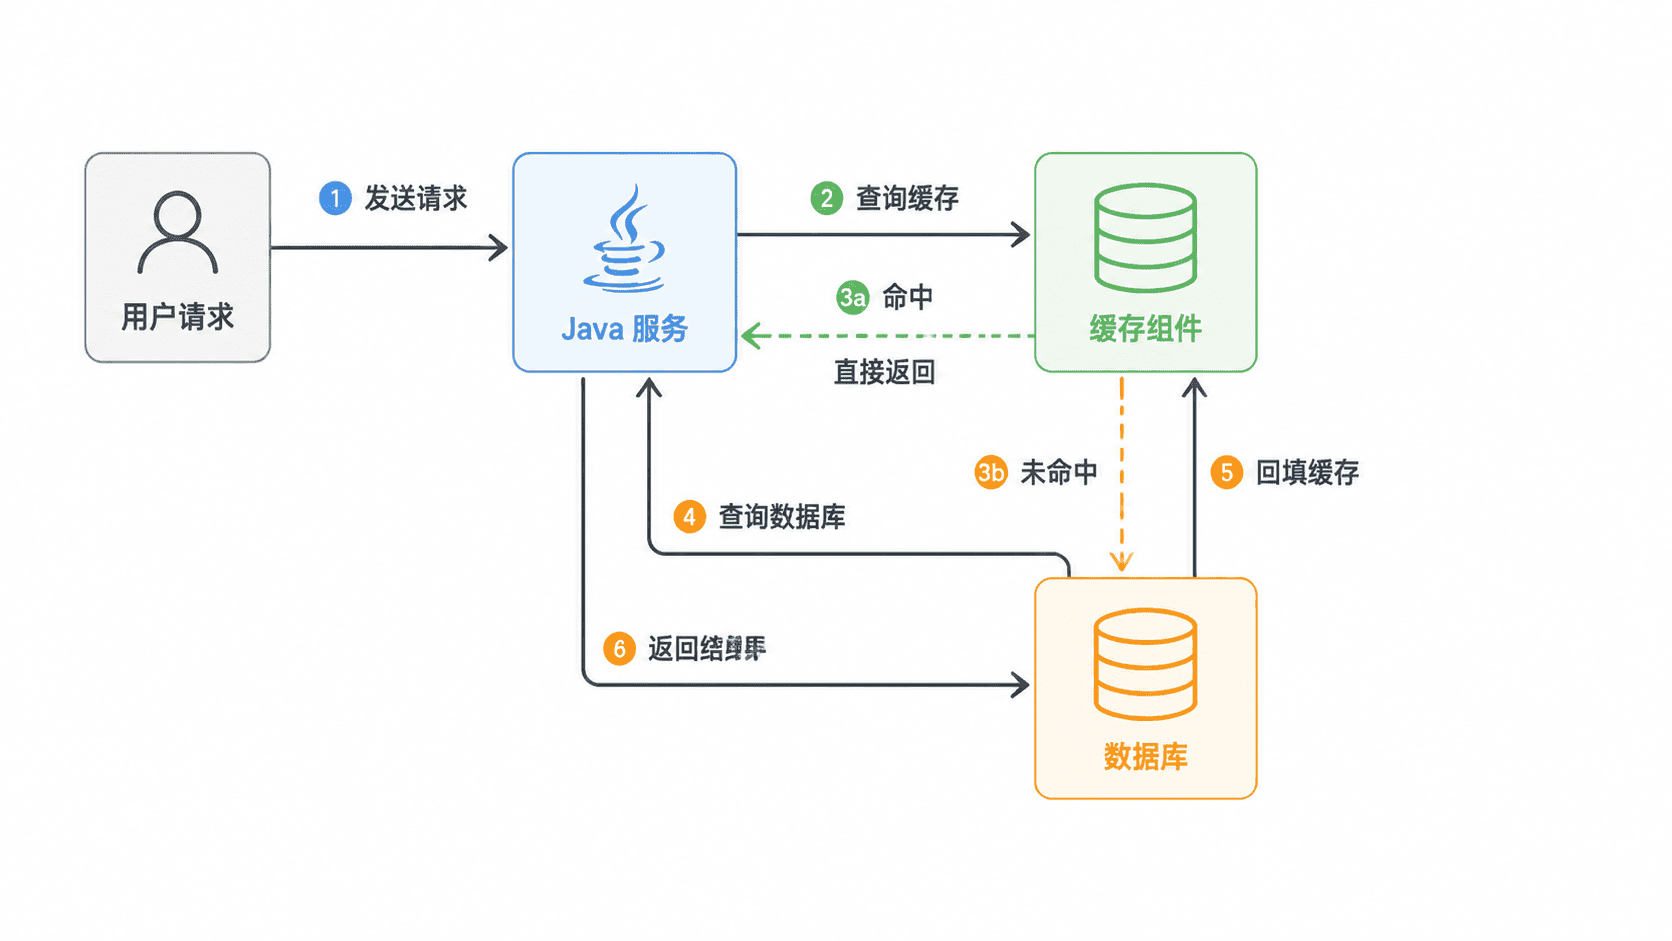
实现缓存读取与回填
在 Java 应用中,缓存通常位于业务服务和数据库之间。下面使用本地 Map 模拟缓存访问过程,实际项目可以替换为 Redis 等分布式缓存组件。
java
import java.util.Map;
import java.util.concurrent.ConcurrentHashMap;

public class UserService {
    private final Map<Long, String> cache = new ConcurrentHashMap<>();

    public String findUser(Long id) {
        String cached = cache.get(id);
        if (cached != null) {
            return cached;
        }

        String user = queryDatabase(id);
        cache.put(id, user);
        return user;
    }

    private String queryDatabase(Long id) {
        return "user-" + id;
    }
}
预期输出
text
第一次查询:访问数据库并写入缓存
第二次查询:直接返回缓存中的 user-<ID>
生产环境中的缓存还需要考虑过期时间、容量限制和异常处理。例如热点数据可以设置较长过期时间,变化频繁的数据需要更谨慎的更新机制。
处理缓存一致性问题
缓存最大的风险是缓存数据和数据库数据不一致。例如用户修改昵称后,数据库已经更新,但缓存仍保存旧值,后续请求可能继续读取旧数据。
常见处理方式包括:
- 更新数据库后删除缓存,让下一次读取重新加载最新数据。
- 通过消息通知机制让多个服务同步失效缓存。
- 对强一致业务减少缓存使用范围,将缓存用于允许短暂延迟的数据。
选择合适的缓存策略
商品详情、配置数据等读取频繁的数据通常适合缓存;支付状态、库存扣减等强一致场景通常需要结合数据库事务控制。
缓存不是数据库的替代品,而是通过减少重复读取提升系统吞吐能力。设计缓存时需要综合考虑命中率、更新频率、一致性要求和故障恢复方式。
按自己的节奏,确认真正理解。