
游戏美术与资产 / 系统课时
让批量结果可检查可回溯
让批量结果可检查可回溯
批量生成真正进入生产后,最难的问题往往不是“能不能生成”,而是异常出现时能否迅速知道它用了什么输入、产出了什么文件、在哪一步失败。本篇建立一套轻量的参数记录、自动检查与失败回溯链路。
学习目标
- 为每个批量任务保存可复现的输入、参数与输出记录
- 用自动检查拦截缺文件、空文件和尺寸异常等硬错误
- 通过任务 ID 把清单、日志与失败阶段串成一条定位链
把一次生成变成可追溯记录
不要只留下最终的 FBX、贴图或 JSON。每个批量项都应有稳定的 jobId,并在输出旁保存一份 sidecar manifest。它不是 Houdini 内置格式,而是团队自定义的生产记录,用来回答“谁生成、用什么参数生成、生成了什么”。
最少应记录输入来源、生成器或 HDA 版本、关键参数与随机种子、Houdini 版本、输出路径、可量化结果以及最终状态。随机过程尤其要保存 seed,否则同一个失败任务很难再次得到相同几何。
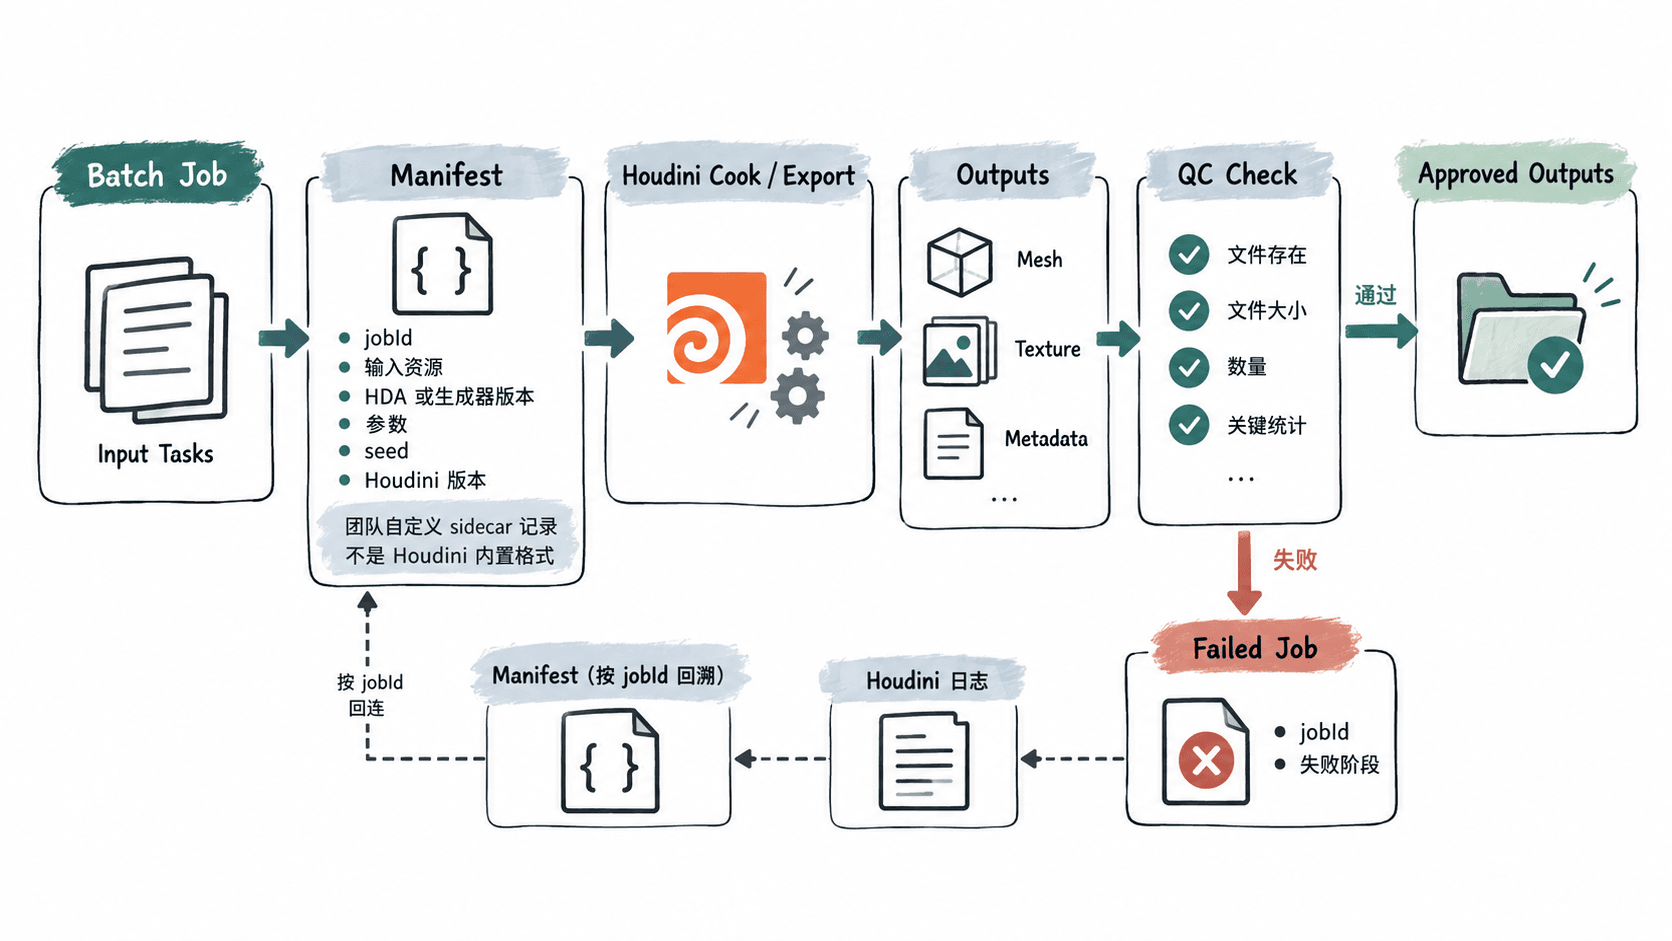
下面是一份精简的 manifest 示例。字段名可以按项目调整,但一旦进入生产就应保持稳定,避免同一批次中不同工具写出互不兼容的记录。
{
  "jobId": "rock-042",
  "generator": {
    "name": "RockGenerator",
    "definitionVersion": "3.4.1",
    "houdiniVersion": "21.0"
  },
  "input": {
    "source": "inputs/rock_042.json",
    "seed": 42
  },
  "parameters": {
    "height": 1.8,
    "erosion": 0.35
  },
  "outputs": [
    {
      "path": "outputs/rock_042.fbx",
      "bytes": 248316
    },
    {
      "path": "outputs/rock_042.json",
      "bytes": 1264
    }
  ],
  "status": "succeeded"
}
这类配置的验证重点不是“能否被 Houdini 读取”,而是批处理器、检查脚本和资产入库步骤是否都能按同一字段找到对应任务与产物。
先用机器做硬检查
人工打开每个模型检查既慢又不稳定。第一层质量门应只处理能客观判断的条件,例如输出是否存在、文件是否为零字节、数量是否符合预期、记录的字节数是否与实际一致。几何面数、包围盒、材质槽数量等项目指标也可以继续加入,但应先从最稳定的检查开始。
下面的 Python 脚本会读取 manifest,并检查其中声明的输出文件。它只使用标准库,可直接作为批处理后的第一道检查器。
from pathlib import Path
import json
import sys

def audit(manifest_path: Path) -> int:
    data = json.loads(manifest_path.read_text(encoding="utf-8"))
    outputs = data.get("outputs", [])
    problems = []

    if not outputs:
        problems.append("outputs is empty")

    for item in outputs:
        # 以 manifest 所在目录为基准,避免批处理工作目录变化影响相对路径。
        output_path = manifest_path.parent / item["path"]
        if not output_path.is_file():
            problems.append(f"missing: {item['path']}")
            continue

        # 先确认文件可读,再比较可量化结果,避免把损坏产物继续入库。
        actual_bytes = output_path.stat().st_size
        if actual_bytes == 0:
            problems.append(f"empty: {item['path']}")
            continue

        expected_bytes = item.get("bytes")
        if isinstance(expected_bytes, int) and actual_bytes != expected_bytes:
            problems.append(
                f"size mismatch: {item['path']} expected={expected_bytes} actual={actual_bytes}"
            )

    if problems:
        # 非零退出码让调度器能够中止该项的后续发布步骤。
        print(f"FAIL job={data.get('jobId', '<UNKNOWN>')}")
        for problem in problems:
            print(f"- {problem}")
        return 1

    print(f"PASS job={data.get('jobId', '<UNKNOWN>')} outputs={len(outputs)}")
    return 0

if __name__ == "__main__":
    if len(sys.argv) != 2:
        raise SystemExit("usage: python audit_batch.py <manifest.json>")
    raise SystemExit(audit(Path(sys.argv[1])))
将脚本保存为 audit_batch.py,在 manifest 所在目录已经存在对应输出文件后运行:
python audit_batch.py manifest.json预期输出:
PASS job=rock-042 outputs=2若实际文件大小、目录或任务编号不同,输出中的数字与任务 ID 会随真实数据变化。检查失败时脚本返回非零退出码,批处理器就可以把该项标记为失败而不是继续入库。
失败记录要能定位到阶段
只保存一条“生成失败”没有诊断价值。失败记录至少要带上 jobId、失败阶段、涉及的资产或节点路径、异常文本和日志位置。阶段名称应来自有限集合,例如 input、cook、export、validate,便于统计哪一环最常出问题。
日志与 manifest 不必塞进同一个大文件,但必须能通过同一个 jobId 互相找到。这样即使最终目录里没有可用模型,也能从失败项直接回到输入参数和错误上下文,而不是重新猜测当时发生了什么。
用故障注入验证回溯链
上线前应主动制造几类失败:删除一个输出文件、把文件截断为零字节、修改 manifest 中的期望大小,再确认检查器都能拒绝这些结果,并且日志能够通过 jobId 找回对应输入。
真正稳定的批量管线不是“从不失败”,而是每次失败都能被及时发现、明确归类并复现。只要参数、版本、输出与日志形成闭环,几十或几百个 Houdini 任务同时运行时,排查仍然可以从具体证据开始。