
游戏美术与资产 / 系统课时
控制大场景生成的计算开销
控制大场景生成的计算开销
程序化生成大规模游戏场景时,性能瓶颈通常来自几何数量、节点计算顺序和数据复制方式。本节将分析 Houdini 网络中的主要开销来源,并通过实例化、节点优化和数据控制降低生成成本。
学习目标
- 理解大规模程序化场景中的主要性能瓶颈。
- 掌握减少几何计算和数据复制的方法。
- 能够设计更适合批量生成的节点网络。
大场景为什么容易变慢
程序化场景生成会同时处理大量对象,例如建筑、植被、道路和环境细节。如果每个对象都生成完整几何,数据规模会快速增长。
性能问题通常来自三个方面:
- 几何数量过多,导致内存和计算压力增加。
- 节点顺序不合理,使昂贵操作提前执行。
- 重复数据被复制,而不是通过实例共享。
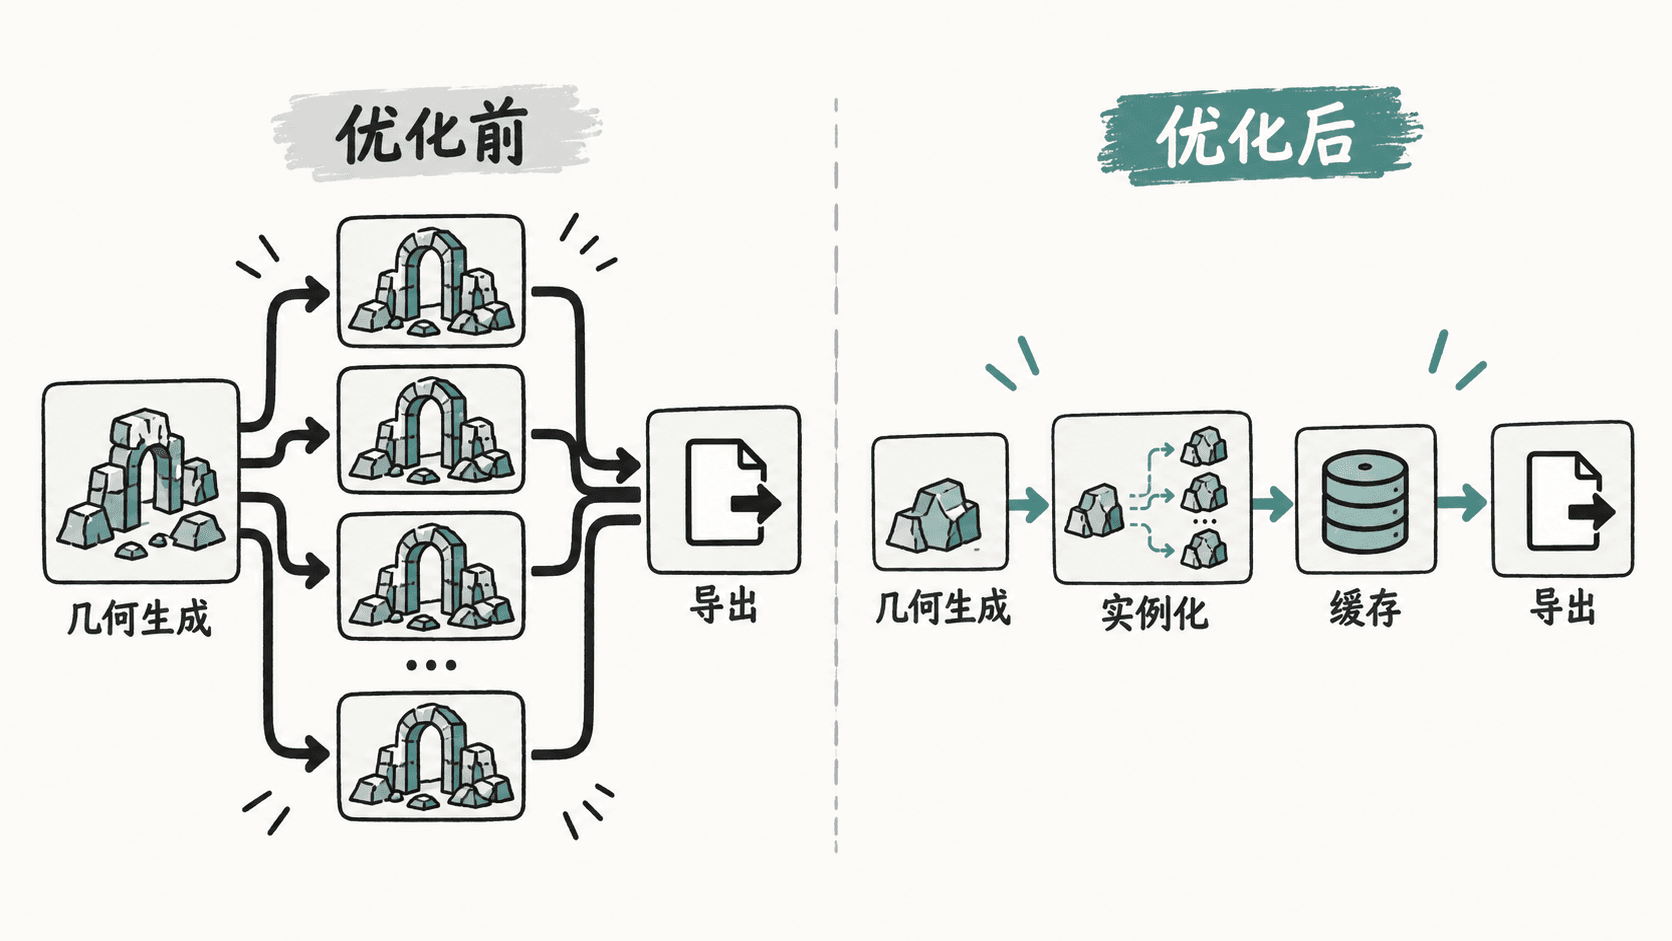
例如,一个森林场景中有一万棵树。如果每棵树都保存完整模型几何,会产生巨大的数据量;如果使用实例化,只需要保存一份树模型,再记录每个位置的信息即可。
减少不必要的几何计算
优化程序化网络时,应尽量让昂贵操作处理更少的数据。
例如,先进行对象筛选,再进行细分或复杂变形,比先处理全部几何更加高效。
常见优化方式包括:
- 在早期阶段删除不会参与最终输出的数据。
- 延后高成本节点执行。
- 使用低精度数据完成布局阶段。
节点顺序会直接影响计算量。一个简单原则是:轻量过滤操作尽量靠前,高成本生成操作尽量靠后。
使用实例化降低内存占用
实例化适合处理大量重复对象,例如树木、岩石、路灯和建筑模块。
实例化不会为每个对象复制完整几何,而是保存对象引用和变换信息。
下面是一个简单的 Houdini Python 示例,用于观察点数量并生成实例化思路中的基础数据:
import hou

# 获取当前节点输入几何,用于统计布局点数量
node = hou.pwd()
geometry = node.geometry()

points = geometry.points()
print("instance count:", len(points))
预期输出
instance count: 5000实际项目中,5000 个点可以代表 5000 个对象的位置,而不是 5000 份完整模型数据。
控制中间数据规模
Houdini 节点之间会传递几何数据,如果每一步都保留大量无用属性,会增加计算和保存成本。
优化时可以检查:
- 是否存在不再使用的属性。
- 是否保存了过高精度的中间几何。
- 是否有重复生成的数据流。
例如,导出游戏资产前,可以删除仅用于生成阶段的临时属性,只保留位置、法线、UV 等最终需要的数据。
设计适合批量生产的网络
批量生产管线需要考虑稳定性,而不仅是单次生成速度。
推荐将网络划分为几个阶段:
| 阶段 | 目标 | 优化重点 |
|---|---|---|
| 布局阶段 | 确定位置和数量 | 低精度快速反馈 |
| 生成阶段 | 创建详细资产 | 缓存和实例化 |
| 整理阶段 | 准备导出 | 清理无用数据 |
这种结构可以让团队在调整布局时快速迭代,而不需要每次重新生成全部细节。
性能优化的验证方法
优化后需要重新测试,而不是只凭感觉判断。
可以记录:
- 单次生成耗时。
- 内存占用变化。
- 缓存文件大小。
- 导出时间。
如果减少了计算时间但增加了大量缓存管理成本,也需要重新评估方案。大场景程序化开发的目标不是让某一个节点最快,而是让整个生产流程稳定可重复。