
游戏美术与资产 / 系统课时
降低高密度自然资产开销
降低高密度自然资产开销
自然场景的性能问题通常不是“树太多”这么简单,而是唯一网格过多、源模型过密、重复烹饪和无差别输出叠加造成的。本课把这些成本拆开,并用实例化、LOD 与输出分层把高密度散布变成可控的生产流程。
学习目标
- 判断自然资产的主要成本来自几何数量、实例数量还是 Houdini 计算过程。
- 用 Packed Primitive 与点属性组织可复用实例,避免复制完整网格。
- 为固定场景生成 LOD 分支,并控制只输出游戏真正需要的数据。
先分清几何成本与生成成本
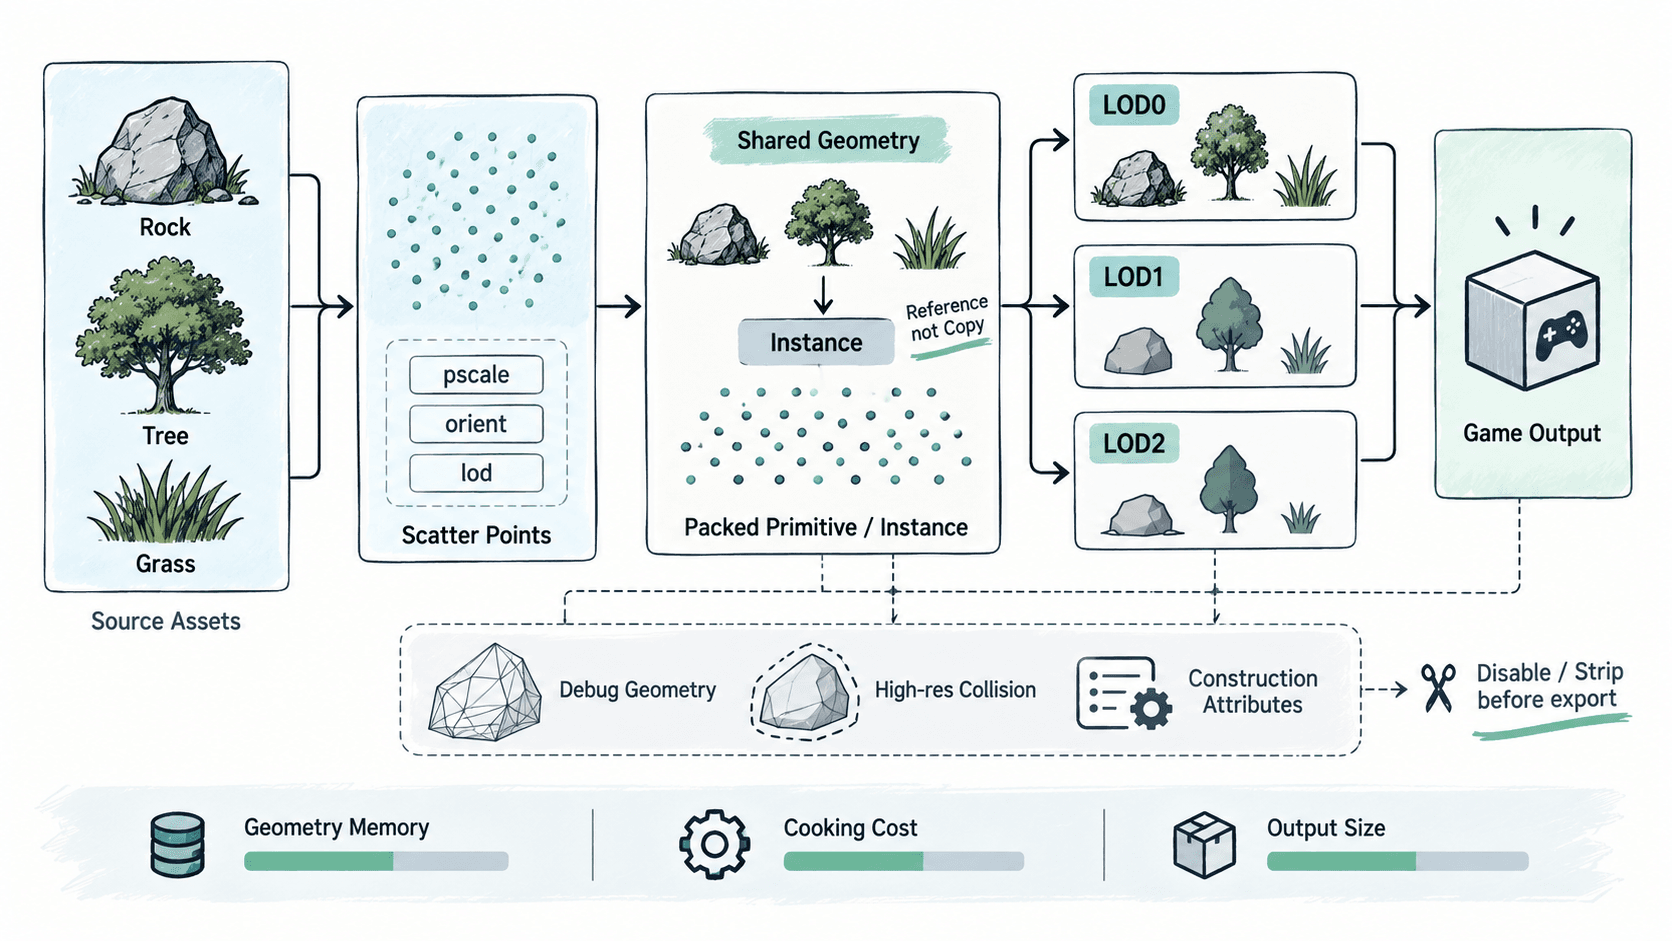
在 Houdini 中,十万棵“树”可能代表两种完全不同的负担:复制十万份完整多边形,或保留十万个轻量点并引用少量共享几何。前者会迅速增加内存、保存时间与节点处理量;后者更适合程序化自然场景。
优化时先看三类数据:源资产面数、散布点数、最终唯一几何份数。若源岩石本身就有数十万面,先做简化;若同一棵树被真实复制数万次,则优先实例化;若每次参数变化都会重算昂贵噪声、布尔或 VDB,则需要缓存或缩短节点链。
用点驱动实例而不是复制网格
典型做法是先 Scatter 点,再让点保存 pscale、orient、variant 等差异信息,最后用 Copy to Points 复制已经 Pack 的源几何。这样场景中的变化主要存在于点属性,而不是重复的顶点数组。
下面是 Point Wrangle 的片段示例。它依赖输入 0 为散布点,并需要在 Wrangle 上创建 near_end、far_start、scale_min、scale_max、variant_count 和 seed 参数;代码只负责分类与实例属性,不负责复制网格。
vector camera_pos = chv("camera_pos");
float d = distance(@P, camera_pos);

float near_end = chf("near_end");
float far_start = chf("far_start");

i@lod = d < near_end ? 0 : (d < far_start ? 1 : 2);
i@variant = @ptnum % max(1, chi("variant_count"));

float r = rand(@ptnum * 17 + chi("seed"));
@pscale = fit01(r, chf("scale_min"), chf("scale_max"));
预期结果
每个散布点新增 lod、variant 与 pscale 属性。
lod 的值为 0、1 或 2;pscale 落在设定的最小值与最大值之间。
随后可按 lod 分成三条分支,分别 Copy to Points 到高、中、低三套 Packed 源几何。固定镜头或固定关卡的离线构建适合这样按距离裁分;如果资产要交给运行时动态相机使用,更稳妥的做法是输出完整 LOD 集合,让游戏引擎在运行时选择级别。
让 LOD 真正减少数据
LOD 不是把同一个高模复制三次并改名字。每个级别都应减少实际资源成本,例如降低三角形数量、减少小枝叶卡片、合并材质槽,并在远距离版本中删除玩家看不到的背面或内部结构。
自然资产还要区分视觉网格与碰撞。远景草、碎石和灌木通常不需要复杂碰撞;树干也常用简单胶囊或凸包代替渲染网格。这样既减少输出体积,也避免把离线生成成本转化成运行时物理成本。
控制烹饪与发布输出
生成器内部可以保留高精度地形采样、调试颜色和中间遮罩,但发布输出不应无条件携带这些内容。把昂贵节点放在稳定输入之后缓存,给调试分支设置开关,并在最终节点前删除不再需要的大型属性。
验收时分别检查三件事:相同源资产是否仍然共享、LOD 三档的面数是否逐级下降、发布输出里是否只剩渲染、实例与必要碰撞数据。高密度自然场景的优化目标不是单纯减少点,而是让“每个点引用什么、何时计算、最终输出什么”都受到控制。