
多人游戏与网络同步 / 系统课时
构建完整预测校正案例
构建完整预测校正案例
本课把角色移动预测、服务端权威校正和异常处理串成一条可运行链路。你将用序号记录输入,用快照确认状态,并在出现预测偏差时回滚到权威位置再重放未确认输入。
学习目标
- 实现带
seq的客户端预测移动与服务端权威校正 - 处理乱序、重复响应和超时等异常情况
- 用日志与断言验证校正后的状态能够继续稳定运行
设计完整的同步闭环
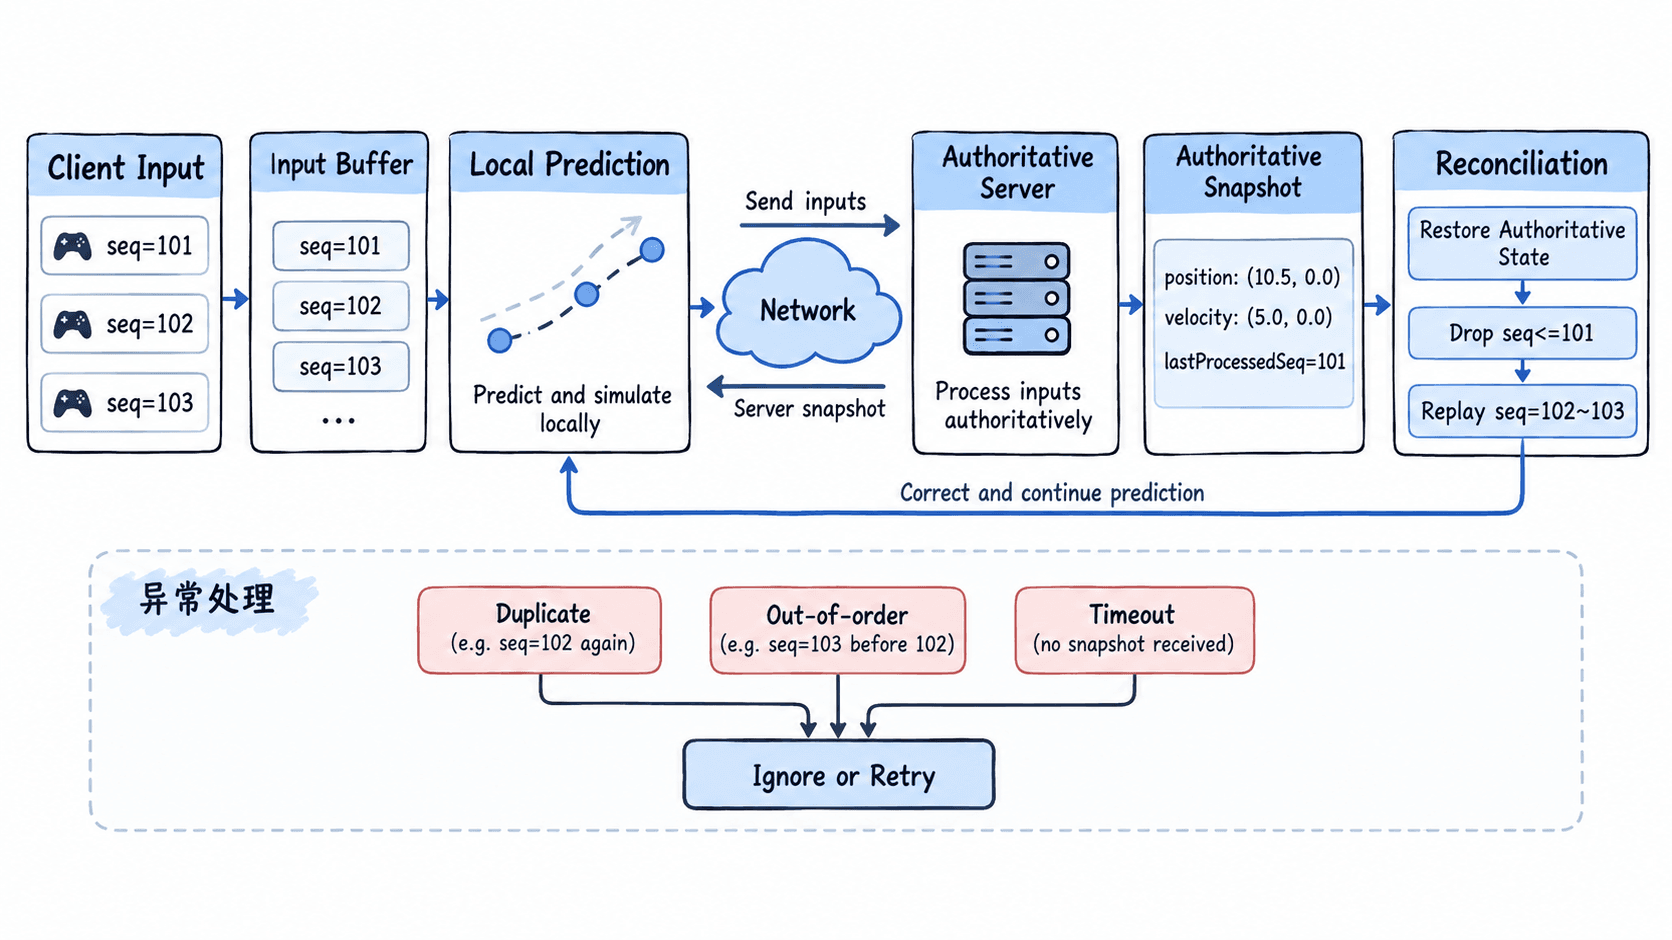
一个可维护的预测校正案例至少要保存三类状态:客户端已经产生的输入、最近一次得到服务端确认的状态,以及确认点之后仍未被确认的输入。客户端收到权威快照后,不能简单覆盖当前位置,否则会直接丢失玩家已经操作但尚未抵达服务器的输入。
本例采用递增的 seq 标识每次输入。服务端返回 lastProcessedSeq,客户端据此判断哪些输入已经确认。校正过程固定为“恢复权威状态 → 丢弃已确认输入 → 按序重放剩余输入”,因此即使网络延迟导致本地提前移动,也能重新得到一致的预测状态。
实现最小可运行模型
为了先验证同步逻辑,可以把角色简化成一维位置。客户端每次收到右移或左移输入就立即更新本地位置,同时把输入放入待确认队列;服务端按 seq 顺序处理请求,并返回处理到哪个序号。下面的脚本在单进程内模拟网络延迟,但保留真正预测校正所需要的状态结构。
from dataclasses import dataclass
from collections import deque

@dataclass(frozen=True)
class InputCommand:
    seq: int
    direction: int
    dt: float

@dataclass(frozen=True)
class Snapshot:
    position: float
    last_processed_seq: int


def simulate(command: InputCommand, position: float) -> float:
    return position + command.direction * command.dt * 5.0


def server_apply(commands: list[InputCommand], position: float, last_processed_seq: int):
    for command in commands:
        if command.seq <= last_processed_seq:
            continue
        position = simulate(command, position)
        last_processed_seq = command.seq
    return Snapshot(position, last_processed_seq)


def reconcile(snapshot: Snapshot, pending: deque[InputCommand]) -> float:
    while pending and pending[0].seq <= snapshot.last_processed_seq:
        pending.popleft()

    position = snapshot.position
    for command in pending:
        position = simulate(command, position)
    return position


client_position = 0.0
server_position = 0.0
pending = deque()

for seq in (101, 102, 103):
    command = InputCommand(seq=seq, direction=1, dt=0.1)
    pending.append(command)
    client_position = simulate(command, client_position)

# 模拟服务端先确认到 seq=101,后续输入仍在客户端等待。
snapshot = server_apply(
    [InputCommand(101, 1, 0.1)],
    server_position,
    last_processed_seq=0,
)
server_position = snapshot.position
client_position = reconcile(snapshot, pending)

print(f"server_position={server_position:.1f}")
print(f"client_position={client_position:.1f}")
print(f"pending={[command.seq for command in pending]}")
预期输出
server_position=0.5
client_position=1.5
pending=[102, 103]
这里服务端只确认了 seq=101,因此客户端先恢复到 0.5,再重新应用 102 和 103,最终得到 1.5。这个结果比“收到快照后直接覆盖当前位置”更可靠,因为未确认输入没有被丢掉。
处理校正边界与异常
真实网络环境不会只返回理想响应。首先要保证服务端确认序号单调递增:如果收到旧快照,例如当前已经确认到 105,之后又收到 103,客户端应忽略它,而不是回滚到更旧的状态。
重复响应同样不应该重复执行输入。只要输入队列以 seq 去重,并且只移除 seq <= lastProcessedSeq 的项,就可以让重复快照成为幂等操作。对于超过等待阈值仍未收到确认的输入,则应该进入超时处理,例如记录日志并重新发送,而不是持续无限增长缓冲区。
可用下面的测试函数检查旧快照不会让状态倒退。它同时验证重复确认后队列仍然保持幂等。
def apply_snapshot_safely(
    snapshot: Snapshot,
    current_last_processed_seq: int,
    pending: deque[InputCommand],
    current_position: float,
) -> tuple[int, float]:
    if snapshot.last_processed_seq < current_last_processed_seq:
        return current_last_processed_seq, current_position

    position = reconcile(snapshot, pending)
    return snapshot.last_processed_seq, position


pending = deque([
    InputCommand(106, 1, 0.1),
    InputCommand(107, 1, 0.1),
])
last_seq = 107
position = 1.0

old_snapshot = Snapshot(position=0.5, last_processed_seq=105)
last_seq, position = apply_snapshot_safely(
    old_snapshot, last_seq, pending, position
)

print(f"last_seq={last_seq}")
print(f"position={position:.1f}")
print(f"pending={[command.seq for command in pending]}")
预期结果
last_seq=107
position=1.0
pending=[106, 107]
这个边界检查的重点不是“拒绝网络包”,而是拒绝会让客户端状态回退的旧确认。对于重复的同一快照,也应该得到相同结果;日志中可以同时记录 lastProcessedSeq、当前队列长度以及校正前后的误差,方便定位真实环境中的回弹问题。
验收预测校正是否可靠
完成案例后,至少验证三个结果:正常情况下本地预测立即生效;收到部分确认后只重放未确认输入;旧确认、重复确认和超时不会破坏已经建立的确认进度。还应检查输入队列存在上限,避免服务器异常时内存持续增长。
一次校正结束后,客户端真正需要保证的是“逻辑状态来自权威快照,未确认输入仍按原顺序继续模拟”。只要这个闭环保持稳定,网络抖动带来的短暂偏差就会被限制在可恢复范围内,而不是逐步积累成永久状态分叉。