
多人游戏与网络同步 / 系统课时
验证预测误差与同步效果
验证预测误差与同步效果
本课把“操作起来很顺”变成可量化的工程指标,通过位置误差、校正频率和确认延迟判断预测是否真的有效,并用最小测试数据验证网络表现是否达到目标。
学习目标
- 计算预测状态与服务器权威状态之间的误差
- 区分平均误差、峰值误差、校正率和确认延迟
- 用可重复的测试样本评估不同网络条件下的同步效果
先定义可测指标
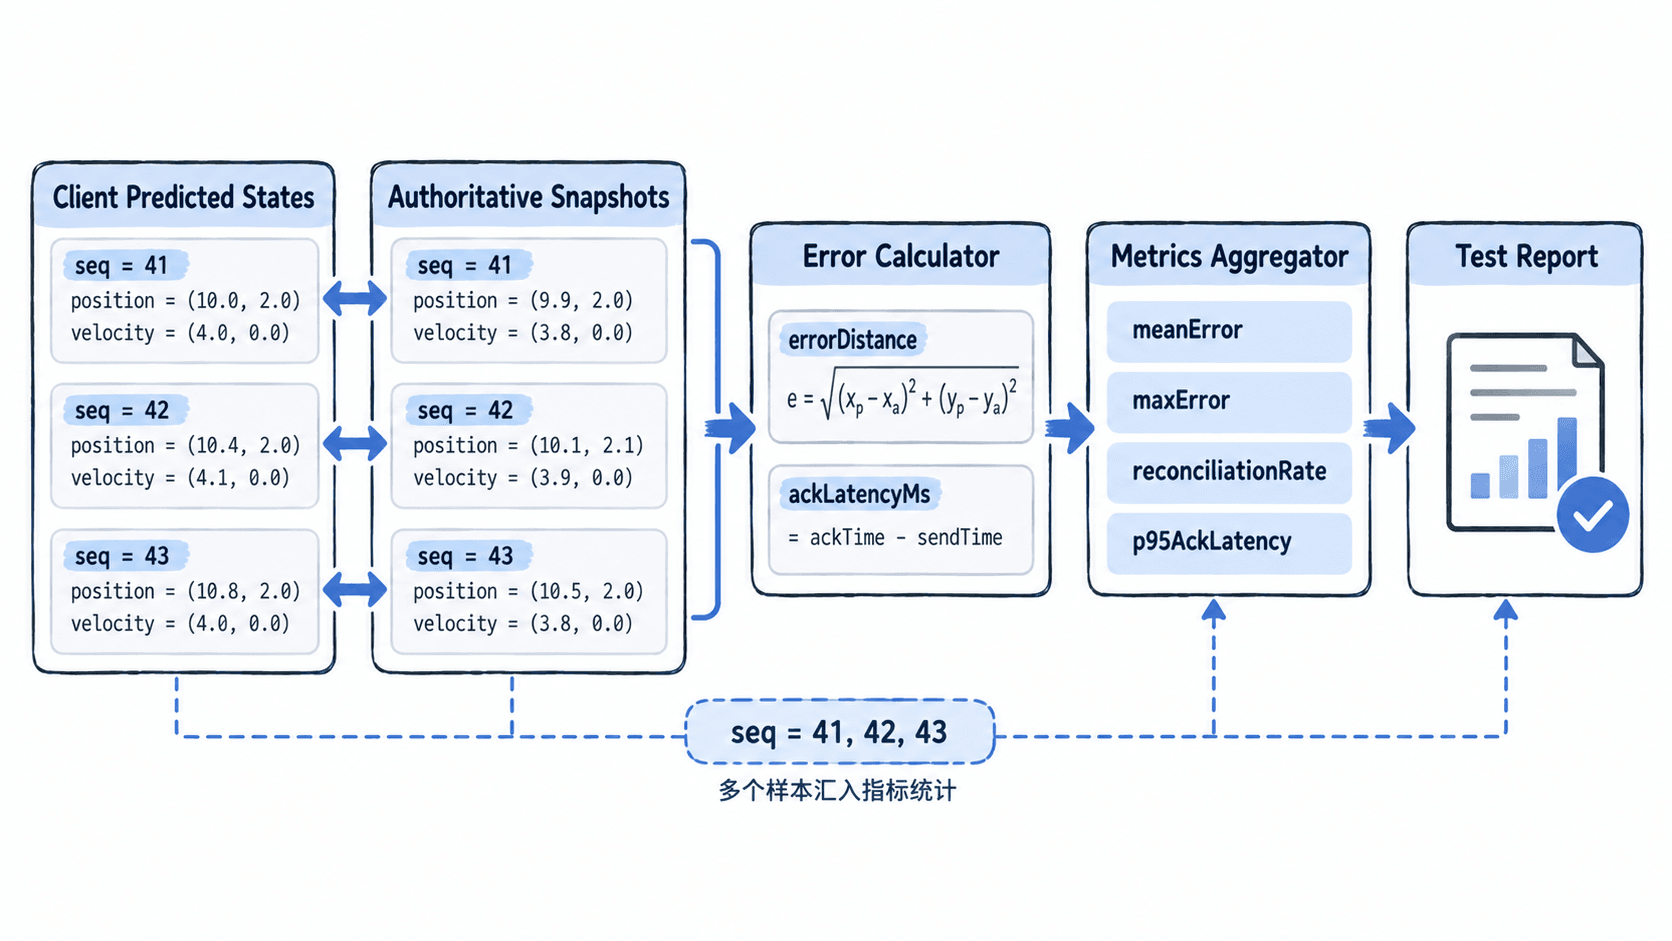
预测效果不能只看平均位置误差。建议至少同时观察 meanError、maxError、reconciliationRate 和 ackLatencyMs。平均误差反映整体精度,最大误差暴露最严重偏差,校正率反映本地预测有多频繁被服务器修正,确认延迟则帮助解释为什么误差会持续存在。
对于 N 次已确认输入,可以把校正率定义为 ,其中 C 是触发校正的次数。工程上还应保留原始样本,避免只有一个汇总数字而无法追查异常。
用样本直接计算结果
下面的脚本不依赖第三方库,使用几组已经完成确认的预测样本计算平均误差、最大误差、校正率和确认延迟。它适合作为单元测试或离线回放工具的最小骨架。
from math import hypot

samples = [
    {"seq": 41, "pred": (10.0, 2.0), "auth": (9.9, 2.0), "corrected": False, "ackLatencyMs": 82},
    {"seq": 42, "pred": (10.4, 2.0), "auth": (10.1, 2.1), "corrected": True, "ackLatencyMs": 96},
    {"seq": 43, "pred": (10.8, 2.0), "auth": (10.5, 2.0), "corrected": True, "ackLatencyMs": 91},
]

errors = [
    hypot(sample["pred"][0] - sample["auth"][0], sample["pred"][1] - sample["auth"][1])
    for sample in samples
]

mean_error = sum(errors) / len(errors)
max_error = max(errors)
reconciliation_rate = sum(sample["corrected"] for sample in samples) / len(samples)
mean_ack_latency = sum(sample["ackLatencyMs"] for sample in samples) / len(samples)

print(f"meanError={mean_error:.3f}")
print(f"maxError={max_error:.3f}")
print(f"reconciliationRate={reconciliation_rate:.3f}")
print(f"meanAckLatencyMs={mean_ack_latency:.1f}")
预期输出
meanError=0.233
maxError=0.316
reconciliationRate=0.667
meanAckLatencyMs=89.7
样本只是演示,实际阈值应根据移动速度、服务器 tick、游戏手感和目标网络环境制定,不能直接把这些数值当成通用标准。
怎样做网络条件测试
验证预测系统时不要只在本机低延迟环境下运行。至少应重复测试正常延迟、高延迟、抖动和丢包场景,并对每种条件分别记录同一组指标。重点不是“有没有误差”,而是误差是否随网络条件变化而失控,以及恢复网络后能否回到稳定水平。
建议固定测试输入序列,让每轮测试都发送相同的 seq 集合。这样修改预测算法后,可以直接比较两次结果,而不是因为玩家操作不同导致指标无法解释。
怎样判断同步方案是否变好
一次优化后,如果 meanError 与 maxError 同时下降,同时 reconciliationRate 没有异常升高,通常说明预测更接近权威结果。若平均误差下降但最大误差突然变大,应优先检查少量极端场景,而不是只看平均值。
确认延迟也必须独立观察。网络 RTT 下降并不等于预测算法更准确;相反,延迟不变而误差显著下降,往往意味着本地模拟、输入时间处理或校正策略确实得到了改进。
最终验收应保留原始样本与汇总指标两层结果:汇总指标用于快速比较版本,原始 seq 级数据用于回放和排障。这样每次优化都能从“体感更顺”升级为可重复、可解释的工程证据。