
多人游戏与网络同步 / 系统课时
处理高延迟和丢包环境
处理高延迟和丢包环境
高延迟和丢包会同时放大预测误差、输入堆积和回调乱序问题。本文从可重复的异常网络测试入手,建立一个最小故障模型,并用超时、重试、序号确认和状态重同步保证技能预测最终回到权威状态。
学习目标
- 用可控的延迟和丢包条件观察预测系统的实际行为。
- 识别“请求迟到、请求丢失、结果迟到”三类不同故障。
- 设计有界重试、超时处理和权威快照恢复策略。
先把异常网络变成可测试条件
不要等线上偶发卡顿才判断预测系统是否可靠。测试环境应明确记录单向延迟、丢包率和抖动,并重复同一组输入,这样才能比较“预测到确认”的时间和最终状态差异。
下面的 Python 示例模拟发送 20 个技能命令,并随机丢弃请求或延迟结果。它不是网络库,只用于本地验证序号、超时和未确认集合的处理逻辑。
import random
import time

random.seed(7)

pending = {}
confirmed = set()
lost = set()

for command_seq in range(1, 21):
    pending[command_seq] = time.monotonic()

    # 模拟 20% 请求丢包;实际项目应由网络层产生这一条件。
    if random.random() < 0.20:
        lost.add(command_seq)
        continue

    # 模拟结果延迟;超过 0.15 秒则视为本次确认超时。
    delay = random.uniform(0.02, 0.25)
    time.sleep(0.01)

    if delay <= 0.15:
        confirmed.add(command_seq)

expired = sorted(seq for seq in pending if seq not in confirmed)
print("confirmed:", len(confirmed))
print("expired_or_lost:", len(expired))
print("lost:", sorted(lost))
预期结果
confirmed: 16
expired_or_lost: 4
lost: [3, 5, 11, 17]
这个结果受示例中的固定随机种子和模拟规则约束,真实网络测试不会得到相同数量。重要的是系统能明确区分“已确认”和“仍未确认”,而不是把所有未及时返回的请求都当成服务器拒绝。
三类故障要分别处理
请求丢失时,服务器根本没有看到该命令,客户端可以在幂等条件下重试;结果丢失时,服务器可能已经执行成功,客户端不能盲目再次执行技能;高延迟时,请求和结果只是晚到,最危险的做法是因为“等太久”就自行生成一个新的权威结果。
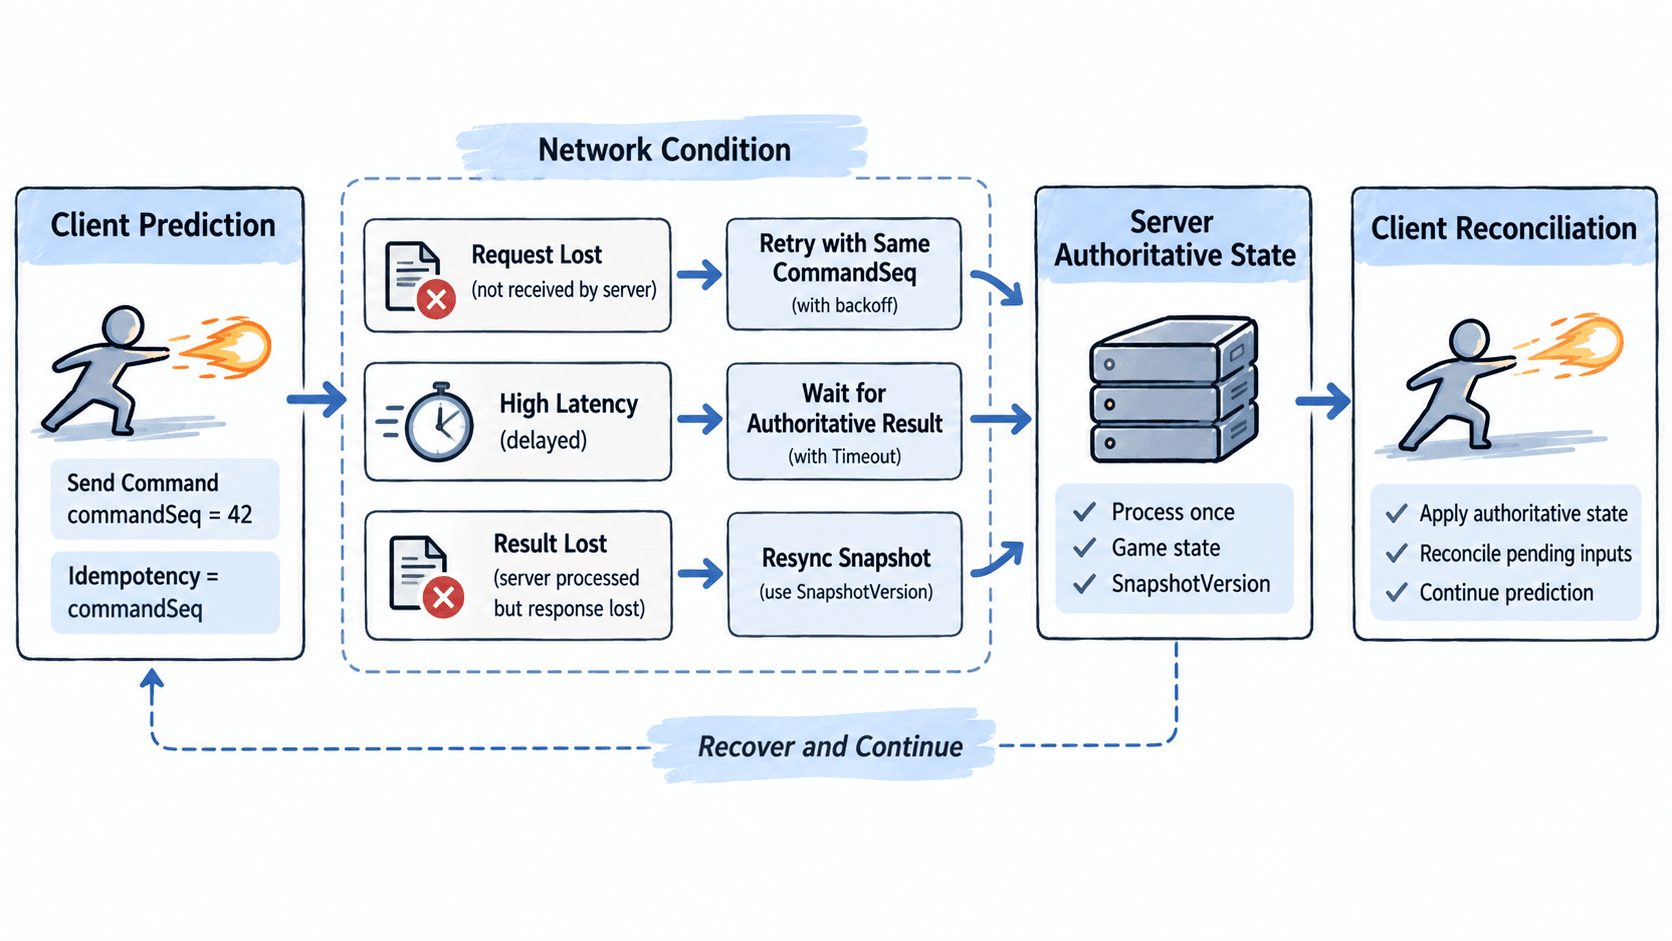
超时、重试与快照恢复
客户端可以为待确认命令设置较短超时,但超时的含义应该是“暂时没有确认”,而不是“技能失败”。重试次数也必须有上限,例如最多重试 2 次;达到上限后进入等待快照或状态查询,而不是无限发送。
当连续丢包导致本地预测历史与服务器差距过大时,应停止继续基于错误状态扩张预测,转而接收权威快照。快照通常包含状态版本、位置、资源、冷却等可判定字段。应用快照后,再从最后确认的序号之后重放仍然有效的输入。
from dataclasses import dataclass

@dataclass
class ClientState:
    confirmed_seq: int
    energy: int
    cooldown_ready: bool

def reconcile(state: ClientState, snapshot: dict, pending: list[int]) -> ClientState:
    # 先采用服务器快照,再决定哪些未确认输入可以继续预测。
    state.confirmed_seq = snapshot["ack_seq"]
    state.energy = snapshot["energy"]
    state.cooldown_ready = snapshot["cooldown_ready"]

    valid_pending = [seq for seq in pending if seq > state.confirmed_seq]
    print("replay:", valid_pending)
    return state

state = ClientState(confirmed_seq=40, energy=10, cooldown_ready=False)
snapshot = {"ack_seq": 42, "energy": 60, "cooldown_ready": True}
reconcile(state, snapshot, pending=[41, 42, 43, 44])
预期结果
replay: [43, 44]快照已经确认到 42,因此 41 和 42 不应再次重放,只有 43、44 仍属于客户端需要重新预测的输入。实际项目还应结合技能前置条件和状态版本判断某个输入是否仍然有效。
怎样验证异常网络下仍然稳定
验收不要只看“画面有没有卡住”,而要记录命令序号、发送时间、确认时间、重试次数和最近一次快照版本。重点观察:同一 commandSeq 是否出现重复执行;客户端是否能在结果乱序后保持单调确认;超时后是否进入有限重试;连续丢包恢复后是否重新收敛到服务器状态。
一个稳定的预测系统允许短时间内存在视觉差异,但不会让差异无限扩大。高延迟环境下,目标不是让预测永远正确,而是让错误有边界、恢复有入口、最终结果由权威状态收敛。