
游戏 AI / 系统课时
大地图感知占用过高怎么降
大地图感知占用过高怎么降
大地图里 NPC 数量和可感知对象同时增长时,性能瓶颈通常不是某一次射线检测太慢,而是“多少 NPC、多久查一次、每次查多少候选、对多少候选做昂贵检测”一起放大。本课按这四个乘数定位热点,并给出可验证的降载顺序。
学习目标
- 能把感知开销拆成查询次数、候选数量、更新频率和单次成本
- 能判断应先降频、减候选还是引入空间划分
- 能用简单预算估算优化前后的检测规模
先把总成本拆成四个乘数
可以先用一个粗略模型判断热点方向。假设有 N 个活跃 NPC,每秒感知 F 次,每次初筛得到 C 个候选,其中 R 比例的候选继续进入昂贵的视线或视场检测,那么重检测次数近似为:
这个公式不是性能计时器,但很适合找数量级问题。下面的 Python 示例对比优化前后的预算。
def expensive_checks(npc_count: int, hz: float, candidates: int, refine_ratio: float) -> int:
    return int(npc_count * hz * candidates * refine_ratio)

def main() -> None:
    before = expensive_checks(800, 10.0, 120, 0.50)
    after = expensive_checks(800, 4.0, 24, 0.25)

    print(f"before={before} checks/s")
    print(f"after={after} checks/s")
    print(f"reduction={(1 - after / before) * 100:.1f}%")

if __name__ == "__main__":
    main()
预期输出:
before=480000 checks/s
after=19200 checks/s
reduction=96.0%
这里没有优化任何单次算法,仅通过降低更新频率、候选数和进入重检测的比例,就把数量级压了下来。因此第一步应先统计调用规模,再决定是否值得微优化某个函数。
按成本从便宜到昂贵分层过滤
感知链路应尽量让便宜条件挡在前面。先用活动状态、阵营和粗距离排除明显无效对象;再用空间索引取局部候选;之后才做角度判断、遮挡射线或导航可达性等昂贵检查。不要对全地图对象先逐个做射线,再在结果里筛距离。
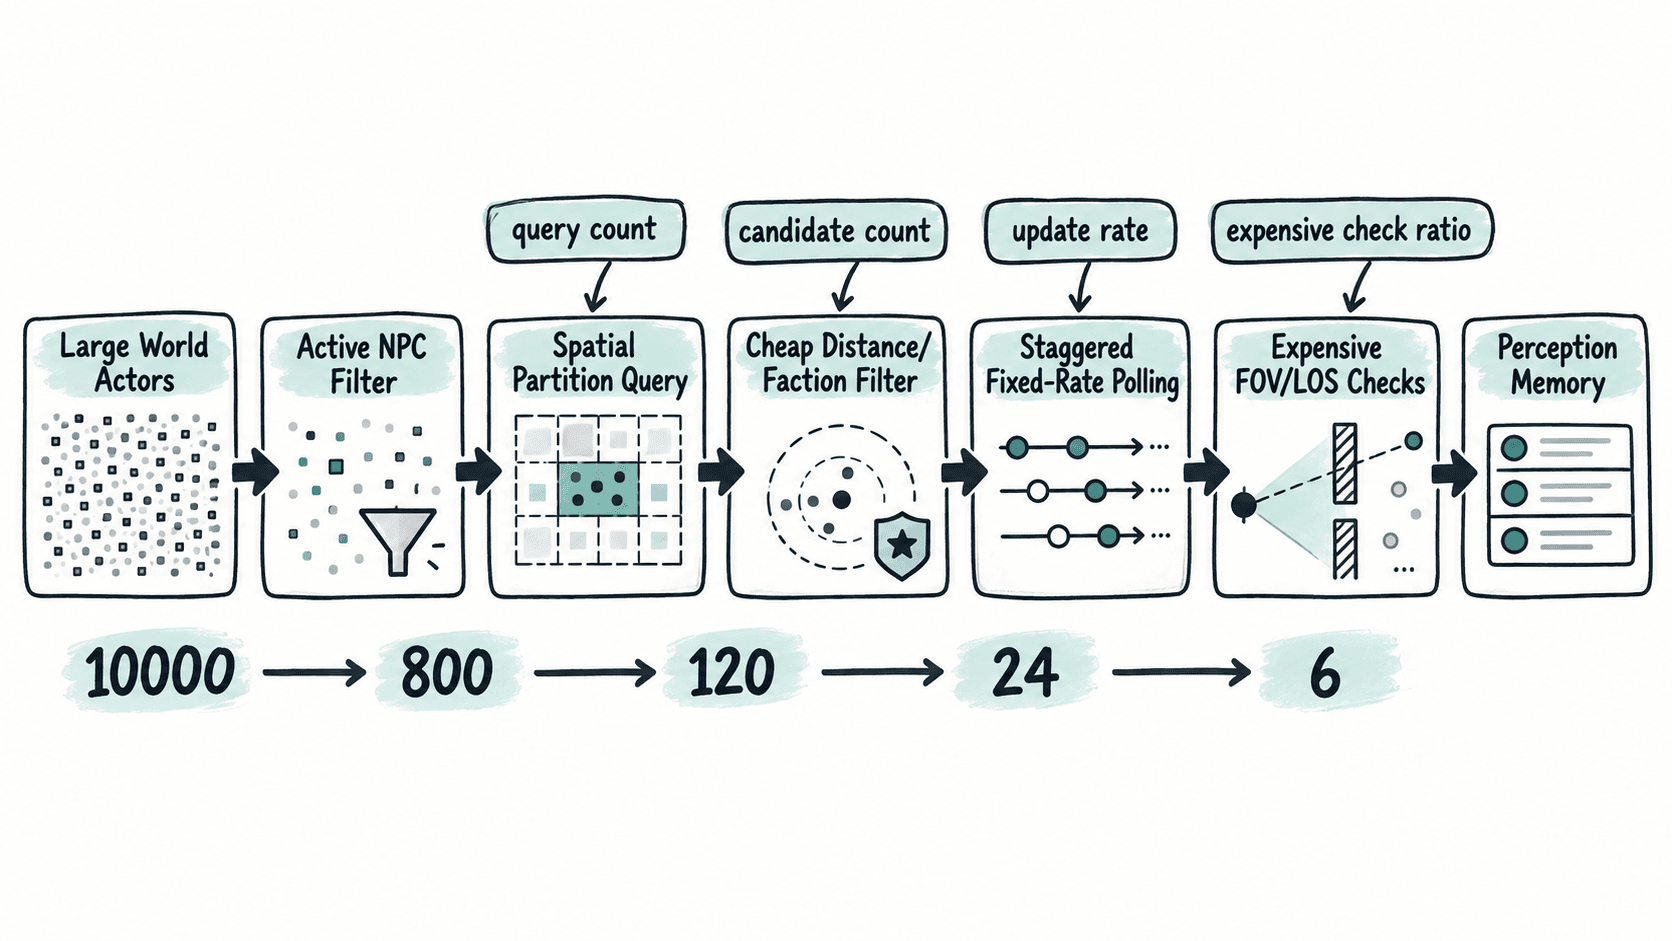
空间划分的价值是避免每个 NPC 都扫描全体对象。规则网格、空间哈希、四叉树或引擎已有的 broad-phase 都可以,选择重点不是名字,而是能否稳定回答“这个 NPC 周围半径内有哪些候选”。如果世界中对象频繁移动,还要把索引更新成本算进去。
再处理更新频率和分帧
感知通常不需要跟渲染帧一一同步。战斗近距离 NPC 可以较高频更新,远距离或非战斗 NPC 可以降到更低频率。与其让 800 个 NPC 在同一帧一起查询,不如按桶分散到多个帧,保持每秒总次数不变但削平单帧峰值。
分帧时要避免所有 NPC 在进入场景后使用相同初始计时器,否则仍可能周期性同帧爆发。可以按稳定 ID 做桶分配,让每个 NPC 固定落在某个更新槽位中。这样既减少抖动,又便于线上观察每帧查询预算。
用性能采样确认瓶颈真的移动了
优化后至少比较三组指标:每秒感知评估次数、每次平均候选数、昂贵查询总次数;同时查看主线程耗时的平均值和高分位峰值。若总调用数下降但帧尖峰没变,说明可能仍存在批量集中执行;若候选数下降但射线次数不降,说明过滤结果没有真正接入后续链路。
验收还要防止“省性能但破坏行为”。抽样检查近距离目标发现延迟、快速穿越视野时的漏检率、远距离 NPC 的响应延迟,以及目标离开空间分区边界时是否丢失。大地图感知优化的正确目标不是把所有检测都做得更快,而是让绝大多数不值得做的检测根本不要发生。