
游戏 AI / 系统课时
画出一次目标选择的数据流
画出一次目标选择的数据流
一个稳定的目标选择系统,不是“看到敌人后取仇恨最高者”这么简单。真正运行时,感知事件要先进入记忆,再更新仇恨,随后选择目标,最后交给移动或战斗行为执行。本课把这条链路完整串起来,并明确每一层应该输入和输出什么。
学习目标
- 理解从感知输入到行为执行的完整目标选择链路
- 能区分感知记忆、仇恨数据和当前目标三类状态
- 能沿数据流定位目标丢失、切换异常和行为错误发生在哪一层
从感知事件开始而不是直接选目标
感知层负责产生事实,例如“玩家 A 在视野内”“玩家 B 发出了声音”“玩家 C 对我造成伤害”。这些输入的来源不同,可靠程度和持续时间也不同,因此不应该直接把某一次事件等同于最终目标。
更合理的入口是统一转换成目标记忆。记忆中可以保存目标标识、最后感知时间、最后已知位置、感知来源和当前可见性。这样即使视觉事件下一帧消失,后续系统仍能知道这个目标刚刚出现过。
数据依次经过五个阶段
一次完整决策可以拆成感知输入、记忆更新、仇恨计算、目标选择和行为执行五个阶段。每层只消费上一层已经整理好的信息,而不是跨层直接读取所有原始数据。
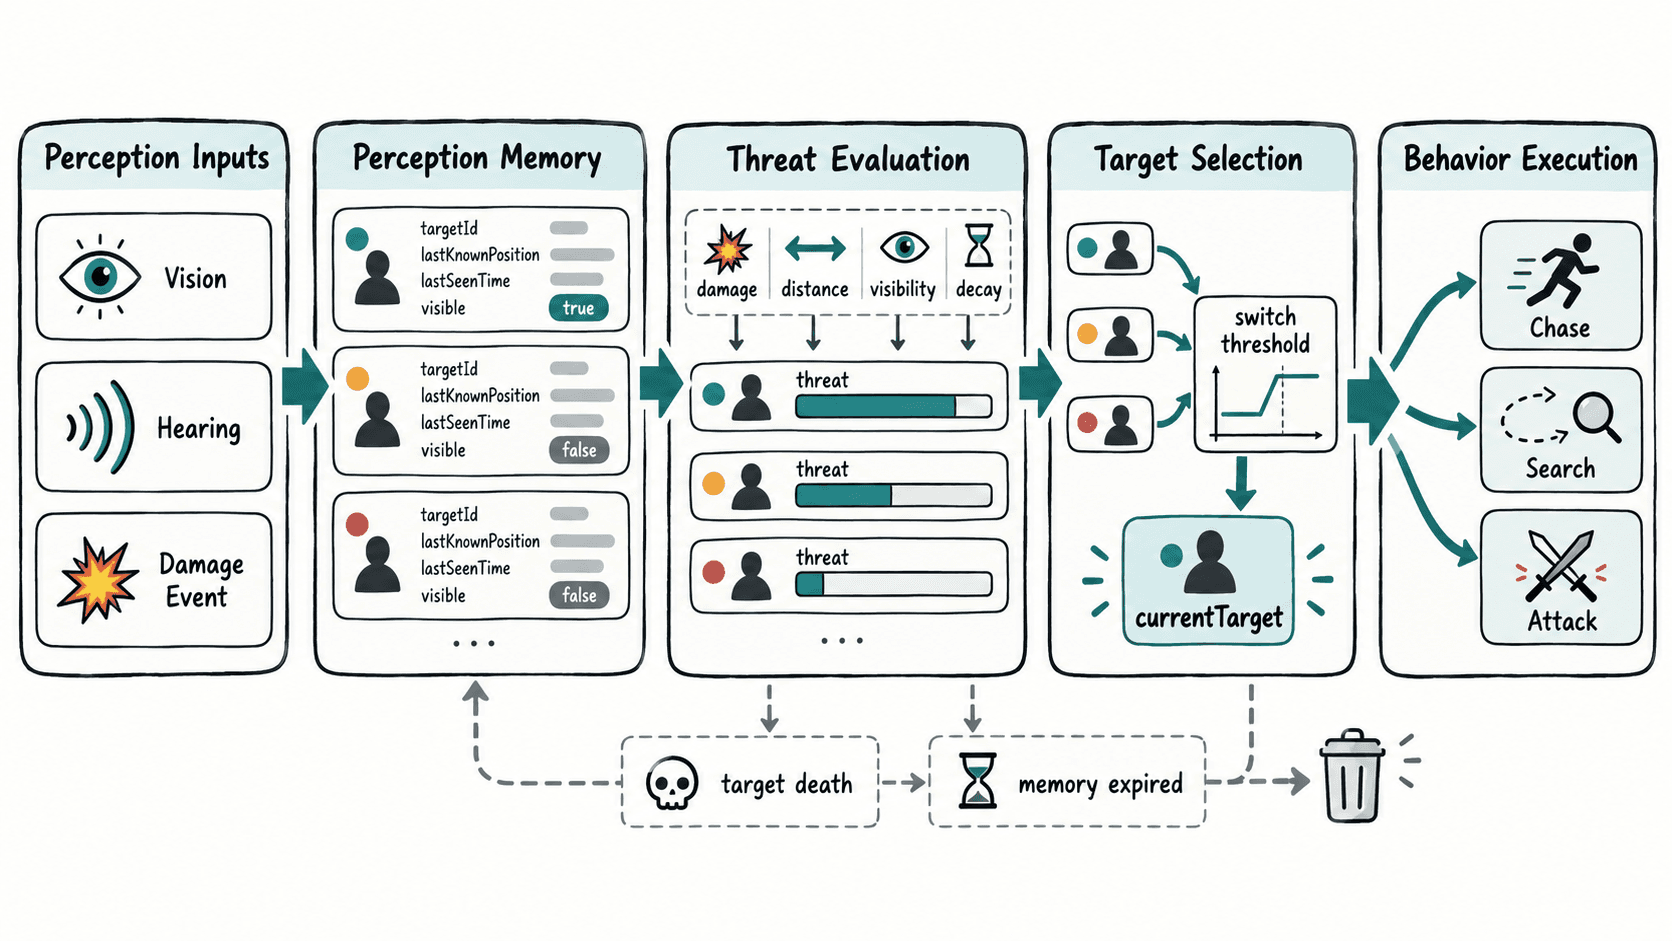
感知输入只描述刚刚发生了什么;记忆负责把离散事件整理成持续状态;仇恨计算负责回答每个候选目标有多值得关注;目标选择负责从多个候选中确定当前目标;行为层才决定追逐、搜索还是攻击。
每层只保存自己需要的数据
数据边界清楚,问题才容易定位。可以把一次目标选择中最关键的数据理解为三组状态。
| 数据层 | 典型内容 | 不应该负责的事情 |
|---|---|---|
| 感知记忆 | 最后位置、可见性、最后感知时间 | 决定最终攻击谁 |
| 仇恨记录 | 当前仇恨值、衰减信息、来源贡献 | 直接播放攻击动作 |
| 当前目标 | currentTarget、选中时间、切换依据 |
保存全部原始感知事件 |
例如玩家 A 对 NPC 造成伤害后,伤害事件先让记忆确认 A 是一个有效候选,再给 A 增加仇恨。目标选择器读取 A、B、C 的有效状态和仇恨值,决定是否继续保持原目标,还是切换到新的高优先级目标。
如果目标选择器每次都简单选择最高分,而两个目标的分数频繁交替,就会出现来回转身。解决这个问题应该调整目标选择层,例如要求新目标比当前目标高出一定阈值,而不是在感知层随意丢弃事件。
行为层消费结果而不是重新选目标
当 currentTarget 确定后,行为系统仍需要结合当前位置、视线和攻击距离决定下一步动作。目标可见且进入攻击范围时可以攻击;仍被记忆但不可见时,可以前往最后已知位置搜索;距离过远但目标仍有效时,则执行追逐。
这种设计的关键是行为层不再重新扫描所有敌人并自行挑选目标。否则目标选择器认为应攻击 A,而攻击行为内部又找到距离更近的 B,系统就会出现两个互相冲突的决策来源。
沿数据流定位异常
如果 NPC 明明看见玩家却完全没有目标,先检查感知事件是否进入记忆;如果记忆里有玩家但始终不锁定,再检查仇恨计算和候选过滤;如果已经正确锁定却不追逐或不攻击,问题通常已经进入行为层。
同样地,目标死亡后仍被持续追击,通常要沿反方向检查清理链路:死亡事件是否让候选失效、记忆是否移除、仇恨记录是否清除,以及目标选择器是否在当前目标失效后立即重新选择。
把整条链路画成数据流之后,目标系统就不再是一个难以解释的巨大条件判断,而是一组职责明确、可以逐层观测和替换的处理阶段。