
多人游戏与网络同步 / 系统课时
为什么网络收到的位置会跳
为什么网络收到的位置会跳
远端角色明明持续移动,客户端收到的位置却常表现为停住一会儿再突然前进。问题通常不是坐标计算错误,而是服务器快照离散发送、网络包不等间隔到达,再被渲染线程直接应用后形成了可见跳变。
学习目标
- 理解离散位置快照为什么不能直接等同于连续运动
- 区分固定发送间隔与不稳定到达间隔
- 通过时间记录判断跳动来自发送端、网络还是渲染应用方式
跳动来自两个离散过程
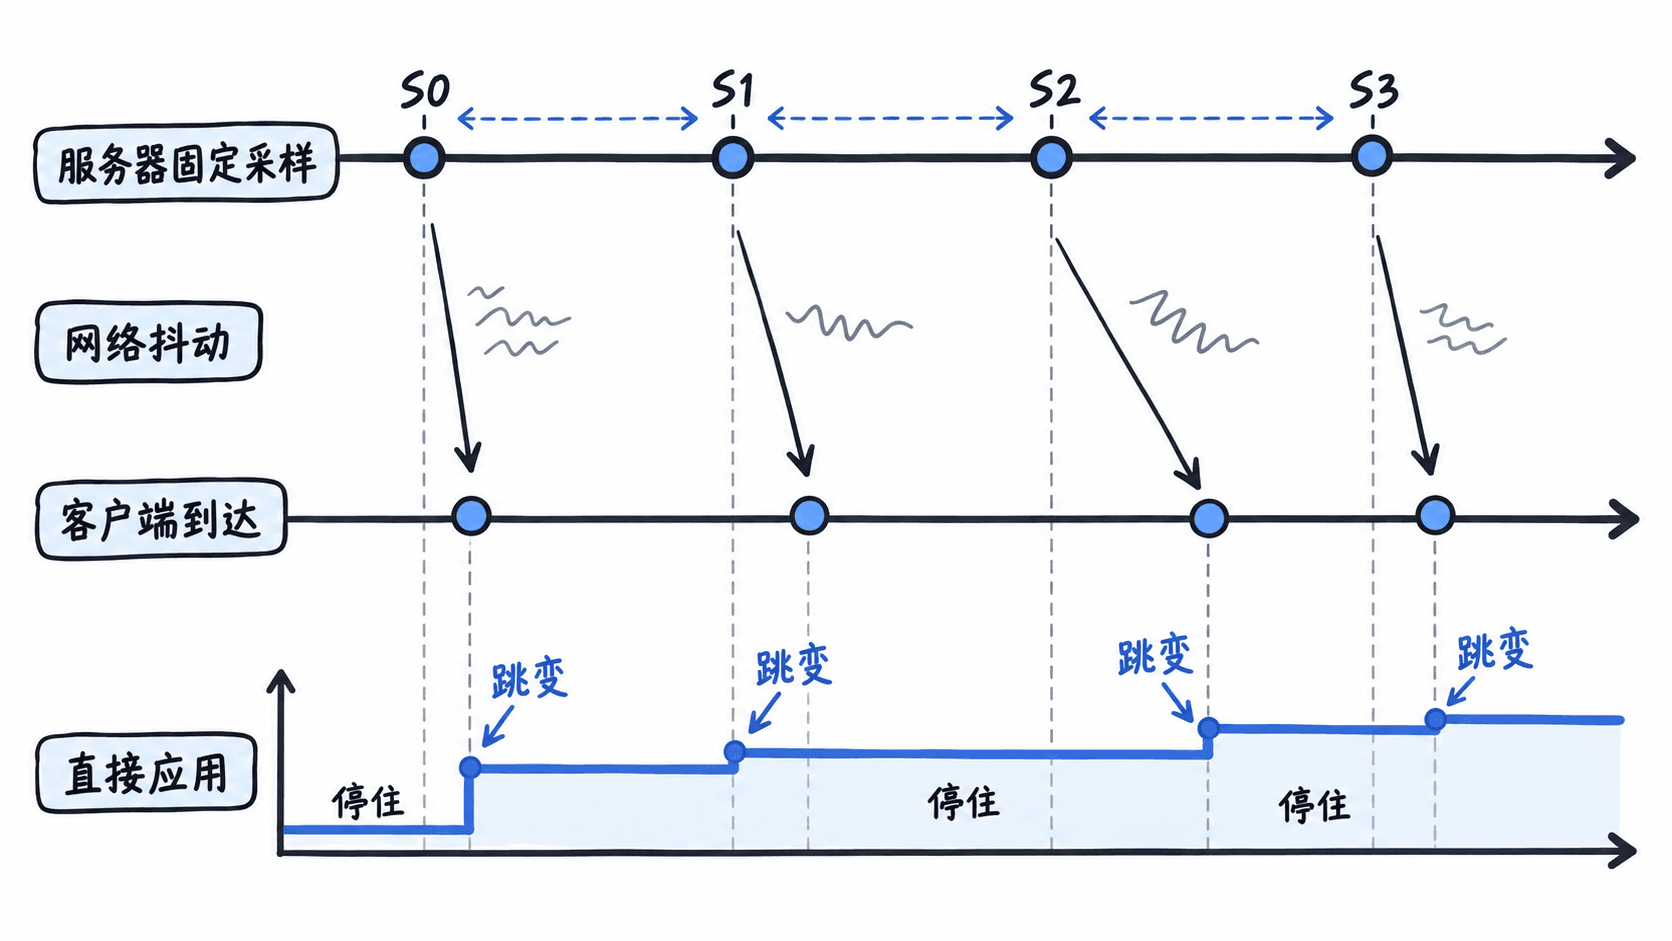
服务器不会连续传输角色位置,而是在网络 Tick 到来时采样一次状态。即使服务器每 50 ms 固定生成一个位置,客户端拿到的仍然只是一串离散坐标,而不是两点之间的连续轨迹。
网络又会改变这些快照的到达节奏。排队、链路抖动、调度延迟和丢包都可能让相邻快照间隔忽长忽短。渲染线程若在收到新包时直接把远端角色设置到新坐标,就会在两个快照之间保持旧位置,然后瞬间切换到新位置。
用一个最小模拟复现停住再跳
下面用四个已经到达客户端的位置包模拟最简单的情况。包中的位置均匀增加,但到达时间分别是 0、80、230 和 300 ms。渲染循环每 50 ms 读取一次“最近收到的位置”,不做任何插值。
packets = [
    (0, 0.0),
    (80, 1.0),
    (230, 2.0),
    (300, 3.0),
]

index = 0
latest_x = packets[0][1]

# 模拟渲染线程:每帧只使用当前已经收到的最新快照。
for render_ms in range(0, 351, 50):
    while index + 1 < len(packets) and packets[index + 1][0] <= render_ms:
        index += 1
        latest_x = packets[index][1]

    print(f"render={render_ms:>3} ms  x={latest_x:.1f}")
预期输出
render=  0 ms  x=0.0
render= 50 ms  x=0.0
render=100 ms  x=1.0
render=150 ms  x=1.0
render=200 ms  x=1.0
render=250 ms  x=2.0
render=300 ms  x=3.0
render=350 ms  x=3.0
从输出可以看到,100~200 ms 之间连续三个渲染采样都使用 x=1.0,到了 250 ms 才突然切到 x=2.0。如果角色在屏幕上持续可见,这种阶梯式更新就会被观察成卡住和跳动。
发送间隔和到达间隔不是一回事
排查时要同时记录服务器生成快照的时间和客户端收到快照的时间。若服务器相邻 Tick 始终接近固定间隔,而客户端接收间隔波动很大,问题主要位于网络传输或客户端接包调度;若服务器自身产生快照的间隔已经不稳定,则应先检查复制循环、服务器负载和 Tick 调度。
还要记录快照序号。仅看接收时间无法区分“延迟突然增加”和“中间丢了一份快照”:两种情况都会拉大客户端观察到的间隔,但后续处理方式并不完全相同。
直接写坐标会把时间误差变成画面误差
渲染帧率通常高于网络同步频率。以 60 FPS 为例,画面大约每 16.7 ms 更新一次,而网络位置可能几十毫秒甚至更久才变化一次。直接赋值意味着大量渲染帧重复显示相同位置,新快照到来时又一次性跨过两点之间的距离。
因此,“网络收到的位置会跳”并不意味着服务器发送了错误坐标。更常见的情况是数据本身正确,但它只描述若干离散时刻,客户端缺少把这些离散状态转换成连续视觉运动的缓冲与重建过程。
先测量再决定修法
定位跳动时,至少记录快照序号、服务器 Tick、客户端接收时间和位置变化量。固定发送、到达抖动明显时,通常需要在渲染层保留短暂缓冲并对历史快照做插值;服务器发送节奏本身不稳时,应先修复同步调度;连续快照缺失导致位置跨度过大时,则需要进一步处理丢包、外推或状态恢复。
关键是先把状态正确性和画面连续性分开:服务器负责提供可信的离散状态,客户端渲染层再根据这些带时间信息的快照恢复连续运动。只有先确定跳变发生在哪一段,后续插值、外推或预测才有明确依据。