
多人游戏与网络同步 / 系统课时
平滑校正怎样隐藏误差
平滑校正怎样隐藏误差
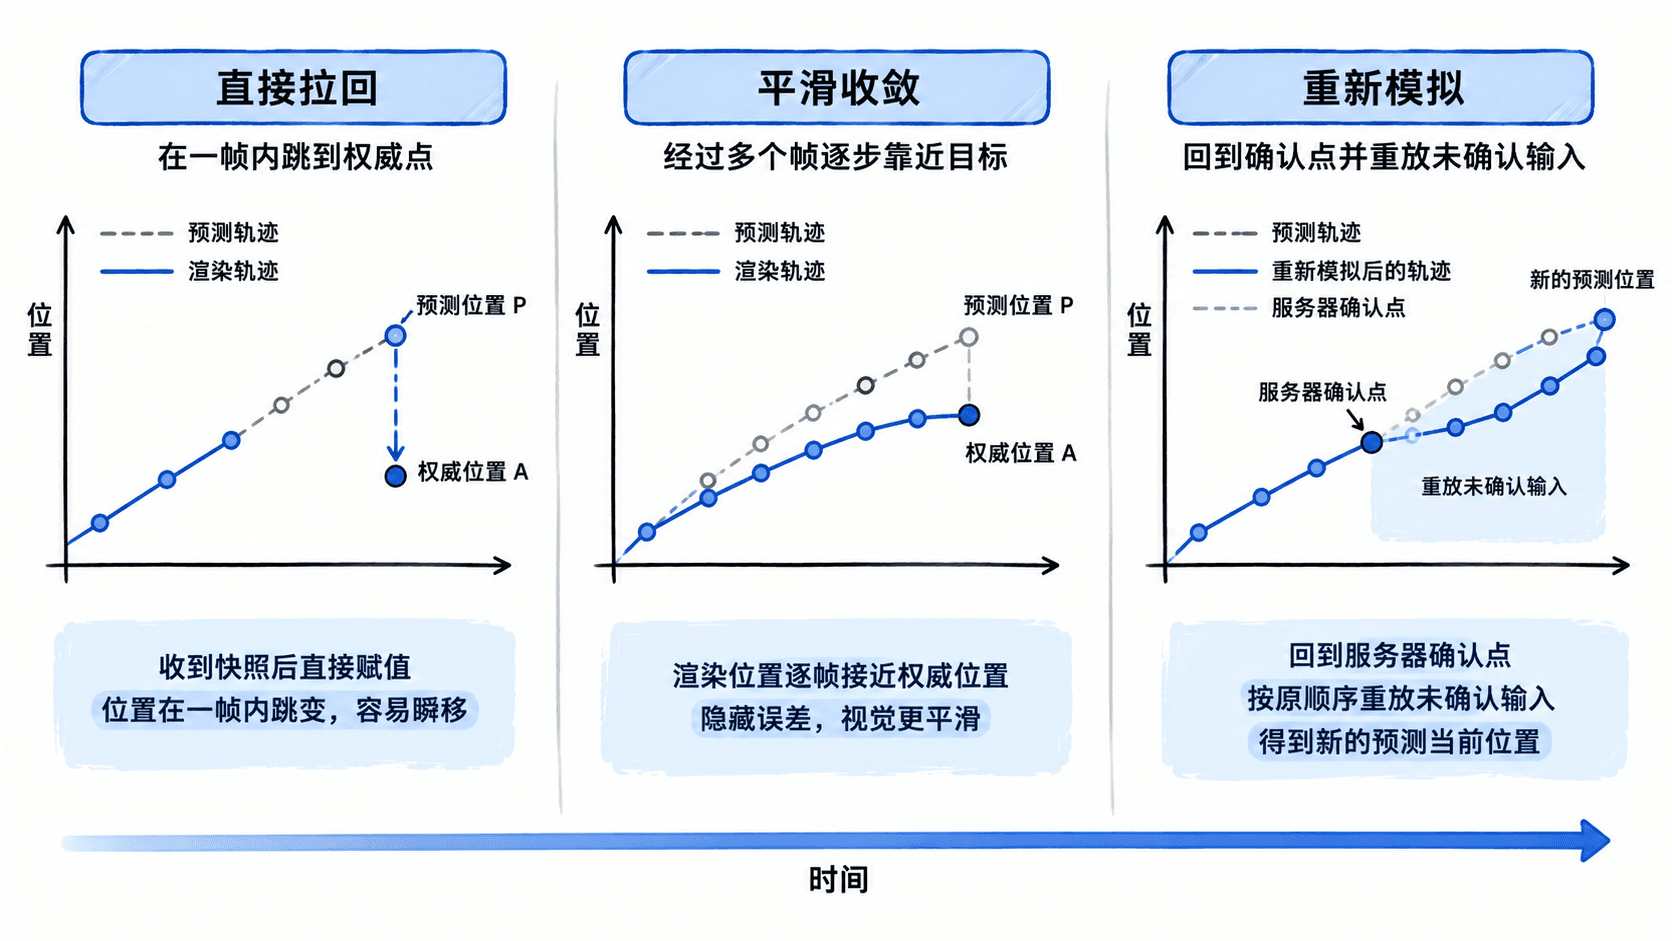
服务器校正的目标不是把误差“藏起来不管”,而是在恢复权威状态的同时避免把位置差一次性展示给玩家。实际实现通常在直接拉回、视觉平滑和从确认点重新模拟之间选择,并根据误差大小、对象类型和玩法约束组合使用。
学习目标
- 比较直接拉回、平滑收敛与重新模拟的差异
- 理解为什么平滑通常只作用于表现层而不是权威模拟状态
- 为本地玩家、远端玩家和大误差场景选择合适校正方式
三种校正方式解决的问题不同
直接拉回把当前状态立刻设为服务器值,优点是确定、简单、不会长期积累误差,缺点是视觉跳变明显。平滑收敛让渲染对象逐帧接近目标,适合小到中等误差,但如果连碰撞状态也一起慢慢追赶,就可能在客户端暂时出现“看起来还没撞到,逻辑上已经撞到”的不一致。
重新模拟更适合本地预测角色:先回到服务器确认的历史状态,删除已经确认的输入,再按原顺序重放尚未确认的输入,得到新的当前预测状态。它修的是“预测轨迹”,而不仅是把一个坐标拉近目标。
| 方式 | 主要优点 | 主要代价 | 常见用途 |
|---|---|---|---|
| 直接拉回 | 立即一致 | 容易瞬移 | 传送、越界、大误差 |
| 平滑收敛 | 视觉连续 | 会短暂保留表现误差 | 小误差、摄像机、角色模型 |
| 重新模拟 | 保留本地响应并恢复正确轨迹 | 需要输入历史与可重放模拟 | 本地可控角色 |
平滑应该追的是显示位置
常见做法是让游戏逻辑位置先接受校正,再维护一个独立的渲染位置。渲染位置每帧只向逻辑位置靠近一部分。这样碰撞、命中和服务器同步仍围绕正确状态运行,而玩家看到的模型不会在一个帧里完成整段位移。
下面的 Node.js 示例把 4.2 视为校正后的逻辑位置,让显示位置从 5.0 以 50% 的比例逐帧收敛:
let renderPosition = 5.0;
const simulationPosition = 4.2;
const smoothing = 0.5;

// 逻辑状态已经接受权威结果,这里只平滑视觉代理
for (let frame = 1; frame <= 4; frame += 1) {
  renderPosition += (simulationPosition - renderPosition) * smoothing;
  console.log(`frame=${frame}, render=${renderPosition.toFixed(3)}`);
}
预期输出:
frame=1, render=4.600
frame=2, render=4.400
frame=3, render=4.300
frame=4, render=4.250
这种指数式收敛实现简单,但它会不断逼近目标而不是在固定帧数精确到达。工程上通常还会设置最小误差阈值:误差足够小时直接贴合,避免浮点残差让对象长期细微抖动。
重新模拟负责修正预测轨迹
对本地玩家而言,仅做视觉平滑不能解决预测状态本身错误的问题。更常见的流程是:服务器快照带上“已处理到哪个输入”;客户端恢复该确认状态,移除已确认输入,然后重放剩余输入。若重放后的新预测位置与旧渲染位置有差异,再用表现层平滑隐藏这段差值。
这个过程要求客户端保留一小段输入历史,而且重放逻辑必须尽量与正常预测使用同一套移动规则。若重放和实时预测走两套代码路径,校正本身就可能继续制造新误差。
按对象和误差选择策略
本地可控角色通常最重视输入响应,因此优先考虑预测加重新模拟,小误差再用表现层平滑。远端玩家通常没有必要重放对方输入,更常见的是对服务器快照做插值;而传送、复活、掉出地图等离散事件应直接切到新状态,避免错误地播放一段并不存在的移动。
误差阈值也应与玩法尺度匹配。小误差可以平滑,中等误差可以较快收敛,大误差则直接拉回。关键不是追求“永不瞬移”,而是让视觉连续性服从正确性:一旦平滑会造成穿墙、命中位置错误或长时间偏离权威状态,就应该缩短平滑时间或立即校正。