
架构与系统设计 / 系统课时
读模型能来自多个业务对象吗
读模型能来自多个业务对象吗
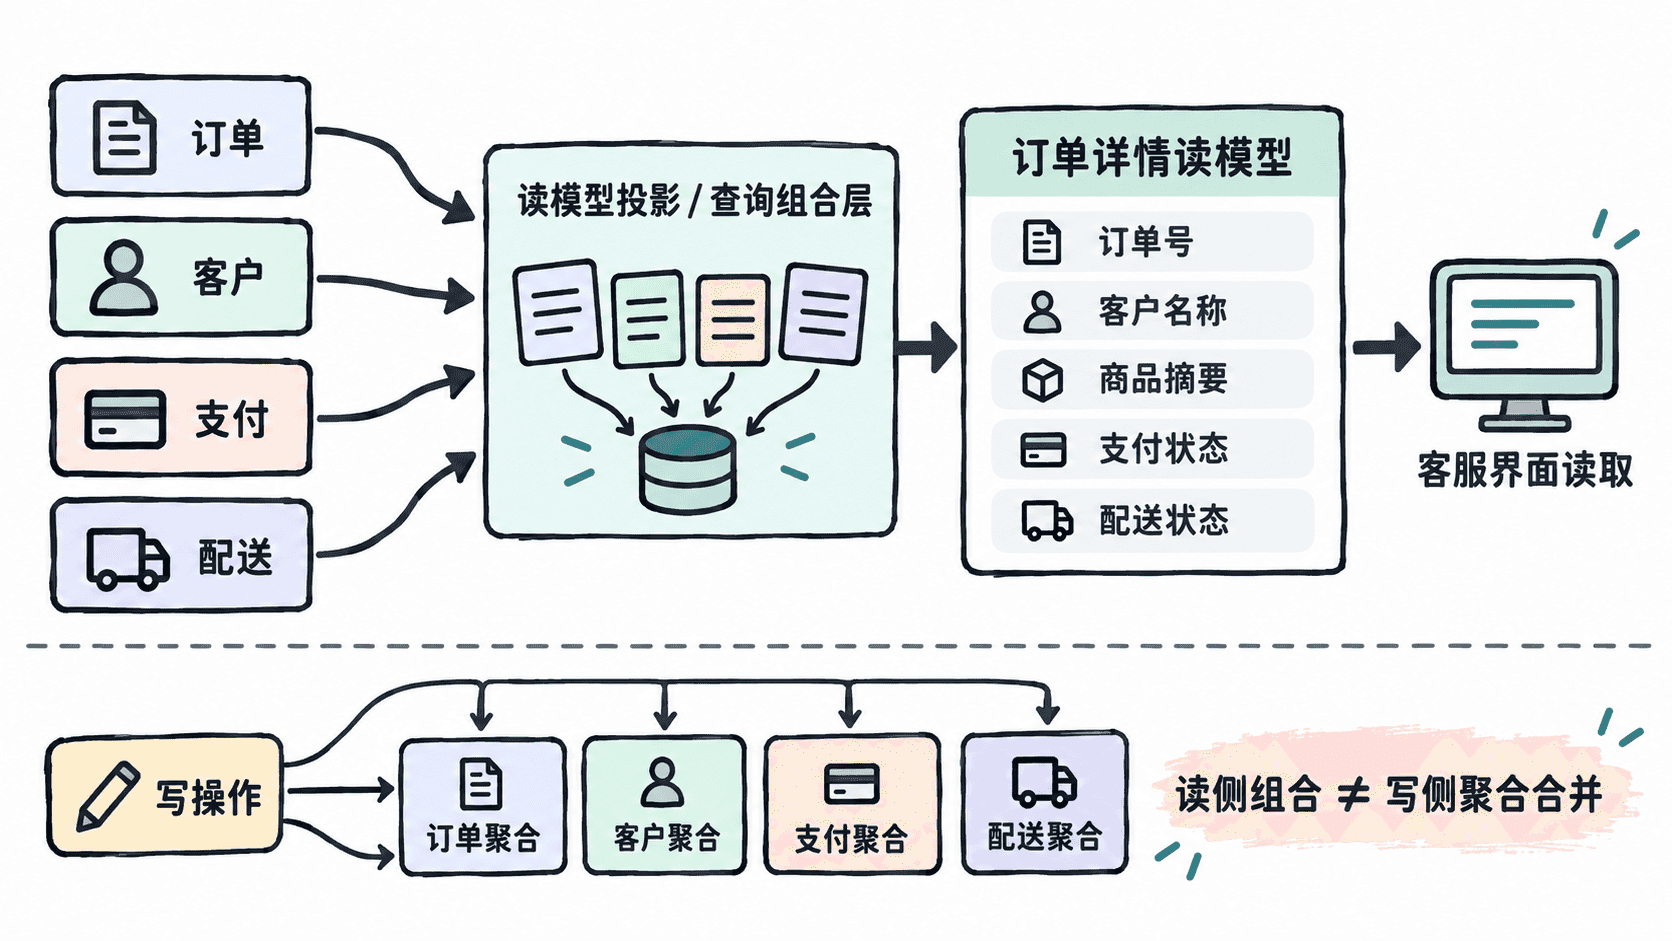
订单列表既想显示客户昵称,又要显示商品摘要、支付状态和配送进度时,很容易误以为必须先加载一整套领域对象关系。读模型并没有这种限制:它可以围绕一个查询问题组合多个数据来源,而写模型仍然保持清晰的业务边界。
学习目标
- 理解读模型为什么可以组合多个聚合或业务数据来源
- 区分面向业务规则的领域模型与面向查询问题的读模型
- 判断组合读模型需要承担的数据一致性与时效边界
读模型围绕问题组织数据
领域模型首先服务于业务规则和一致性边界。例如订单、客户、商品和支付可能分别属于不同聚合,甚至由不同服务维护。为了查看一条订单详情,并不意味着这些对象在领域模型里就应该组成一个巨大的对象图。
读模型关注的是另一个问题:用户此刻想知道什么? 如果客服打开订单详情时需要同时看到客户名称、商品标题、支付状态和物流进度,那么一个订单详情读模型完全可以把这些信息组合成一次查询结果。
例如一个面向客服界面的读模型可以表现为:
{
  "orderId": "<ID>",
  "customerName": "林晓",
  "itemsSummary": "机械键盘 × 1",
  "paymentStatus": "PAID",
  "shipmentStatus": "IN_TRANSIT"
}
这里的字段可能来自不同业务对象,但它们因为共同服务于“查看当前订单处理情况”这个查询目标,而被组合到同一个读取结果中。这个结构不要求领域层存在一个同时拥有客户、商品、支付和物流对象的超级订单实体。
不要为了查询方便扩大聚合
如果把查询需求直接映射成领域对象关系,团队很容易得到“订单包含客户,客户包含地址,订单项包含商品,商品又包含库存”的庞大对象图。读取一张列表就可能触发大量对象加载,而更严重的问题是,聚合边界会被页面需求牵着走。
聚合边界应该由业务不变量决定。例如“订单确认后总金额不能被随意修改”属于订单内部规则;“客户当前昵称是什么”通常不需要和订单金额在同一个事务中保持强一致。因此,仅仅因为详情页同时展示这两类数据,并不足以把它们放进同一聚合。
读模型则可以选择保存客户名称的快照、维护事件投影,或者在查询时组合多个来源。哪一种实现更合适,要看查询频率、延迟要求、数据规模和系统边界,而不是看领域对象之间能否建立引用。
组合之后要明确时效语义
多个来源能够组合,并不意味着一致性问题消失了。如果订单状态刚变为“已支付”,而读模型中的支付状态几秒后才更新,用户短时间看到旧值可能是正常的最终一致性,也可能是不可接受的业务风险。
因此,在事件风暴中发现组合读模型后,应继续确认哪些字段允许延迟、哪些字段必须实时,以及界面是否需要标明数据更新时间。对于仅用于浏览和搜索的列表,短暂延迟通常更容易接受;对于决定“是否退款”“是否放货”的信息,则需要更严格地确认权威来源和校验时机。
列表和详情可以有不同模型
同一个业务对象也不必只有一种读模型。订单列表关心订单号、客户名称、金额和状态,适合小而扁平的数据结构;订单详情可能还要展示订单项、支付记录和物流节点,需要更丰富的组合结果。
如果为了复用而强迫列表和详情加载同一套完整结构,通常会带来多余查询和耦合。更自然的做法是按使用场景设计多个读模型,让每个模型只回答一个明确问题。
事件风暴中发现读模型时,因此不必先问“它属于哪个聚合”,而应先问“谁要用它回答什么问题”。只要数据来源、时效和权限边界能够被清楚定义,一个读模型完全可以横跨多个业务对象,同时保持写侧领域模型的小而明确。