
FPGA 与数字 IC 设计 / 系统课时
完成一次完整故障闭环
完成一次完整故障闭环
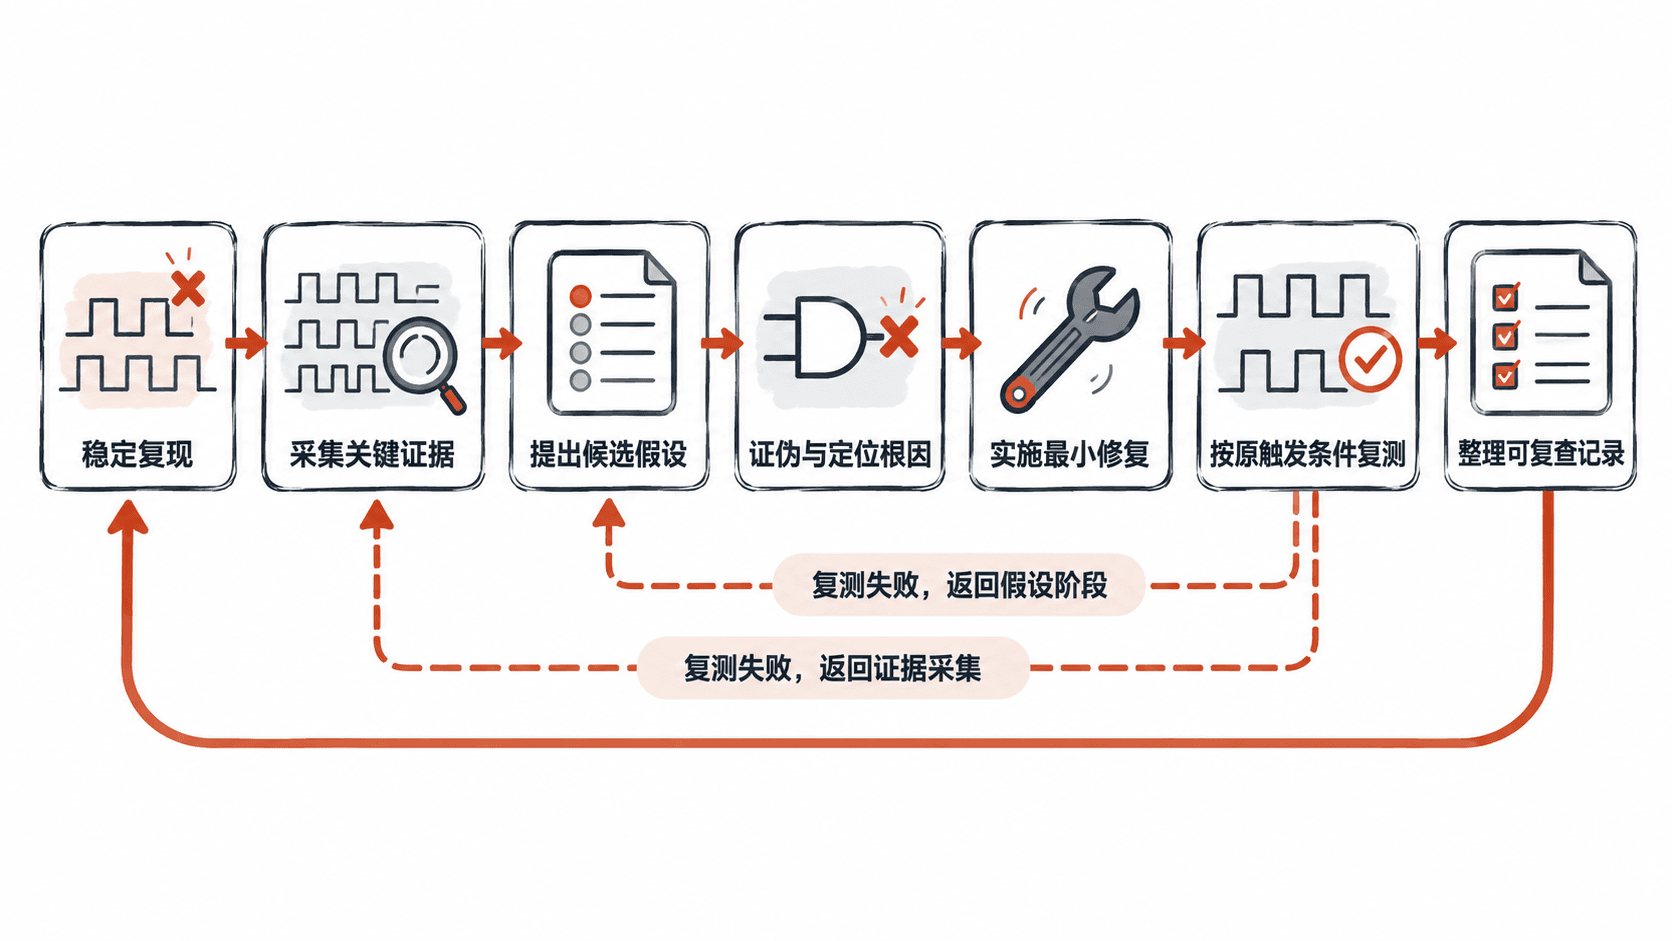
本课把一次数字逻辑故障拆成可执行的闭环:先稳定复现,再按影响范围采集证据,用证据筛掉错误假设,完成最小修复,最后用同一触发条件复测并整理记录,让调试结果能够被别人复查和复用。
学习目标
- 能建立从现象到根因再到验证的完整故障链
- 能用最少但关键的信号形成可复查的证据包
- 能区分“修好了”与“证明修复有效”之间的差别
先把故障变成可重复实验
故障闭环最怕每次复现条件都不同。先固定输入数据、时钟频率、复位方式、工作温度和触发条件;如果无法全部固定,就优先固定与故障直接相关的变量。
一个合格的复现记录至少包含发生条件、实际现象和期望现象,并明确第一次观察到异常的时间点。动态值如时间戳、进程号或采样编号应以实际实验值为准,这些值不是根因本身。
证据采集只抓能改变判断的信号
不要为了“保险”把所有内部信号全部采进来。先按照故障机理选择最小证据集:输入侧看触发条件,组合逻辑侧看关键中间值,时序逻辑侧看状态寄存器、使能和复位,接口侧看请求、响应及握手关系。
每个证据都应该回答一个问题。例如“异常边沿前输入是否稳定”“状态是否提前变化”“使能是否误触发”。如果一个信号不能帮助区分两个候选根因,它通常不是第一优先级观测点。
下面用一个简单的实验记录脚本汇总关键事件。它不是板卡控制程序,而是独立的结果整理示例,用于保证每次复测记录具有一致结构,并显式比较修复前后的实际结果。
from dataclasses import dataclass

@dataclass
class DebugRun:
    run_id: str
    trigger: str
    expected: str
    pre_fix_actual: str
    post_fix_actual: str
    root_cause: str

def print_report(run: DebugRun) -> None:
    # 修复是否有效必须由复测结果与期望值比较得到。
    verified = run.post_fix_actual == run.expected
    status = "PASS" if verified else "FAIL"

    print(f"run={run.run_id} status={status}")
    print(f"trigger={run.trigger}")
    print(f"expected={run.expected}")
    print(f"pre_fix_actual={run.pre_fix_actual}")
    print(f"post_fix_actual={run.post_fix_actual}")
    print(f"root_cause={run.root_cause}")
    assert verified, "post-fix behavior still differs from expected"

if __name__ == "__main__":
    # 两次 actual 应来自相同触发条件下的修复前后观测。
    run = DebugRun(
        run_id="<ID>",
        trigger="input changes near clock edge",
        expected="state remains in WAIT",
        pre_fix_actual="state enters DONE unexpectedly",
        post_fix_actual="state remains in WAIT",
        root_cause="unsynchronized asynchronous input",
    )
    print_report(run)
预期输出:
run=<ID> status=PASS
trigger=input changes near clock edge
expected=state remains in WAIT
pre_fix_actual=state enters DONE unexpectedly
post_fix_actual=state remains in WAIT
root_cause=unsynchronized asynchronous input
其中 <ID> 会因实际运行不同而不同。这里的 PASS 不是人工填写的修复标记,而是由 post_fix_actual 与 expected 比较得到;如果修复后的行为仍与期望不一致,断言会直接失败。这样同一份记录同时保存修复前现象和修复后证据,不会出现“状态写成已修复,但实际结果仍是故障现象”的矛盾。
用假设矩阵筛选根因
拿到证据后,把候选根因按“能解释什么、当前证据是否支持、下一步怎么证伪”逐一检查。典型候选可分为输入异常、组合逻辑错误、状态转移条件错误、建立保持问题、复位异常和测试环境误差。
好的假设必须能产生可观察预测。例如怀疑异步输入时,可以预测故障是否集中发生在输入靠近时钟边沿的窗口;怀疑转移条件时,则应能在 next_state 变化中直接看到条件提前成立。无法产生可验证预测的“感觉”不应继续占据排查主线。
修复后必须回到原故障条件
修复验证至少包含三次比较:原条件下故障是否消失,正常条件下功能是否保持,以及边界条件下是否出现新的异常。不要只换一组输入后得到一次 PASS 就结束,因为那只能证明另一条路径正常。
对状态机、握手、计数器等时序问题,最好使用原始故障触发窗口重新施加压力,并持续观察关键状态。若问题依赖时间窗口,还应覆盖比原故障更宽的边界范围,避免修复只是把故障窗口推迟。
把一次调试整理成可复查记录
最终记录不需要写成流水账。保留能够重建判断链的内容即可:故障现象、复现条件、观测信号、关键波形时间点、候选假设、排除证据、根因、修复改动、复测结果和遗留风险。
一次完整故障闭环的标准不是“代码已经改了”,而是任何工程师拿到记录,都能回答三个问题:故障为什么出现、证据为什么支持这个根因、为什么相信修复不会只在这一次实验中有效。做到这三点,调试才真正从一次性救火变成可复用的工程能力。