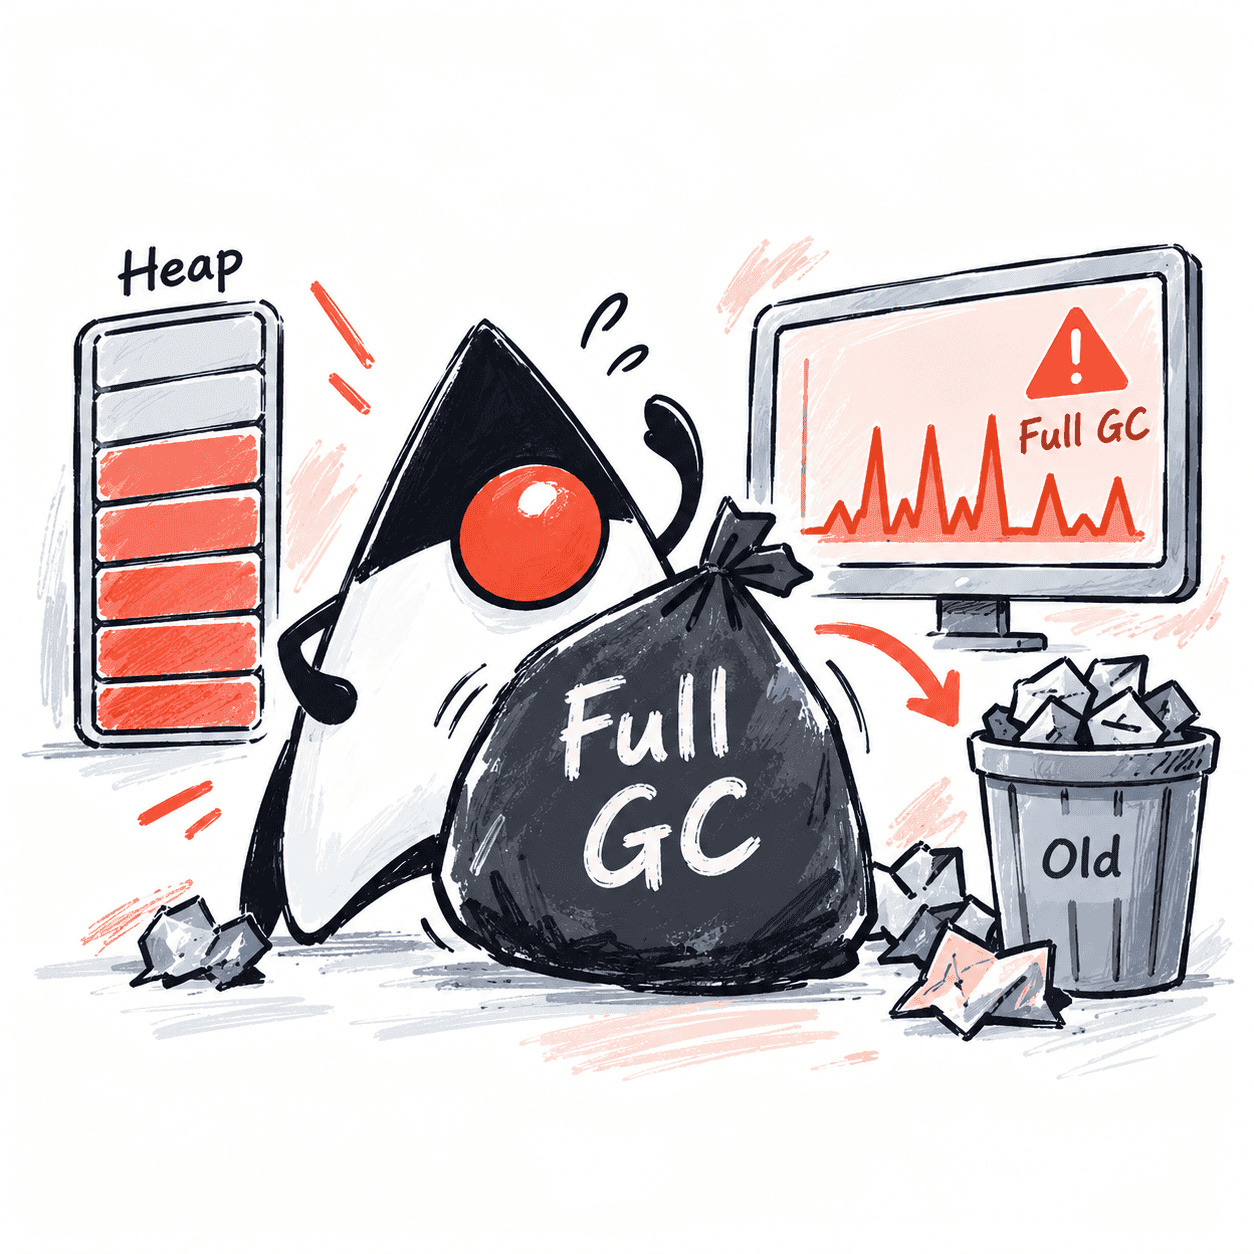
JVM Full GC 频繁怎么排查
Java 服务出现内存告警、延迟抖动或 Full GC 连续发生时,应先确认触发原因和回收效果,再区分容量不足、晋升失败、元空间压力与对象泄漏,最终形成可验证的处置结论。
技术文章 · 技术实践
READ / ARTICLES
从一个具体问题出发,读懂原理,也读懂工程中的取舍。
全部方向 · 208 篇文章
Java 服务出现内存告警、延迟抖动或 Full GC 连续发生时,应先确认触发原因和回收效果,再区分容量不足、晋升失败、元空间压力与对象泄漏,最终形成可验证的处置结论。
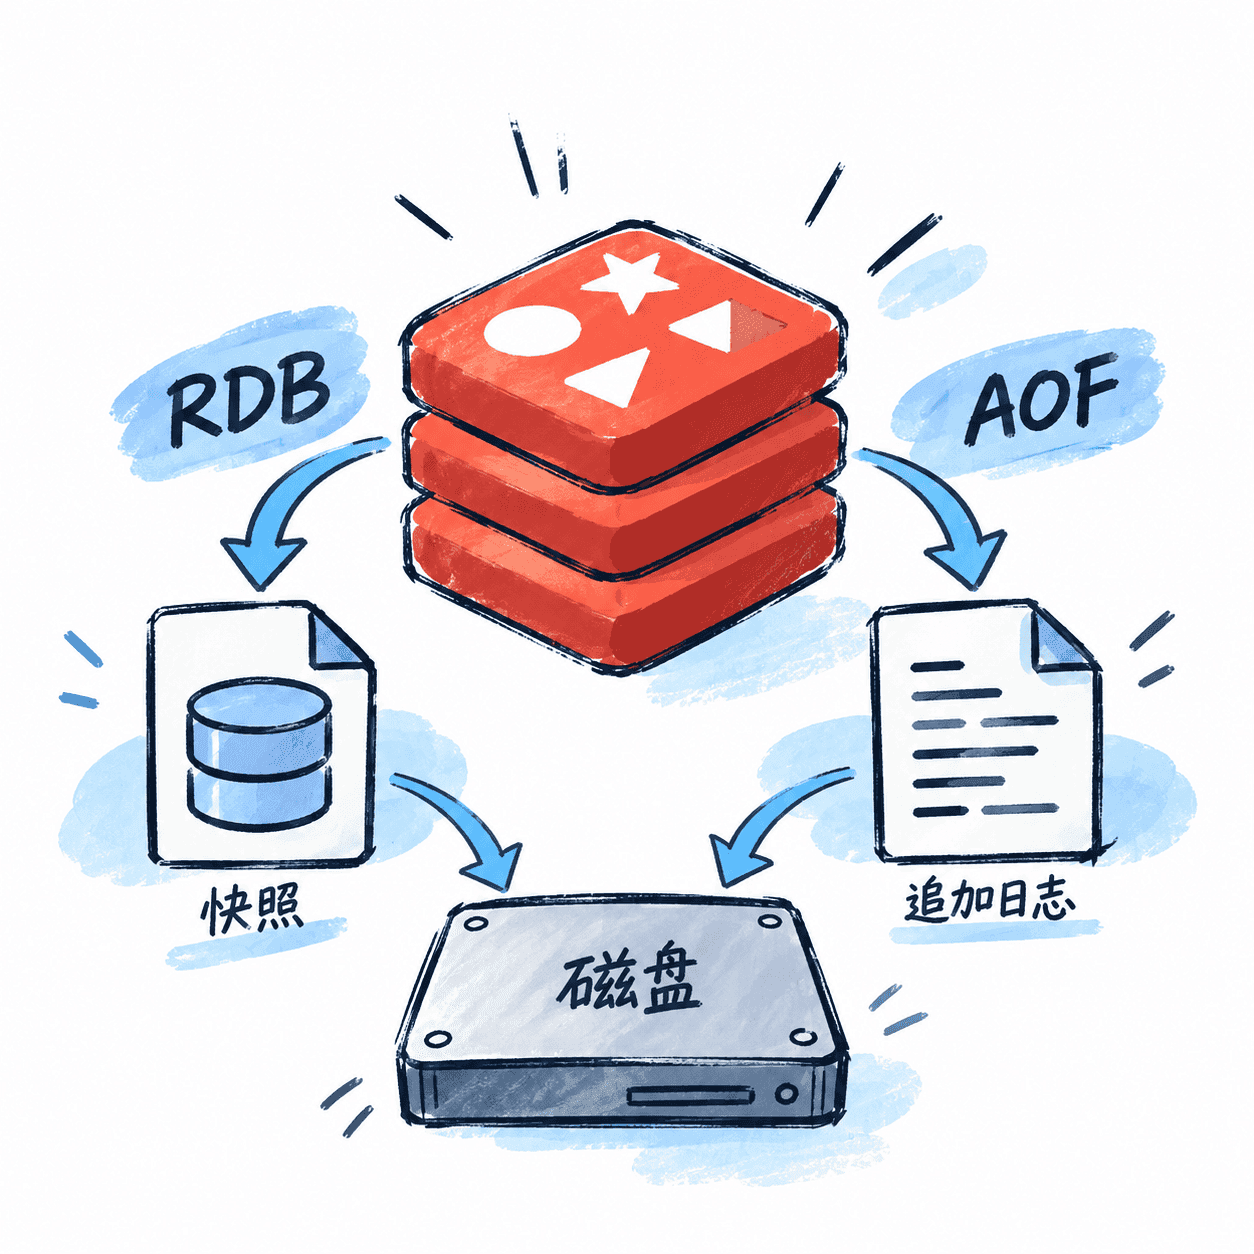
面对 Redis 进程退出、主机故障或磁盘异常时,哪些写入能够留下来取决于 RDB、AOF 与 fsync 的不同落盘路径;读完后可据此判断数据丢失窗口并制定生产配置。
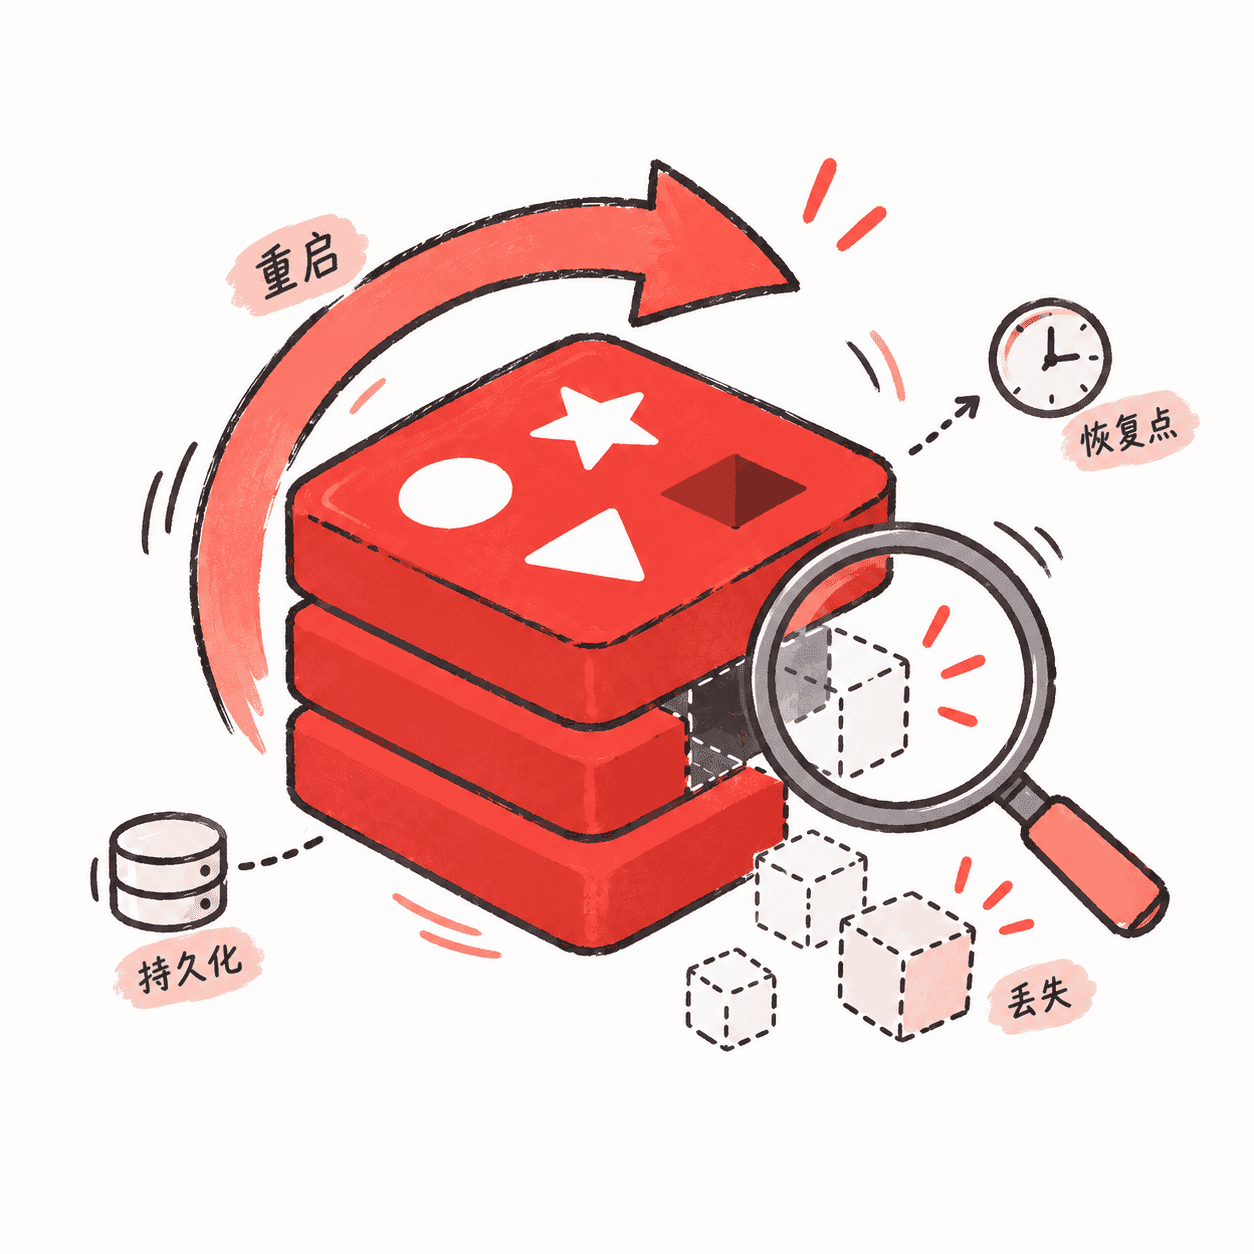
Redis 重启后发现 key 数量下降、数据回退或内容缺失时,可按启动加载来源、持久化文件、恢复时间点和故障链逐层定位,最终判断是持久化缺失、恢复滞后还是误操作导致的数据损失。
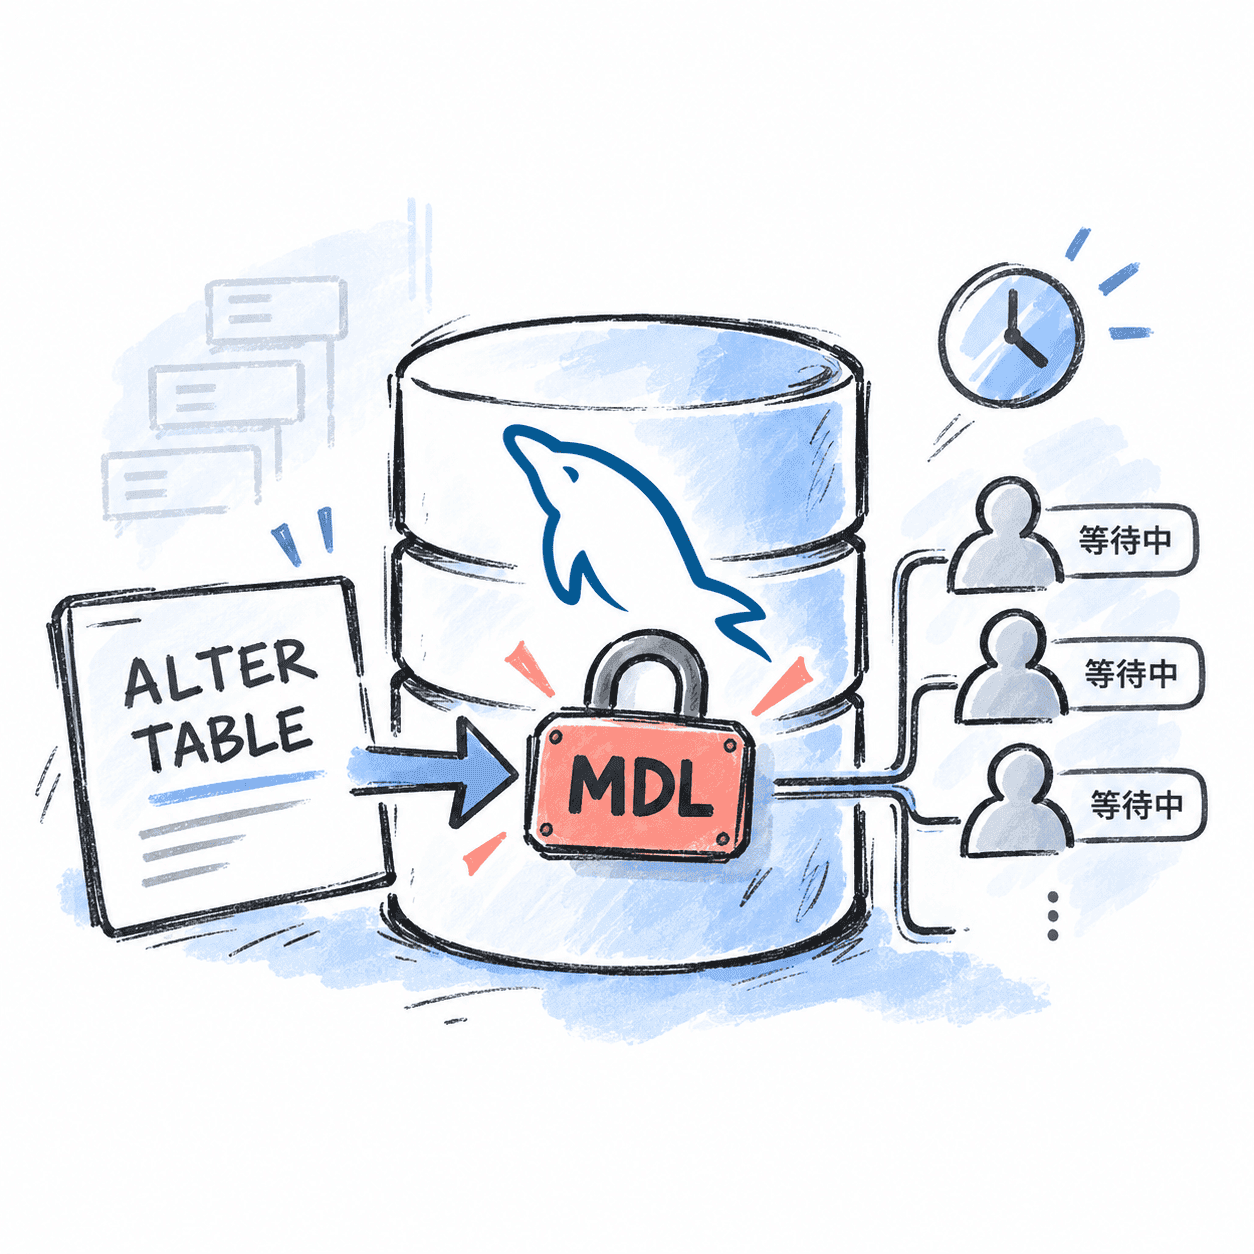
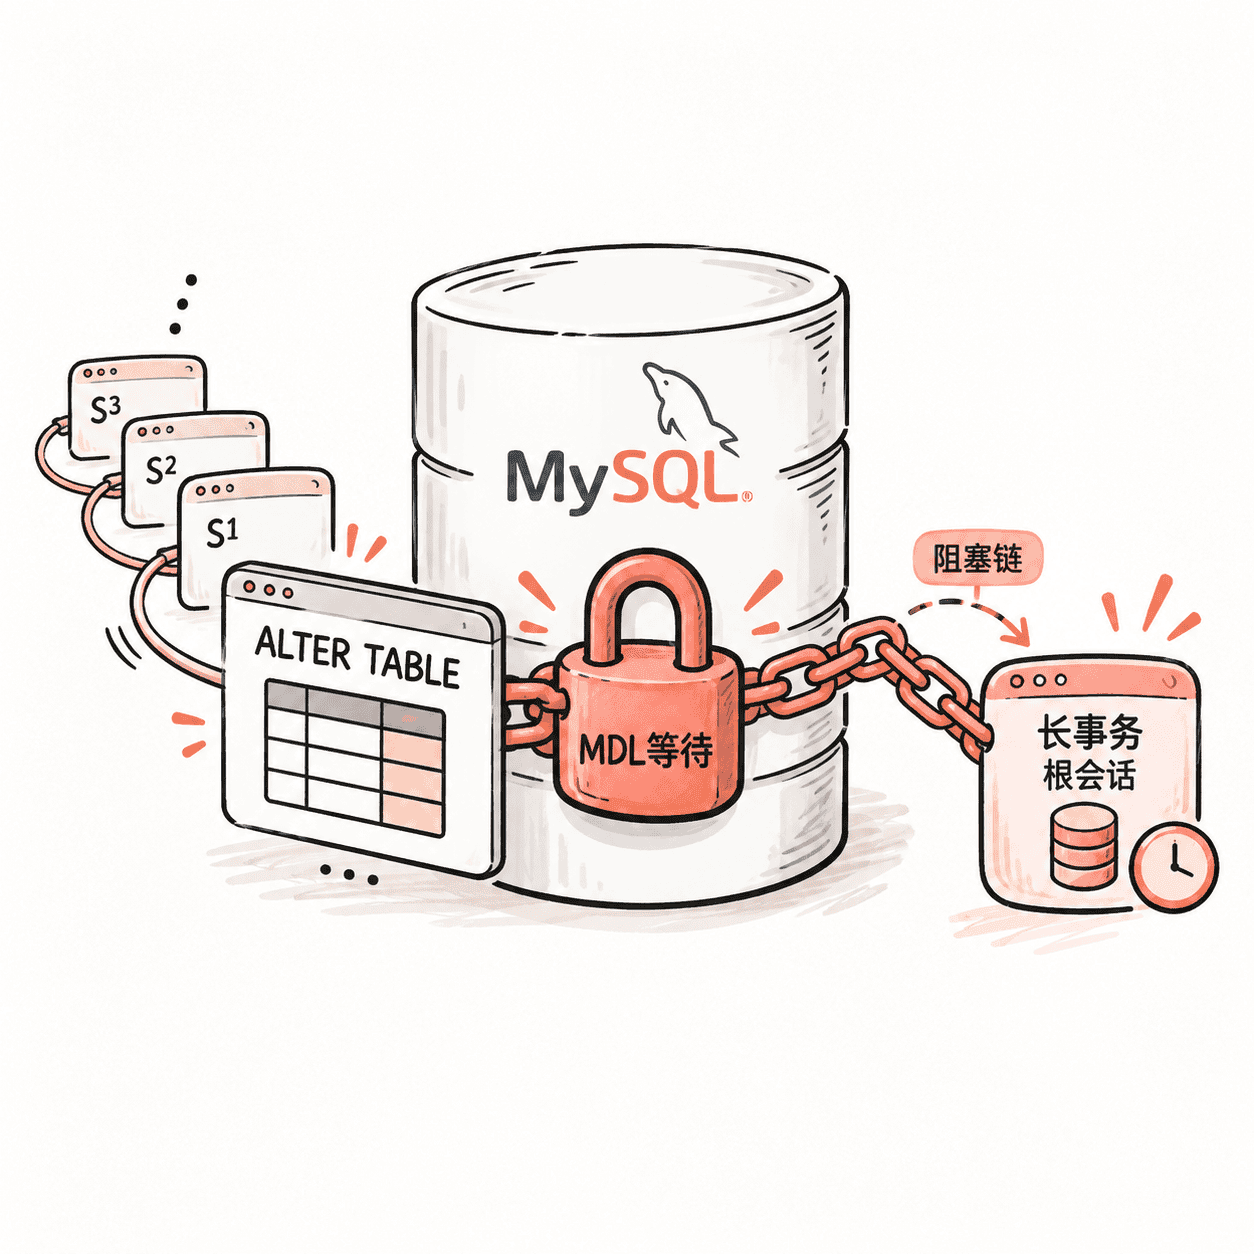
大表 ALTER 明明使用 INPLACE 或 LOCK=NONE,业务仍可能突然卡在元数据锁;理解 DDL 起止阶段、长事务与等待队列后,就能判断阻塞发生在哪里以及该先处理谁。
ALTER TABLE 发布时如果迟迟不返回并伴随连接堆积,先区分 MDL 等待与真实执行,再沿阻塞链定位长事务和根会话,最后决定终止谁、如何止血并验证恢复。
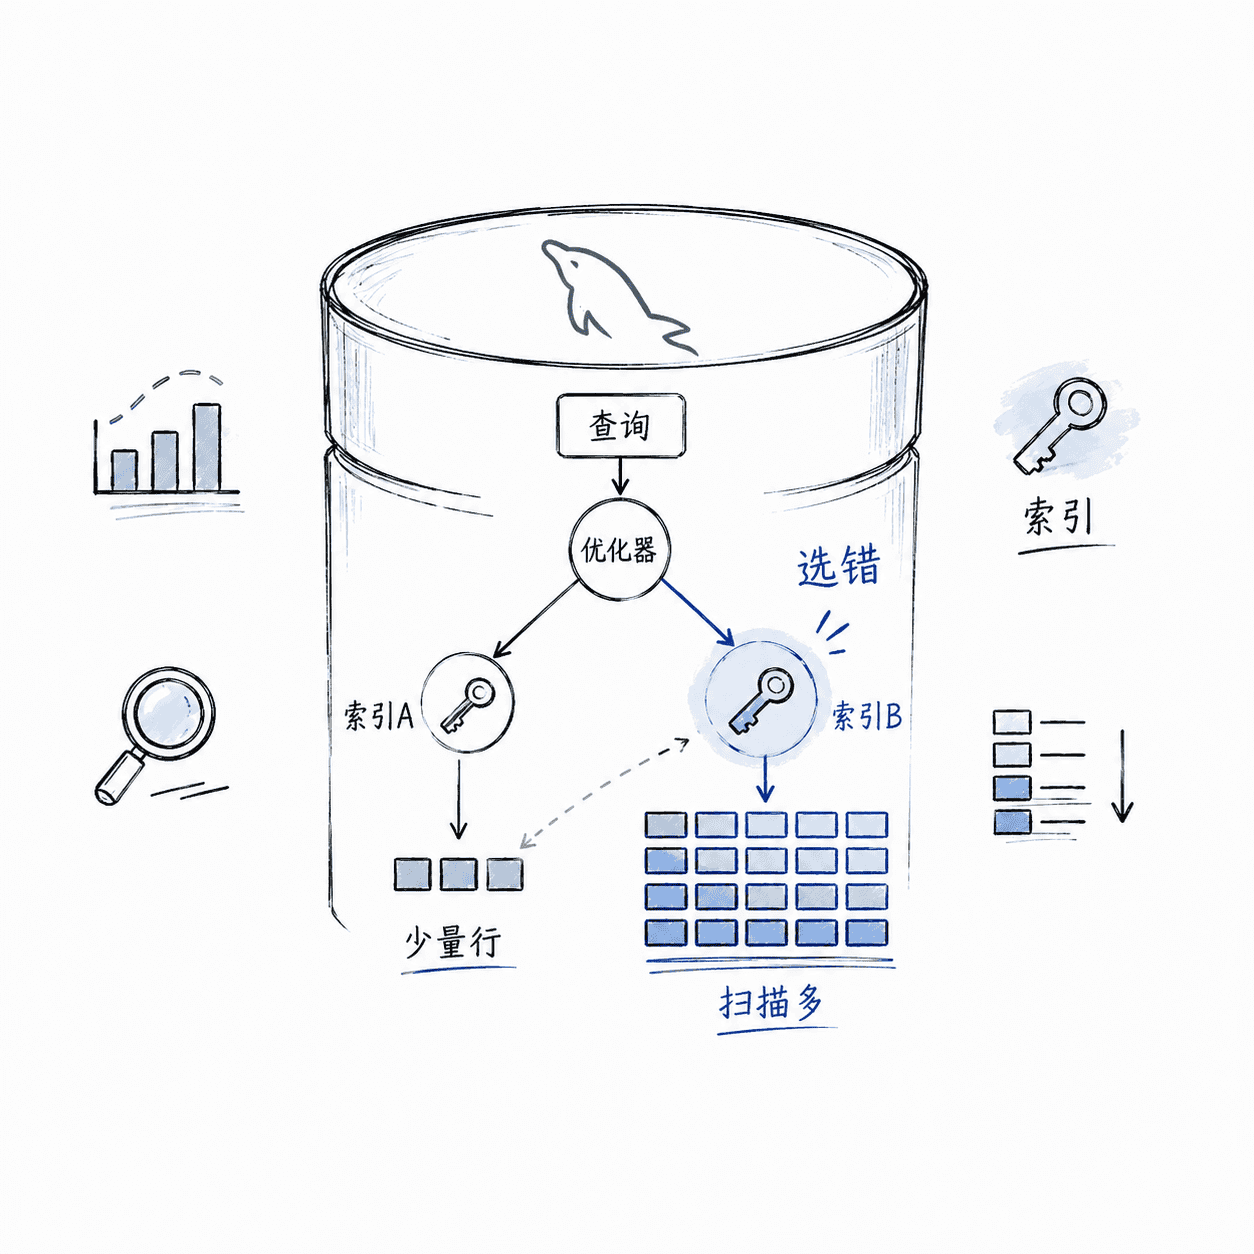
同一条 SQL 明明有更快的索引,MySQL 却可能选择扫描更多的数据;理解估算行数、数据分布、回表与排序成本后,你可以判断它为何这样选,并决定该修统计信息、改索引还是临时干预计划。