
服务注册与分布式协调 / 技术文章
ZooKeeper 频繁选主为何导致不可写
ZooKeeper 集群频繁进入选主时,常伴随连接重建、写请求超时或短暂不可用。下面面向 SRE、平台工程师和中间件运维人员,按“确认选主—检查多数派—定位节点抖动—验证恢复”的顺序排查,最终判断问题来自网络、进程暂停、磁盘还是配置。
先确认故障是否真的在选主
不要看到客户端报 ConnectionLoss 或写超时就直接归因于 Leader 选举。先在每个 ZooKeeper 节点检查状态,确认同一时刻是否只有一个 Leader,其余存活节点为 Follower,以及角色是否在短时间内反复变化。
<PATH>/bin/zkServer.sh status预期输出
Mode: leader其他健康节点的关键行应为 Mode: follower。<PATH> 是 ZooKeeper 安装目录,实际输出还可能包含配置路径等信息。若多次采样时节点频繁在 leader、follower 与无法返回状态之间切换,再结合服务端日志中重复出现的 LOOKING、LEADING、FOLLOWING 状态变化,才有充分证据指向选主抖动。
同时核对进程重启、容器驱逐、OOM 和主机长时间停顿。客户端会话过期本身不会让整个集群重新选主,真正要确认的是 ZooKeeper 服务端之间的仲裁通信是否被破坏。
看清选主为什么会导致不可写
ZooKeeper 写事务由 Leader 发起提议,并获得多数派确认后才能提交。客户端即使连接到 Follower,写请求也会转交给 Leader;因此“Leader 进程还活着”不等于“集群还能写”,只要 Leader 无法持续获得多数派确认,新写事务就无法正常提交。
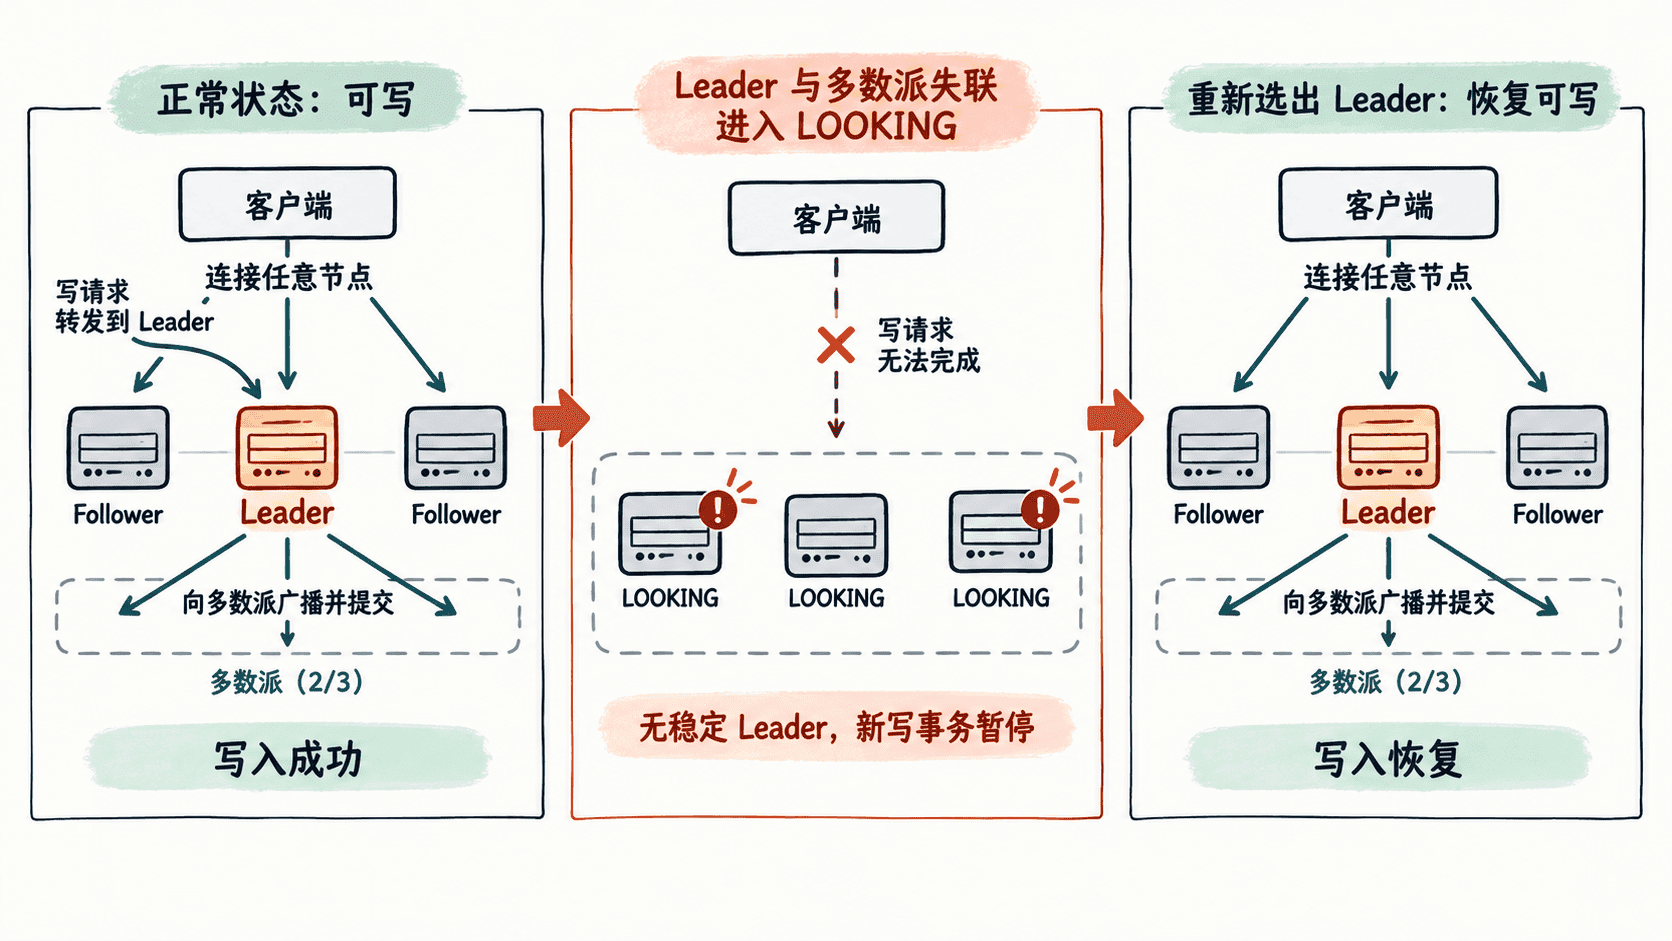
三节点集群至少需要两台服务器形成多数派,五节点至少需要三台。若只剩一台可用,即使它原先是 Leader,也不能独立确认写事务。排查时必须把“有没有 Leader”和“Leader 能否持续获得多数派确认”分开判断。
按顺序定位触发选主的证据
先对齐故障时间窗,再看角色变化,不要一上来就调大 tickTime、initLimit 或 syncLimit。如果选主前后伴随进程退出、OOM、容器重启或宿主机重启,优先处理进程稳定性;进程始终存活时,再检查节点间网络与暂停时间。
网络侧检查选举端口和仲裁端口是否存在丢包、重传、连接重置、防火墙会话回收或跨可用区抖动。客户端端口可用不能证明节点间通信健康,因为客户端连接与服务器仲裁不是同一条链路。
JVM 与主机侧关注长 GC 暂停、CPU 打满、调度延迟和内存压力。足够长的 Stop-The-World 暂停会让其他服务器把节点视为失联;若发生在 Leader 上,往往直接触发重新选主。
存储侧检查事务日志目录的延迟、磁盘队列和 fsync 抖动。慢盘未必让进程退出,却可能拖慢事务、心跳与同步,最终演化为超时和角色切换。
修复最常见的四类根因
网络抖动时,先恢复服务器间双向稳定连通,确认选举端口和仲裁端口没有被安全策略、NAT、负载均衡或连接跟踪异常干扰。ZooKeeper 节点间不应依赖会主动回收长连接的中间层。
JVM 或 CPU 暂停时,检查堆是否接近上限、是否存在突发大对象分配、宿主机是否超卖,以及容器 CPU 限额是否造成严重节流。修复后要确认暂停时间不再与选主时间点重合。
磁盘延迟高时,优先保证事务日志所在存储的稳定低延迟,避免与高吞吐批处理或其他随机 I/O 竞争。比起利用率百分比,持续高等待时间和尖峰 fsync 延迟更能解释写停顿。
配置问题则核对所有节点的 server.x 成员列表、节点自身 myid、地址和端口。滚动变更时尤其要避免成员配置不一致;超时参数应基于已确认的网络 RTT、GC 暂停和磁盘延迟调整,而不是靠猜测掩盖故障。
修复后验证写能力与稳定性
角色恢复只是第一步,还要用受控写入验证多数派提交链路。选择专用探针命名空间,以唯一 ID 创建测试节点,读取成功后立即删除,避免与业务路径冲突。
printf 'create /write-probe-<ID> ok\nget /write-probe-<ID>\ndelete /write-probe-<ID>\nquit\n' | <PATH>/bin/zkCli.sh -server <HOST>:<PORT>预期输出
Created /write-probe-<ID>
ok<HOST>、<PORT>、<PATH> 与 <ID> 需要替换为实际值,CLI 还可能打印连接日志和节点元数据。若创建与读取持续成功,且观察期间各服务器角色不再反复变化,才能认为写链路恢复;若只读正常而写入仍超时,应继续检查 Leader 到多数派的仲裁链路与持久化延迟。
建立能提前暴露抖动的监控
恢复后持续观察 Leader 变更次数、进程重启、节点间连接重置、GC 最长暂停、CPU 节流、事务日志磁盘延迟、客户端连接失败率和写成功率,并放在同一时间轴上。这样才能判断“选主是根因”,还是网络、JVM 或存储故障导致的结果。
告警不要只盯“当前是否存在 Leader”。短时间内角色多次变化、集群失去多数派、写错误率突增,或 Leader 节点同时出现长暂停和磁盘延迟尖峰,都应直接触发排查。处理此类故障的目标不是强行固定 Leader,而是让多数派通信、进程调度和持久化链路重新稳定。