
服务注册与分布式协调 / 技术文章
ZooKeeper 会话过期为何删掉临时节点
服务实例、选主节点或分布式锁节点突然消失时,关键不是先重建节点,而是确认它是否因 ZooKeeper 会话过期被删除。面向开发与运维人员,下面用节点所有者、连接状态、会话 ID 与运行时证据还原链路,并给出修复后的验收标准。
先确认消失的是临时节点
临时节点的生命周期绑定创建它的 ZooKeeper 会话。节点仍存在时,先查看 ephemeralOwner:非零值表示它是临时节点,值对应创建该节点的 session;持久节点的 ephemeralOwner 为 0x0。
先把 <PATH>、<HOST>、<PORT> 替换成实际值,再执行:
ZK_HOME='<PATH>'
ZK_SERVER='<HOST>:<PORT>'
"$ZK_HOME/bin/zkCli.sh" -server "$ZK_SERVER" <<'EOF'
stat /services/order/instance-1
quit
EOF预期输出只列出本次判断需要的字段;<ID> 为动态会话标识,实际值会不同:
Connecting to <HOST>:<PORT>
ephemeralOwner = 0x<ID>
如果执行 stat 时节点已经不存在,不能用“查不到节点”反推会话过期。此时必须依赖此前采集的 ephemeralOwner、客户端 session ID、连接状态事件和服务端日志闭合证据链。
会话过期为何会让节点消失
客户端请求 session timeout 后,服务端会在允许范围内协商最终值;默认边界通常由 tickTime 推导,常见默认最小值为 2 * tickTime、最大值为 20 * tickTime。客户端与当前服务器失联时会尝试连接 ensemble 中的其他服务器,只要在会话真正过期前恢复同一 session,原临时节点就会保留。
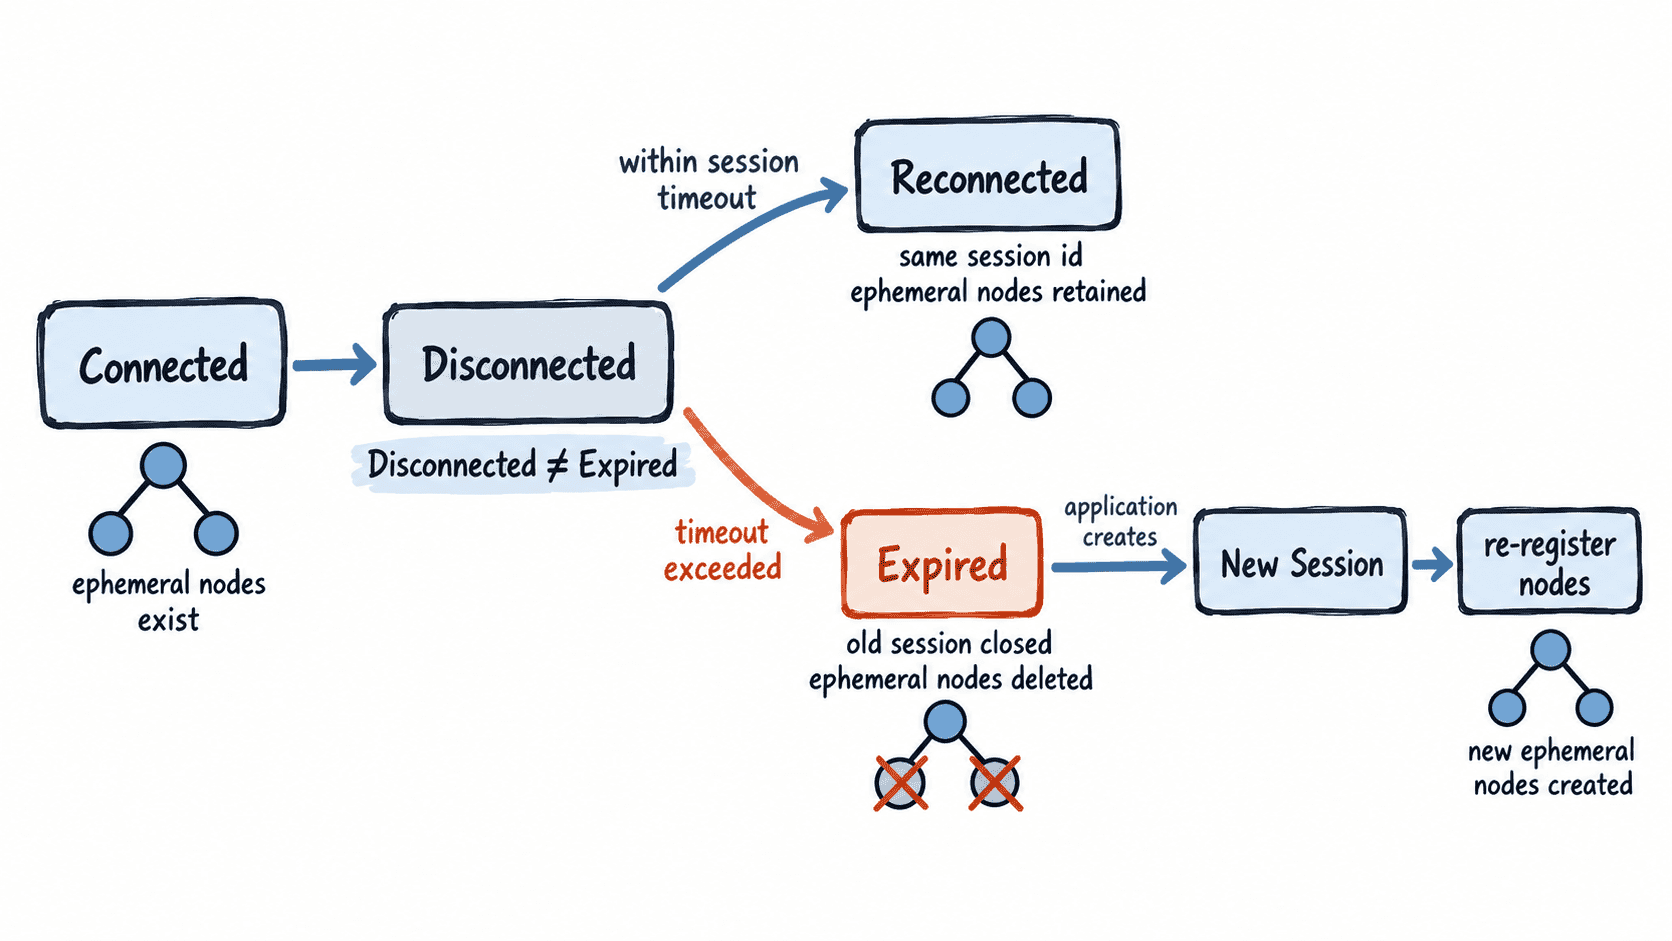
真正的过期由服务端决定。旧 session 被判定过期后,其临时节点会被删除;客户端即使随后恢复网络,也不能继续使用旧 session,只能建立新会话。应用侧常见信号是 Expired 状态或 SessionExpiredException。
按时间线串联证据
以“节点消失时刻”为中心,对齐客户端、JVM、网络和 ZooKeeper 服务端事件。单看某一类日志很容易误判,因为节点消失也可能来自主动删除、正常关闭客户端或发布流程重建连接。
| 证据 | 重点观察 | 可支持的结论 |
|---|---|---|
| 客户端状态 | Disconnected、SyncConnected、Expired、SessionExpiredException |
是否从短暂断连发展为真正过期 |
| 会话标识 | 断连前后的 session ID 是否变化 | 旧会话是否已无法恢复 |
| JVM/进程 | 长 GC、CPU 饥饿、线程停顿、容器冻结 | 心跳线程是否可能长期得不到调度 |
| 网络与服务端 | 连接重置、丢包、跨区抖动、服务端过载或重启 | 是否持续无法连接可用 ZooKeeper 服务器 |
最强的证据组合是:先出现持续 Disconnected,随后出现 Expired 或 SessionExpiredException,新连接的 session ID 与旧值不同,同时消失节点此前的 ephemeralOwner 对应旧 session。只有这些信号能串起来,才应把节点消失归因到会话过期。
区分几类常见根因
客户端长暂停常见于 Stop-The-World GC、CPU 配额不足、进程被冻结或宿主机严重争抢。网络未必持续异常,但心跳线程在超过 timeout 的时间里得不到运行机会,恢复后客户端才发现旧 session 已失效。
网络中断超过 timeout时,客户端通常会尝试切换到多个 ZooKeeper 地址,但始终无法及时恢复旧 session。排查范围应覆盖应用到整个 ensemble 的链路,而不是只检查最初连接的单台服务器。
timeout 配置过激会把普通抖动放大成会话过期。调整前应同时看高分位网络延迟、最长 GC/调度停顿和故障节点允许的摘除时延;单纯增大 timeout 会让服务发现剔除、选主恢复和锁释放都变慢。
应用主动关闭或重建客户端同样会删除临时节点,但它不是异常过期。若没有 Expired 证据,却能看到正常 close()、组件销毁或新 session 建立,应转向发布流程和应用生命周期排查。
修复时避免二次故障
服务发现节点可以在确认新 session 建立后重新注册,但选主和分布式锁还要防止旧执行者继续操作业务资源。ZooKeeper 删除旧临时节点,只说明旧会话已失效,并不会自动停止原进程。
锁和选主场景应使用 fencing token、版本号或其他服务端可校验的单调凭据,阻止旧持有者在网络恢复后继续写入。使用 Curator 等框架时,也要区分短暂连接挂起与会话丢失,只在 LOST/Expired 语义成立后执行需要新 session 的恢复逻辑。
配置层面优先消除长 GC、CPU 饥饿、网络不稳定和 ZooKeeper 集群过载,再基于可观测数据调整 session timeout。不要用“把 timeout 调大”代替根因修复。
用可重复场景验证修复
在测试或预发布环境至少验证两条路径:短暂断连小于协商 timeout 时,session ID 应保持不变,临时节点仍存在;人为制造超过 timeout 的长停顿或全链路中断时,应观察到 Expired,旧临时节点消失,应用建立新 session 后再完成注册或重新参与选主。
监控侧应同时记录连接状态、session ID、实际协商 timeout、GC/CPU 停顿、网络异常和节点注册结果。以后再遇到节点消失,就能先区分“短暂断连、会话过期、主动关闭、业务删除”,再进入对应修复路径,而不是靠重启碰运气。