
服务注册与分布式协调 / 技术文章
Nacos 服务实例反复上下线怎么排查
Nacos 服务实例反复变为不健康、消失又重现时,调用失败和告警往往也会跟着抖动。面向负责注册发现和值班排障的后端开发者与 SRE,下面按实例身份、客户端、服务端和消费侧逐层取证,最终定位并验证真实根因。
先确认到底是哪一种“上下线”
排查前不要只盯控制台颜色变化。先回答两个问题:实例记录是否真的被删除再注册,以及消费者是否真的把该实例从可用列表移除。这两件事不是同一个现象。
常见情况可以分成三类:
| 现象 | 更可能的含义 | 首要证据 |
|---|---|---|
同一 ip:port 在 healthy=true/false 间切换 |
健康状态抖动,实例记录仍在 | 实例查询结果、客户端连接与健康日志 |
同一 ip:port 周期性消失后又出现 |
客户端重连、进程重启或租约失效后重新注册 | 注册日志、进程启动时间、Nacos 服务端日志 |
ip 或 port 每次都变化 |
容器或进程被重建,不是单纯的注册中心抖动 | Pod/进程重启记录、发布与伸缩事件 |
先从 Nacos 查询同一服务的实例快照,避免把消费者本地缓存变化误判为服务端实例被删除。下面命令使用常见的 Naming OpenAPI;若部署启用了鉴权或经过网关,需要按现有环境补充认证方式。
curl -fsS "http://<HOST>:<PORT>/nacos/v1/ns/instance/list?serviceName=<SERVICE>&groupName=<GROUP>&namespaceId=<NAMESPACE>" | jq '.hosts[] | {ip, port, healthy, enabled, ephemeral, weight}'预期结果
{
  "ip": "<IP>",
  "port": <PORT>,
  "healthy": true,
  "enabled": true,
  "ephemeral": true,
  "weight": 1
}<HOST>、<PORT>、<SERVICE>、<GROUP>、<NAMESPACE> 与 <IP> 都应替换为现场值;若查询期间目标实例在结果中消失,说明问题已经进入“服务端实例状态”层,而不只是消费者缓存层。
用时间线把四层证据对齐
实例抖动最容易误判,是因为注册客户端、Nacos 服务端、消费者和运行平台会在不同时间记录同一故障。正确做法是围绕一次明确的下线时刻 <TIME>,向前后各扩几分钟对齐证据,而不是分别翻日志。
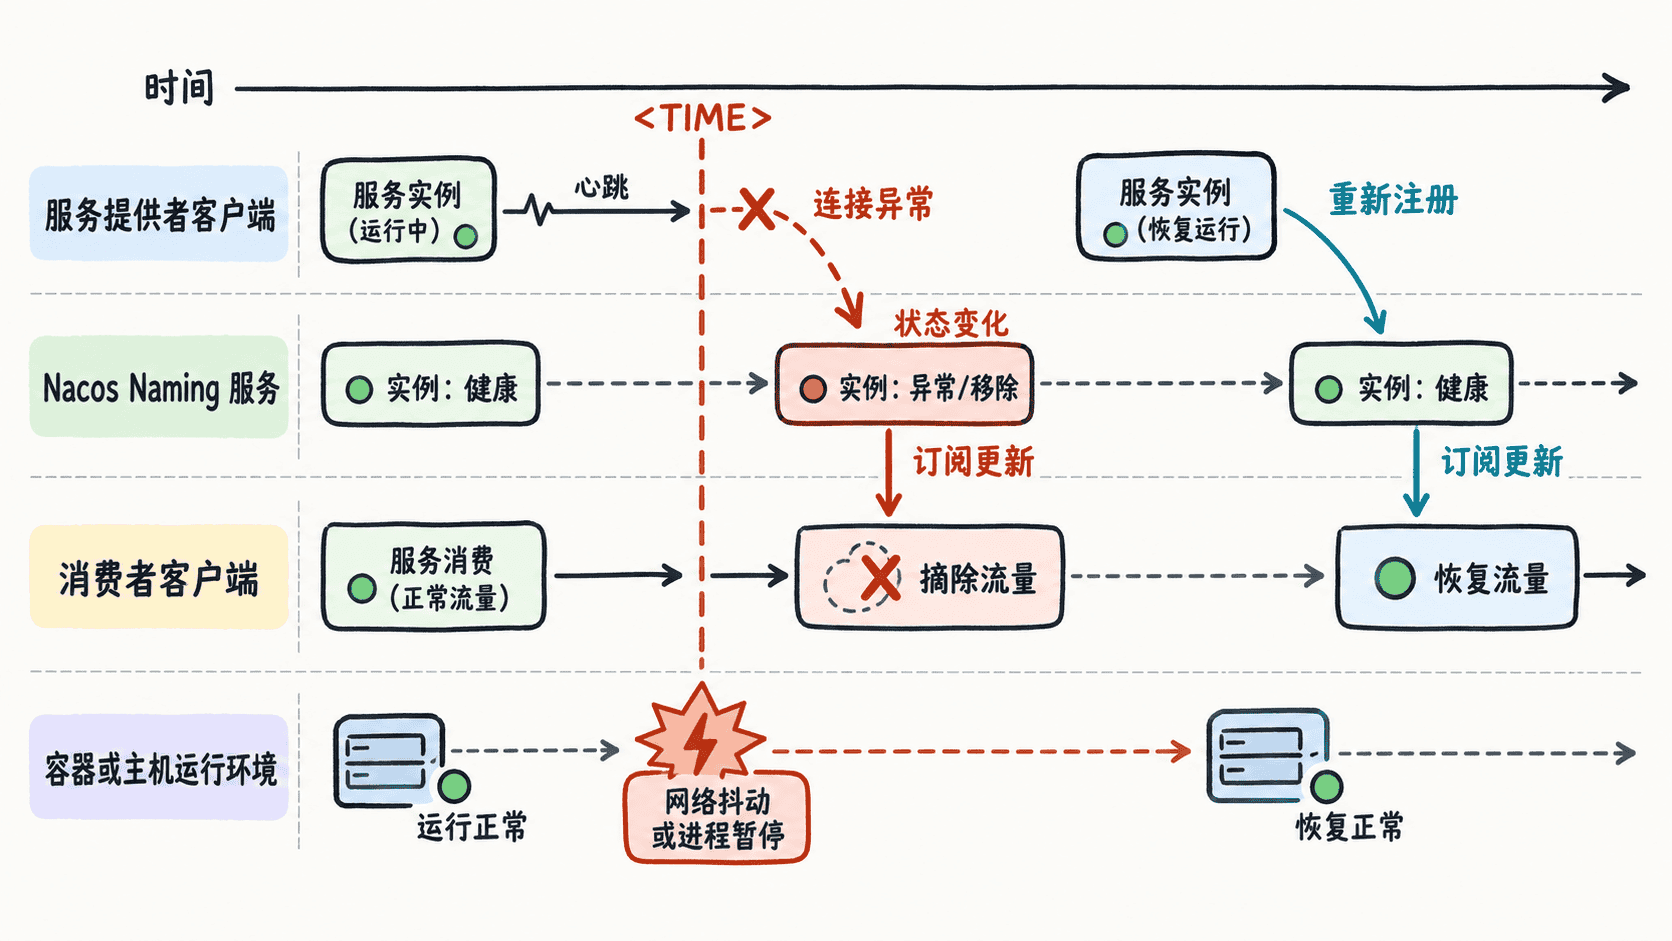
建议按同一时间窗口收集以下证据:提供者注册/重连日志、Nacos 服务端 Naming 相关日志、消费者订阅变化日志,以及 Pod/进程重启、节点网络与 GC 暂停记录。只要四层时间能对齐,根因通常会明显收敛。
先查提供者客户端是否在反复失联
如果实例是临时实例,进程重启、网络断开、长时间停顿或客户端重新建连,都可能让实例先失去健康状态,再在连接恢复后重新注册。这里优先查“谁先发生”:是应用先断开,还是 Nacos 先判定实例异常。
提供者侧重点检查:
- 同一时刻是否出现 Nacos 连接断开、重连、注册失败或超时日志。
- JVM 是否发生长时间 Stop-The-World、CPU 持续打满、线程池饥饿,导致注册/连接维护线程无法及时运行。
- 容器是否因为 OOM、探针失败、节点驱逐、滚动发布或自动扩缩容而重启。
- 实例上报的
ip、port、namespace、group、cluster 是否在重启后发生变化。 - 是否存在多个进程使用相同实例身份互相覆盖,或同一端口被快速重启的进程反复接管。
如果应用日志显示“先重启或先断链,随后实例消失”,Nacos 多半只是按健康机制反映了上游故障;此时不要先调健康参数,应先处理进程稳定性或网络问题。
再查 Nacos 服务端与集群路径
如果提供者进程稳定、网络侧也没有明显断开,但实例状态仍反复变化,就把焦点转向 Nacos 节点和集群通信。重点不是只看“服务是否存活”,而是确认处理注册、连接和实例状态的节点是否持续健康。
检查 Nacos 服务端时,关注以下信号是否与 <TIME> 对齐:节点重启或频繁 Full GC、磁盘或 CPU 饱和、连接数异常增长、集群节点间通信异常、Naming 请求延迟突升,以及负载均衡器或服务网格对长连接的不当超时。
如果多个互不相关的服务在同一时间同时抖动,且分布在不同业务主机上,应优先怀疑 Nacos 集群、共享网络或入口负载均衡;如果只有单个应用抖动,则优先回到应用进程、所在节点与发布事件。
别忽略消费者看到的是订阅结果
调用失败不一定来自实例“被删”。消费者通常根据订阅结果和本地缓存更新可用实例列表,所以还要确认消费者是否在同一时间收到实例变化,以及负载均衡是否把异常实例真正摘除。
如果 Nacos 服务端快照一直稳定,但消费者日志里服务列表频繁变动,重点检查消费者到 Nacos 的连接、客户端版本兼容性、namespace/group/serviceName 是否一致,以及本地缓存是否被频繁重建。反过来,如果服务端实例确实消失,但消费者仍长时间访问旧地址,则要排查消费者是否订阅中断或缓存更新失败。
这一步的目标是把“注册侧抖动”和“消费侧感知异常”拆开。前者影响实例事实状态,后者决定调用流量是否真的跟着抖。
按根因修复并做闭环验证
根因确定后,修复应落在最靠近故障源的位置,而不是统一修改 Nacos 参数:
- 进程重启或容器不稳定:修复 OOM、探针、资源限额、发布策略或宿主机故障,并确认实例身份保持可预测。
- 网络或长连接被中断:修复节点网络、NAT/防火墙、负载均衡器空闲超时或服务网格连接策略。
- JVM 或主机长时间停顿:降低 GC 停顿和 CPU 饱和,保证客户端维护线程能够及时运行。
- Nacos 集群能力不足:先处理节点负载、GC、磁盘与集群通信,再评估扩容和架构调整。
- 消费者订阅异常:校验客户端版本、连接状态、服务标识和缓存更新链路。
修复后至少覆盖一个完整观察窗口,重复查询实例快照,并核对四项结果:同一实例不再反复消失、健康状态稳定、消费者实例列表不再高频变化、调用错误率和延迟恢复到基线。若仍有抖动,回到同一个 <TIME> 时间线重新对齐证据,而不是继续扩大超时阈值。
最终需要得到的结论不是“已经不抖了”,而是一条可复现的因果链,例如“容器探针失败导致进程每隔数分钟重启,客户端断开后临时实例被移除,消费者随后摘流,进程恢复并重新注册”。只有根因、修复动作和验证指标能闭环,实例反复上下线的问题才算真正解决。