
服务注册与分布式协调 / 技术文章
ZooKeeper 延迟升高与请求积压怎么排查
这篇文章面向正在处理 ZooKeeper P99 延迟升高、吞吐下降和请求积压的 SRE 与性能工程师,给出从客户端观测、服务端队列到 JVM、磁盘和仲裁网络的定位顺序,最终把“慢”收敛为可验证的瓶颈与修复项。
先判断是排队变长还是处理变慢
P99 变差不等于 ZooKeeper 内部一定“执行变慢”。端到端延迟还包含客户端排队、网络往返和服务端等待。先把 P50、P95、P99 按读写拆开,再看吞吐是否同步下降;只盯平均值,容易漏掉短时 GC、磁盘抖动和网络丢包造成的尾延迟。
mntr 的 zk_min_latency、zk_avg_latency、zk_max_latency 适合做服务端延迟快照,但不能代替 P99。P99 应来自客户端计时器或已接入的指标系统。zk_outstanding_requests 是积压信号:单次升高只说明当时有未完成请求,持续高位并伴随吞吐下降,才更像处理能力落后于到达速率。
吞吐要对 zk_packets_received、zk_packets_sent 在固定时间窗取增量。若入口速率上升、完成速率下降且 outstanding 同步抬升,优先排查服务端瓶颈;若 outstanding 很低但客户端 P99 仍高,则优先检查客户端线程池、连接和网络。
用最小快照确认积压和节点角色
对 ensemble 每个节点在相近时间取一次 mntr,记录节点角色、延迟、收发包、连接数和 outstanding。四字命令可能受 4lw.commands.whitelist 限制;生产环境应沿用既有白名单或监控接口,不要为临时排查扩大命令范围。
执行前把实际地址写入环境变量 ZK_HOST 和 ZK_PORT:
: "${ZK_HOST:?set ZK_HOST}"
: "${ZK_PORT:?set ZK_PORT}"
printf 'mntr\n' | nc -w 2 "$ZK_HOST" "$ZK_PORT"
预期输出
zk_min_latency	<LATENCY_MS>
zk_avg_latency	<LATENCY_MS>
zk_max_latency	<LATENCY_MS>
zk_packets_received	<COUNT>
zk_packets_sent	<COUNT>
zk_num_alive_connections	<COUNT>
zk_outstanding_requests	<COUNT>
zk_server_state	<STATE>
实际数值会随节点和时间变化。若只有一个节点明显偏高,优先检查该节点本地资源;若多个节点同时恶化,尤其写请求一起变慢,则继续检查 leader 写路径、仲裁网络和整体流量。
沿请求链路定位积压点
一次请求会经历客户端发送、连接层、请求处理链路和响应返回;写请求还要经过 leader 协调、事务日志与 quorum 提交。把这些阶段的指标放到同一时间轴上,才能确认“哪个等待先出现”。
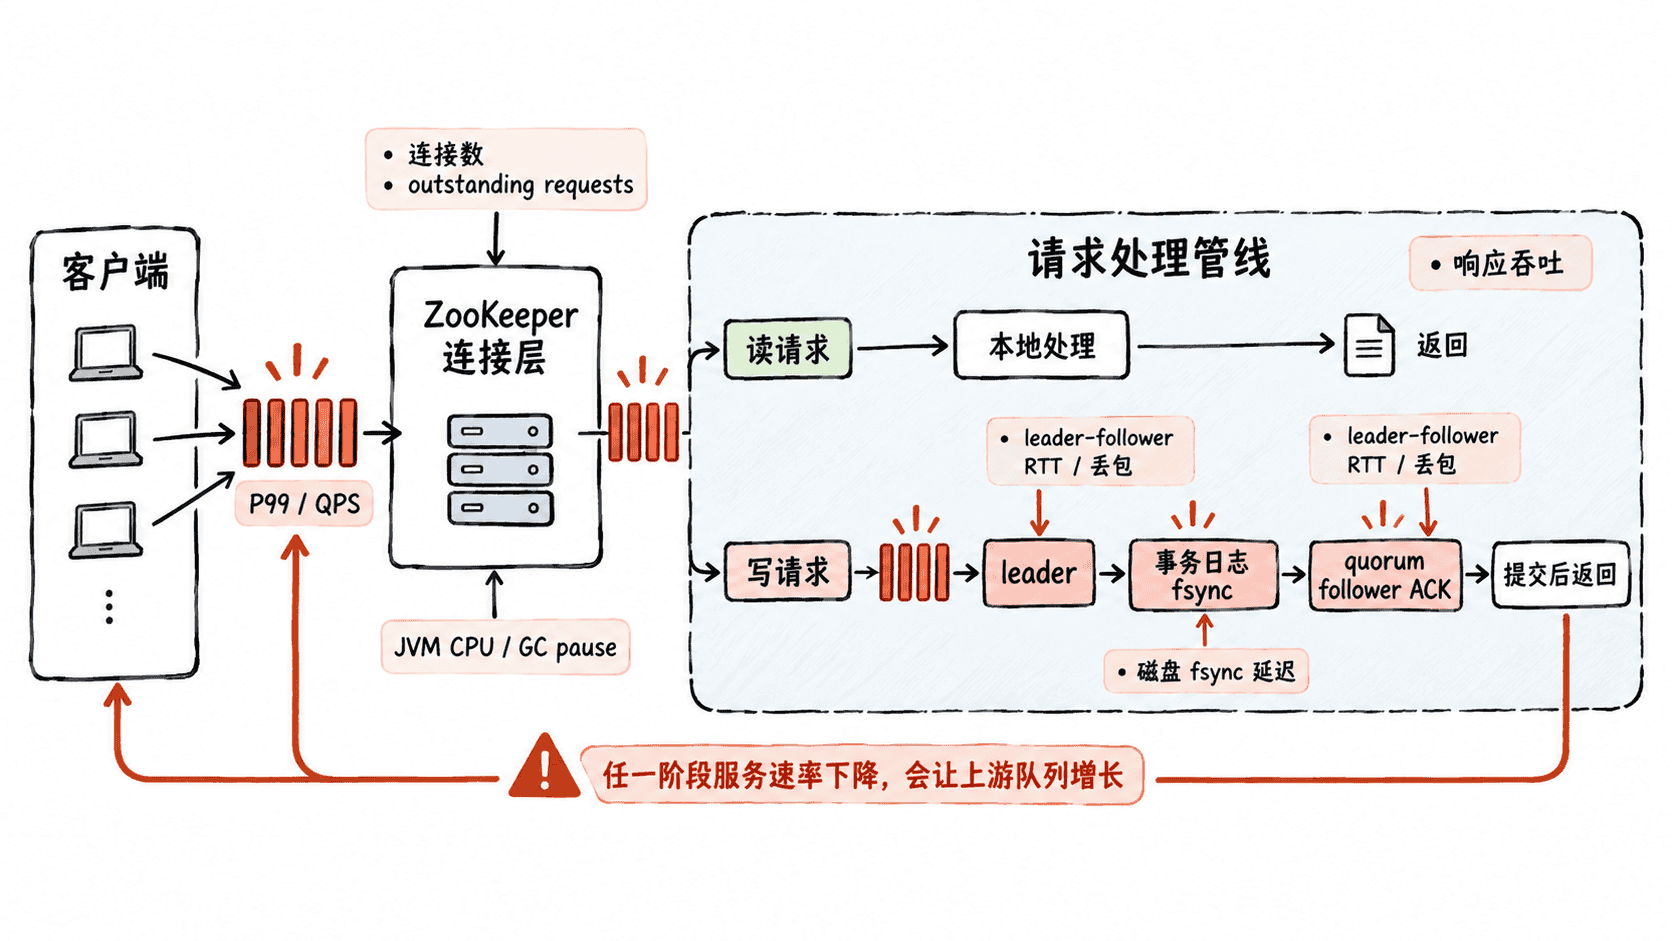
如果 GC pause 先于延迟尖峰,随后 outstanding 突增,JVM 停顿是强线索;如果写 P99 先升、磁盘写延迟和 fsync 同时恶化,而读请求相对稳定,更像事务日志设备受限;如果 leader 与 follower 间 RTT、重传同步升高,则写提交可能被 quorum 等待拖慢。
把读慢和写慢分开归因
读请求主要受本地节点资源与客户端到该节点的网络影响;写请求还要经过 leader、事务持久化与多数派确认,因此对磁盘和节点间网络更敏感。
| 现象组合 | 优先怀疑 | 补证信号 |
|---|---|---|
| 读写同时慢,所有节点相近 | CPU、长 GC、流量洪峰、网络拥塞 | CPU/steal、GC pause、QPS、丢包与 RTT |
| 写明显比读慢 | 事务日志 I/O、leader 压力、quorum RTT | leader 负载、磁盘写延迟、fsync、节点间网络 |
| 单个节点读慢 | 本机 JVM、CPU 或客户端链路 | GC、CPU、NIC、客户端 RTT |
| outstanding 持续高且吞吐下降 | 服务速率低于到达速率 | 请求速率、GC、磁盘与网络等待 |
对写延迟,事务日志设备是高优先级检查项。如果事务日志与快照、系统盘或其他高 I/O 工作负载共享设备,抖动可能直接反映到尾延迟;条件允许时,将 dataLogDir 放到独立、低延迟设备,再用同一负载验证。
识别客户端放大与服务端背压
服务端资源正常并不代表流量形态正常。重试风暴、连接集中重建、热点 znode 高频读写,或大量 watch 事件短时触发,都可能同时放大 CPU、网络和队列。排查时重点看 QPS 是否由少数客户端拉高、连接数是否突增、写比例是否变化,以及 zk_watch_count 与发送包速率是否同步异常。
还要检查超时重试是否形成正反馈:延迟升高触发更多重试,更多重试又扩大积压。globalOutstandingLimit 一类背压限制用于阻止未完成请求无限堆积,不应被当作扩容手段;若瓶颈在磁盘、GC 或 quorum 网络,单纯调大上限只会允许更多请求进入等待区。
修复后用同一负载做闭环验证
修复必须对应证据链:磁盘问题验证事务日志 I/O,GC 问题验证停顿,网络问题验证 leader-follower RTT 与丢包,客户端问题验证请求速率、重试率和连接行为。验收时使用与故障窗口可比的负载,同时观察客户端 P99、读写吞吐、zk_outstanding_requests、GC pause、CPU、磁盘写延迟和节点间网络。
理想结果不是“某一刻 outstanding 归零”,而是高峰下队列能回落、吞吐恢复、P99 不再持续爬升。若只能先止血,应先削减异常流量、限制重试放大并隔离明显故障节点;不要依赖反复重启清队列,也不要一次同时修改堆、线程、磁盘和限流参数,否则无法确认真正有效的改动。