
密码学与证书 / 技术文章
SM2、SM3、SM4 到底是什么关系
接国密接口时,文档里经常同时出现 SM2、SM3、SM4。如果只把它们记成“三种国产加密算法”,很快就会在签名、摘要和数据加密之间混乱。最简单的理解方式,是先看它们在密码体系中的功能位置。
SM2 属于公钥密码体系
SM2 基于椭圆曲线密码学,可以用于公钥加密、数字签名和密钥交换相关能力。
它不能简单理解成“国产 RSA”,因为两者底层数学体系、签名流程、编码和参数都不同。做跨系统联调时,经常需要额外关注用户标识、签名格式、曲线参数和密文表示。
SM3 是密码杂凑算法
SM3 的位置更接近 SHA-256:输入任意长度数据,得到固定长度摘要。
它常作为国密协议中的摘要组件,也会参与 SM2 等流程。SM3 本身不可逆,因此不是“能解密回原文”的加密算法。
SM3 输出为 256 位,即 32 字节。转成十六进制展示通常是 64 个字符,Base64 又是另一种表示;接口要求“32 字节摘要”时,不能把 64 字符十六进制文本直接当作原始摘要传入。摘要不带秘密,攻击者修改数据后也能重算 SM3,因此单独比较摘要不等于身份认证,需要签名或基于密钥的认证机制。
SM4 是对称分组密码
SM4 的位置更接近 AES。发送方和接收方共享同一秘密密钥,用它完成业务数据的加密和解密。
但仅仅说“使用 SM4”仍然不够。实际协议还要明确工作模式、IV/Nonce、Padding 或认证方式等参数。
SM4 的分组长度和密钥长度均为 128 位,但工作模式决定了如何处理长消息及完整性。若协议选择 CBC,双方要统一 IV、填充和认证安排;若选择 GCM,要统一 Nonce 和认证标签规则。不能只比较双方都写着“SM4”,就认为接口一定兼容,更不能直接把密钥字符串的字符数当作实际密钥位数。
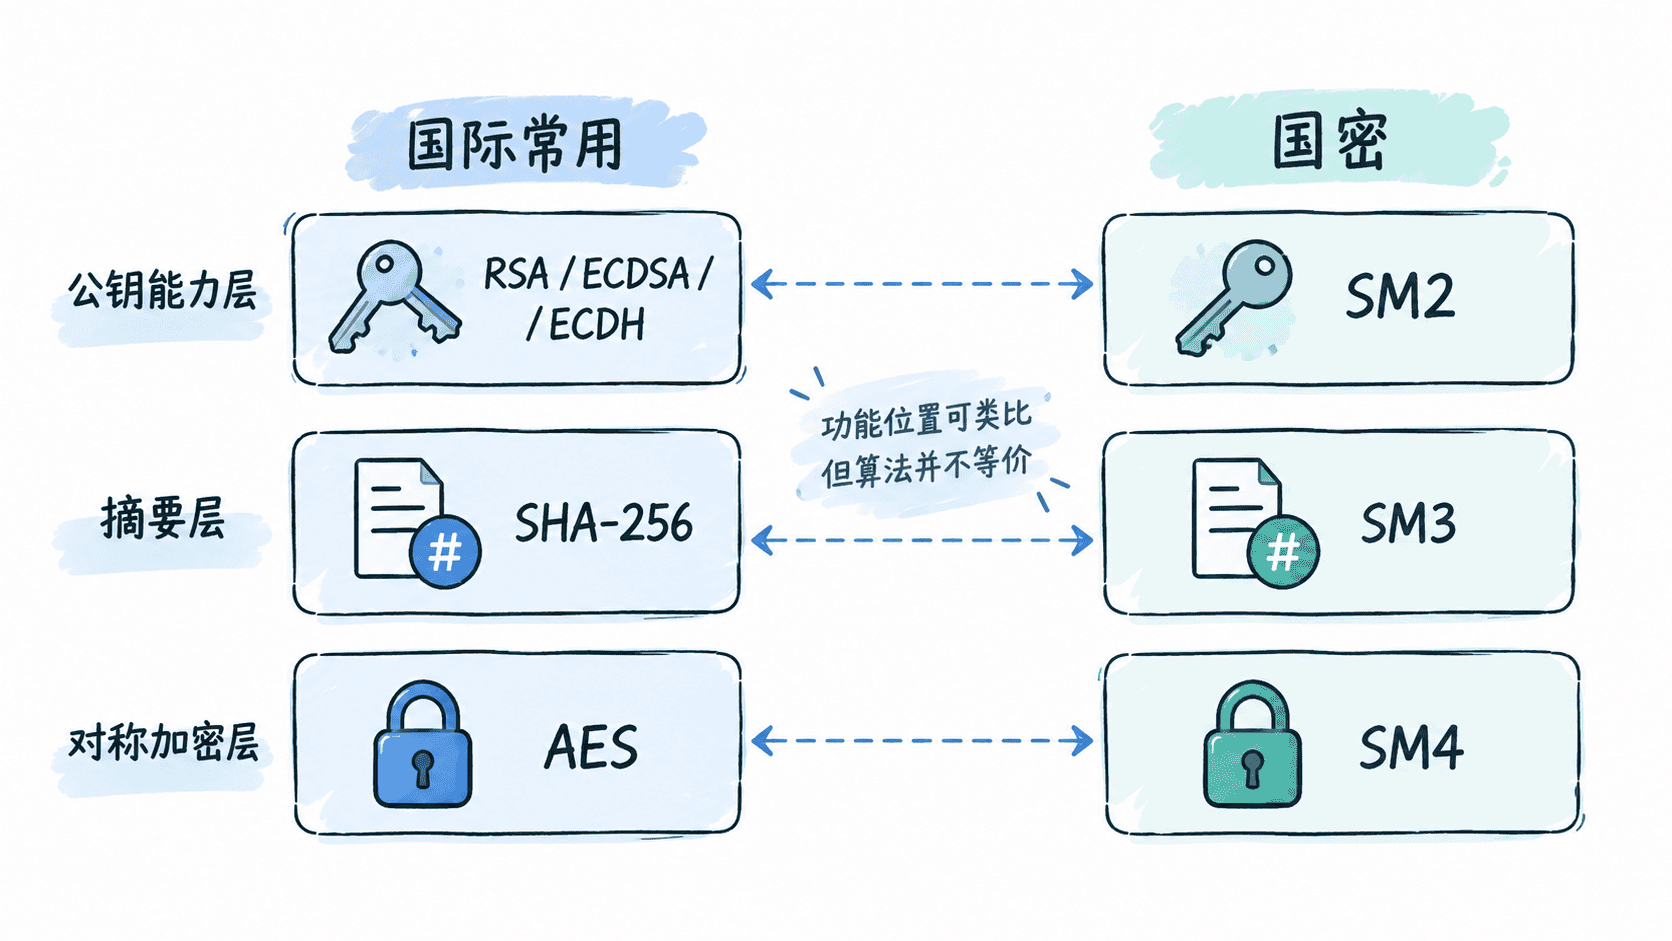
为什么不能机械一对一替换
虽然功能位置可以类比,但真正的国密改造并不是:
AES → SM4
RSA → SM2
SHA-256 → SM3
然后结束。
真实系统还可能涉及国密证书、国密 TLS、Provider、KMS/HSM、密钥生命周期、报文编码,以及具体行业或项目的合规要求。
所以“Java 已经能调用 SM2/SM3/SM4”只代表具备了基础算法能力,并不等于整个系统已经完成国密体系改造。
一个具体例子是 RFC 8998 定义的 TLS 1.3 商密套件:套件名 TLS_SM4_GCM_SM3 表示记录保护使用 SM4-GCM,并使用 SM3 参与相应的哈希与密钥派生;身份签名另有 sm2sig_sm3 标识。名字不是把三个算法顺次对同一份数据各“加密一次”,不同组件承担不同职责。该协议配置也不能替代项目本身的证书、设备和部署要求核对。
最适合记住的关系
| 国密算法 | 主要能力位置 | 国际体系中可类比的位置 |
|---|---|---|
| SM2 | 公钥加密、签名、密钥交换 | RSA / ECC 相关方案 |
| SM3 | 密码杂凑 | SHA-256 等 |
| SM4 | 对称分组加密 | AES |
这里的“类比”只表示职责相近,不表示协议参数、密钥格式或安全结构可以直接互换。
理解这三个位置后,再去看 SM2 签名、SM4 数据加密或国密 TLS,整个国密知识体系会清楚很多。
联调先核对字节协议
| 能力 | 必须与对端确认 | 常见不兼容现象 |
|---|---|---|
| SM2 签名 | 用户标识、签名输入、DER 或固定长度 r/s 编码 | 本地验签通过,对端失败 |
| SM2 加密 | 密文分段次序、点编码和接口约定 | 解密失败或摘要不匹配 |
| SM3 摘要 | 原始字节、字符编码、摘要输出表示 | 同一“字符串”得到不同结果 |
| SM4 加解密 | 模式、密钥字节、IV/Nonce、填充或标签 | 解密乱码、填充错误或认证失败 |
联调时先让双方使用同一份公开测试输入和明确参数,核对每一步输出,再接入真实业务。测试输入应覆盖空内容、中文、二进制数据以及一处被篡改的报文。生产密钥不要用于共享测试向量;算法跑通以后,再验证密钥访问权限、证书更新、失败处理和日志脱敏。