
Redis 与缓存 / 技术文章
Redis 大 List 为什么会成为性能隐患
这篇文章面向正在维护 Redis 线上数据结构、发现某个 List 持续膨胀或成员查询越来越慢的后端开发者。你会判断“大 List”到底危险在哪、什么情况下应该迁移到 Set,并掌握一套包含双写、回填、TTL 保留、灰度切读、校验和回滚的低风险迁移方案。
大 List 的问题不在“大”,而在访问模式
Redis List 本身并不是低效结构。它非常适合 LPUSH、RPUSH、LPOP、RPOP 这类两端操作,核心问题通常出现在业务把它当成“成员集合”使用。
如果一个 List 已经包含几十万甚至更多元素,而业务频繁执行成员查找、全量读取或按值删除,单次操作成本会随着列表长度增加。
| 操作诉求 | List | Set |
|---|---|---|
| 两端插入 / 弹出 | 适合,通常为 O(1) | 不表达顺序 |
| 判断成员是否存在 | LPOS 最坏 O(N) |
SISMEMBER 平均 O(1) |
| 按成员删除 | LREM 需要扫描 |
SREM 平均 O(1) |
| 保证成员唯一 | 需要业务自己去重 | 原生保证唯一 |
| 保留插入顺序 | 支持 | 不支持 |
| 全量读取 | O(N) | O(N) |
因此,如果核心业务语义其实是“某个 ID 是否存在”“加入集合”“从集合删除”,继续使用 List 就是在用线性扫描解决集合问题。
先确认业务真的可以失去顺序和重复元素
迁移前最重要的不是写脚本,而是确认语义。
只有同时满足下面大部分条件,List 才适合迁移到 Set:
- 元素顺序没有业务意义
- 重复元素没有业务意义
- 高频操作是成员判断、添加、删除
- 不依赖按索引读取
- 不依赖“最近 N 条”或队列语义
例如“已登录设备 ID”“白名单用户 ID”“已处理订单 ID”“某用户拥有的权限编码”通常更接近 Set。
而“最近浏览记录”“消息消费顺序”“操作时间线”依赖顺序,不能为了降低查询复杂度直接改成 Set。
迁移前先把现状量化出来
不要只凭“这个 Key 看起来很大”决定迁移。至少先确认类型、成员数、内存占用和剩余 TTL。
redis-cli TYPE auth:session-id-list
redis-cli LLEN auth:session-id-list
redis-cli MEMORY USAGE auth:session-id-list
redis-cli PTTL auth:session-id-list
预期输出:
list
<COUNT>
<BYTES>
<TTL_MS><COUNT>、<BYTES> 和 <TTL_MS> 会随实际数据变化。若 PTTL 返回 -1,说明 Key 没有过期时间;返回 -2 说明 Key 已不存在。
还要同时确认线上代码到底做了哪些操作。如果主要逻辑是“取出整个 List,再在应用内执行 contains”,那么风险不只在 Redis:大响应还会继续消耗网络、应用堆内存和反序列化时间。
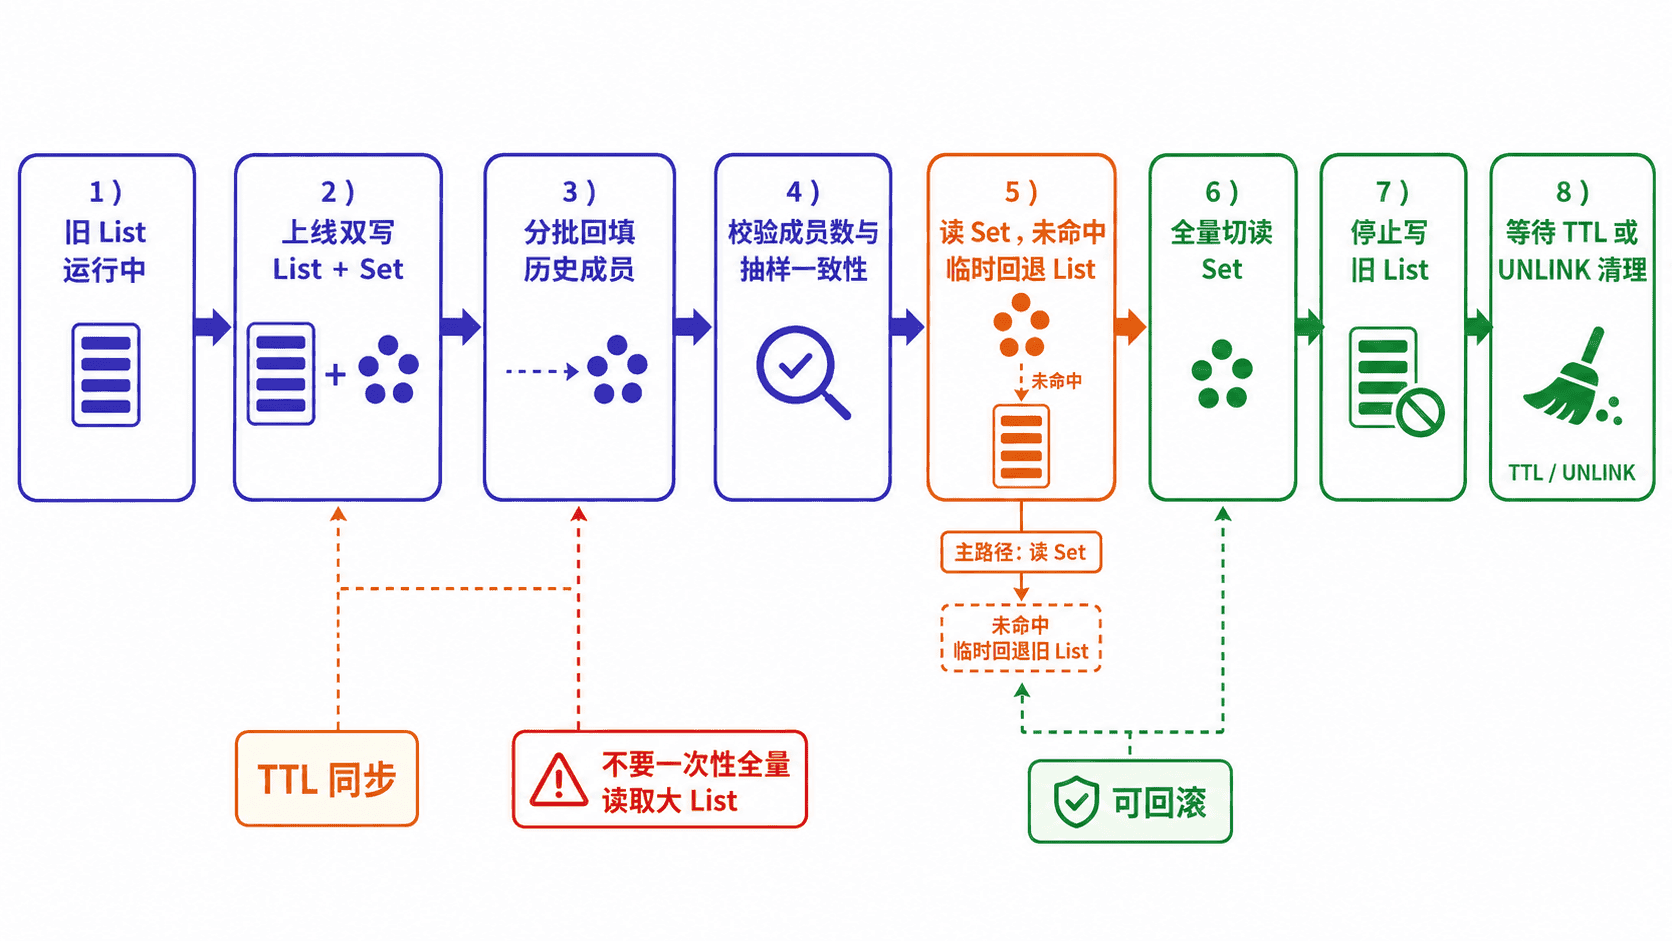
正确迁移顺序是先双写,再回填,再切读
直接把旧 List 删除并一次性转换成 Set,风险最大。更稳妥的方式是把迁移拆成多个可回滚阶段。
第一阶段先上线双写。新产生的成员同时写入旧 List 和新 Set,删除成员时也同时从两边删除。这样可以先阻止“新增数据继续只进入旧结构”。
第二阶段回填历史数据。优先从数据库或其他权威数据源重建 Set;如果 Redis 中的 List 本身就是唯一可用来源,则需要分批读取,避免 LRANGE key 0 -1 一次拉取全部元素。
第三阶段做一致性校验。Set 天然去重,因此 SCARD 不一定等于 LLEN。真正应该验证的是“旧 List 中的有效唯一成员是否都能在 Set 中找到”。
第四阶段灰度切读。读取优先使用 Set;在迁移未完全结束时,如果 SISMEMBER 返回不存在,可以临时回退旧 List,避免因为回填缺口产生误判。
最后确认稳定后停止旧 List 写入,再等待旧 Key TTL 自然过期,或者使用 UNLINK 清理。
TTL 是迁移里最容易漏掉的隐性契约
很多线上迁移功能正确,却因为忘记 TTL 产生新问题。
旧 List 如果原本只有 30 天生命周期,而新 Set 创建后没有设置过期时间,那么一次迁移就可能把临时数据变成永久数据。
可以先读取旧 Key 的剩余 TTL,再同步到新 Key:
redis-cli PTTL auth:session-id-list
redis-cli PEXPIRE auth:session-id-set <TTL_MS>
redis-cli PTTL auth:session-id-set
预期输出:
<TTL_MS>
(integer) 1
<NEW_TTL_MS>
<NEW_TTL_MS> 会比第一次读取的 <TTL_MS> 略小,因为命令执行本身会消耗时间。
如果旧 Key 的 TTL 会在业务访问过程中被续期,那么迁移期间必须同步这套续期规则,而不是只在创建新 Set 时复制一次 TTL。
回填时不要制造第二个性能事故
大 List 迁移最危险的操作之一,是在生产高峰直接执行全量读取:
redis-cli LRANGE auth:session-id-list 0 -1预期结果:
返回该 List 的全部元素;对于大 List,响应体可能非常大,因此不应作为生产迁移方案。更安全的方式是分批回填,并控制每批大小和执行节奏。批次应该足够小,让单次 Redis 操作、网络响应和应用内存都保持可控。
如果旧 List 在回填期间仍然频繁发生头部插入、删除或重排,简单使用固定 offset 分页可能出现跳过或重复读取。Set 可以容忍重复写入,但不能容忍遗漏。
因此高质量迁移通常优先选择以下方案之一:
- 从数据库等最终数据源重新构建 Set。
- 在业务层先开启双写,再对一份稳定快照做历史回填。
- 在可接受的短窗口内冻结相关写入,完成最终对账后切换。
- 为元素增加版本或变更日志,保证迁移期间发生的增删可以重新补偿。
核心目标不是“脚本跑完”,而是确保迁移期间的每一次业务变更最终都反映在新 Set 中。
切读以后要验证性能,而不只是验证功能
迁移完成后,至少应该比较四类指标:
- 单次成员判断延迟
- Redis P95 / P99 延迟
- Key 内存占用
- 客户端网络流量与应用内存
成员判断可以直接验证:
redis-cli SISMEMBER auth:session-id-set <ID>
redis-cli SCARD auth:session-id-set
预期输出:
0 或 1
<UNIQUE_COUNT>
0 表示成员不存在,1 表示存在;<UNIQUE_COUNT> 是 Set 中去重后的成员数。
如果迁移前应用每次需要获取整个 List 再做 contains,迁移后改成 SISMEMBER,收益通常会同时体现在 Redis 响应大小、网络传输和应用内存上。
最终下线旧 List 要保留回滚余地
不要在刚切读 Set 的同一版本里立刻删除旧 Key。
更稳妥的做法是先让新路径稳定运行一段观察窗口,确认错误率、命中逻辑和成员一致性没有异常,再停止旧 List 写入。
旧 Key 可以继续保留到原 TTL 到期;如果必须主动清理大 Key,优先考虑:
redis-cli UNLINK auth:session-id-list预期输出:
(integer) 1这表示 Key 已从主键空间移除,内存释放由后台线程继续完成。
最终可以记住一句话:从 List 迁移到 Set,不是一次数据类型替换,而是一场数据语义和线上流量路径的迁移。 先确认业务不需要顺序,再通过双写、回填、TTL 同步、灰度切读和延迟清理,把一次高风险结构调整拆成多个可验证、可回滚的小步骤。