
Redis 与缓存 / 技术文章
为什么一个 Redis 大 Key 会拖垮系统
这篇文章面向已经了解 Redis Big Key 基本概念、但还不清楚它为什么会演变成系统级故障的后端开发者。你会沿着一次大 Key 请求的执行链路,看清主线程阻塞、请求排队、网络占用、客户端超时和复制压力是怎样互相放大的,并知道应该从哪里切断这条故障链。
一个大 Key 为什么能影响整个实例
Redis 中的很多命令执行依赖主线程串行处理。只要某个命令在主线程上耗时过长,后续请求就不能正常推进。
如果一个 Key 很大,例如超大的 String、Hash、List、Set 或 Sorted Set,那么一次全量读取、遍历、序列化或删除,都可能让单次命令执行时间显著增加。
问题在于,Redis 不会只服务这个大 Key。主线程还同时承担其他业务请求,因此一个局部的大 Key 操作会直接拖慢同实例上的普通小 Key。
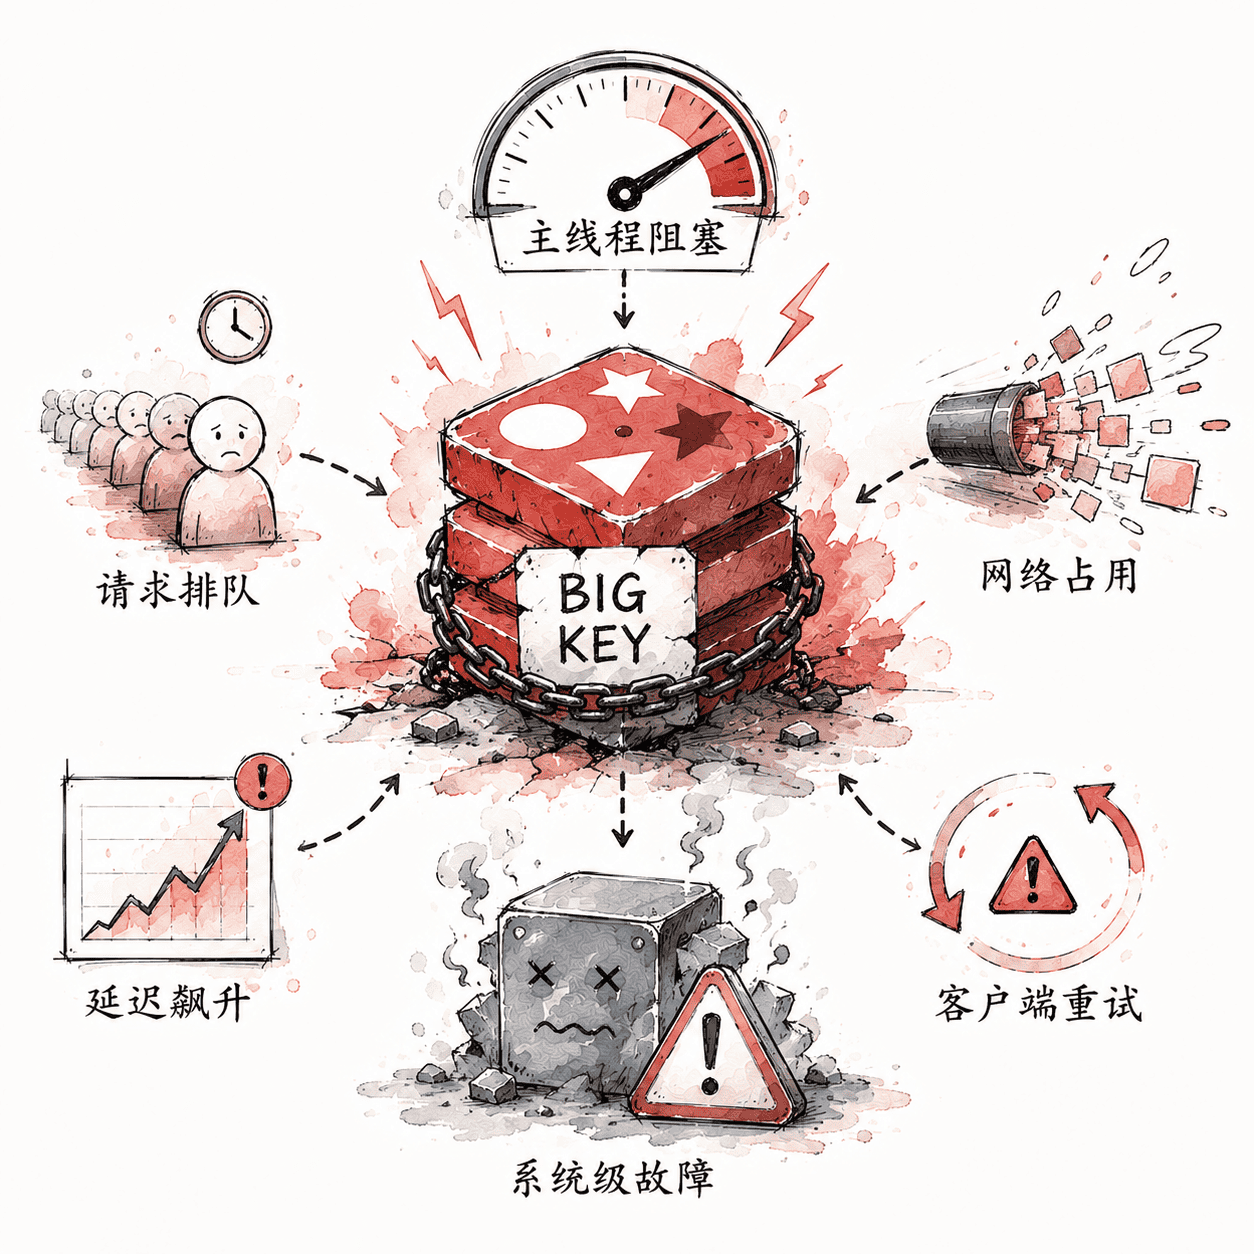
主线程一慢,所有请求都会排队
假设正常请求只需要几十到几百微秒,但某次大 Key 操作突然耗费几十毫秒。对单次请求来说,这个数字似乎不大,但对于高 QPS 的 Redis 实例来说,几十毫秒已经足够积压大量请求。
后续请求即使只是简单的 GET、SET 或 INCR,也必须等待前面的慢操作完成。
这也是为什么线上经常看到一种现象:Redis CPU 并没有立刻打满,但业务的 P99 延迟突然明显升高。
可以通过慢日志先确认是否存在异常命令:
redis-cli SLOWLOG GET 10预期输出:
<RECENT_SLOWLOG_ENTRIES>实际内容会包含最近的慢命令、执行时间和参数,具体值因实例负载不同而变化。
大响应会继续占住网络和客户端
如果大 Key 对应的是全量读取,例如一个几十 MB 的 String,或者一次 HGETALL、SMEMBERS、LRANGE 0 -1 返回大量数据,那么压力不会在 Redis 执行完命令后结束。
Redis 还需要把响应写入网络缓冲区,网卡需要传输数据,客户端需要接收、分配内存、反序列化并处理结果。
因此一次大 Key 读取会同时消耗:
- Redis 响应构造和发送时间
- Redis 出网带宽
- 客户端连接占用时间
- 客户端内存
- 应用反序列化和业务线程时间
当多个客户端同时读取同一个大 Key 时,这些成本会被并发放大。
超时重试会把一次慢请求变成更多请求
真正容易把系统拖垮的环节,往往不是第一次慢请求,而是客户端超时后的自动重试。
假设 Redis 因为大 Key 操作变慢,应用调用超过 100 毫秒后超时。如果客户端配置了 2 次自动重试,那么原本一次请求可能变成 2~3 次请求重新进入 Redis。
此时会形成一个危险循环:
- 大 Key 操作让 Redis 变慢。
- 请求开始排队。
- 应用调用超时。
- 客户端自动重试。
- Redis 收到更多请求。
- 队列更长,延迟继续升高。
这类现象本质上属于重试放大。上游本意是提升成功率,结果却可能在故障期间制造额外流量。
大 Key 还会影响复制和持久化
如果大 Key 只是偶尔读取,主要影响请求延迟和网络;如果它还被频繁更新,故障范围会进一步扩大。
写命令需要传播到副本节点,AOF 也需要记录写入操作。大对象频繁修改时,复制链路、磁盘写入和后台重写压力都会增加。
当副本节点跟不上主节点时,复制延迟会上升;当持久化压力增加时,磁盘 I/O 和 fork 相关成本也可能进一步影响实例稳定性。
因此“大 Key + 高频更新”通常比“只读大 Key”风险更高。
删除大 Key也可能成为事故触发点
线上经常有一种看似合理的处理方式:发现大 Key 后马上执行 DEL。
但如果这个 Key 包含大量元素,释放内存本身就可能耗费明显时间。直接同步删除,反而可能在高峰期制造一次新的阻塞。
对于适合异步释放的场景,可以优先考虑 UNLINK:
redis-cli UNLINK cache:huge-key预期输出:
(integer) 1这表示 Key 已从主键空间移除,后续内存释放由后台线程处理。
不过 UNLINK 只是降低删除瞬间的阻塞风险,并不能替代真正的 Big Key 拆分。
最危险的是“大 Key + 热点 + 重试”
单独一个大 Key 不一定立刻拖垮系统。真正高风险的组合通常是:
- Key 本身体积很大
- 访问频率很高
- 请求需要全量读取
- 客户端存在自动重试
- Redis 实例同时承载多个核心业务
- 复制和持久化压力已经较高
一旦这些条件叠加,一个 Key 就可能成为整个实例的延迟放大器。
所以排查 Redis 延迟时,不能只看总内存和 CPU,还应该同时关注 Big Key、Hot Key、慢命令、网络吞吐和客户端重试。
治理的关键是切断传播链
治理 Big Key 不应该只做“发现以后删除”,而应该从数据模型上限制单 Key 的增长。
可以优先采用以下策略:
- 超大集合按用户、时间、业务分片拆成多个 Key
- 历史 List 设置最大长度,避免无限增长
- 大 JSON 拆成更小粒度对象,避免每次整体读写
- 禁止生产接口默认执行全量
HGETALL、SMEMBERS或无限范围LRANGE - 对客户端重试设置合理上限,并配合熔断和限流
- 给 Big Key、Hot Key、P99 延迟和网络吞吐建立监控
最终可以记住一句话:一个 Redis 大 Key 真正拖垮系统,不是因为它“占了很多内存”,而是因为它把一次局部慢操作放大成主线程排队、客户端重试和上下游连锁拥塞。 只要切断其中任意一个关键放大环节,事故范围就能明显缩小。