
Redis 与缓存 / 技术文章
Redis 大 Key 到底有多危险
这篇文章面向已经在生产环境使用 Redis、但还把 Big Key 当成“只是占内存”的后端开发者。你会理解 Big Key 为什么会放大阻塞、网络、复制和删除成本,知道怎样识别高风险 Key,并掌握拆分、渐进删除和容量治理的基本方法。
Big Key 真正危险的不是“大”,而是一次操作太重
Big Key 通常指单个 Key 对应的数据量明显大于普通 Key。它可能是一个超大的 String,也可能是包含几十万甚至更多成员的 Hash、List、Set 或 Sorted Set。
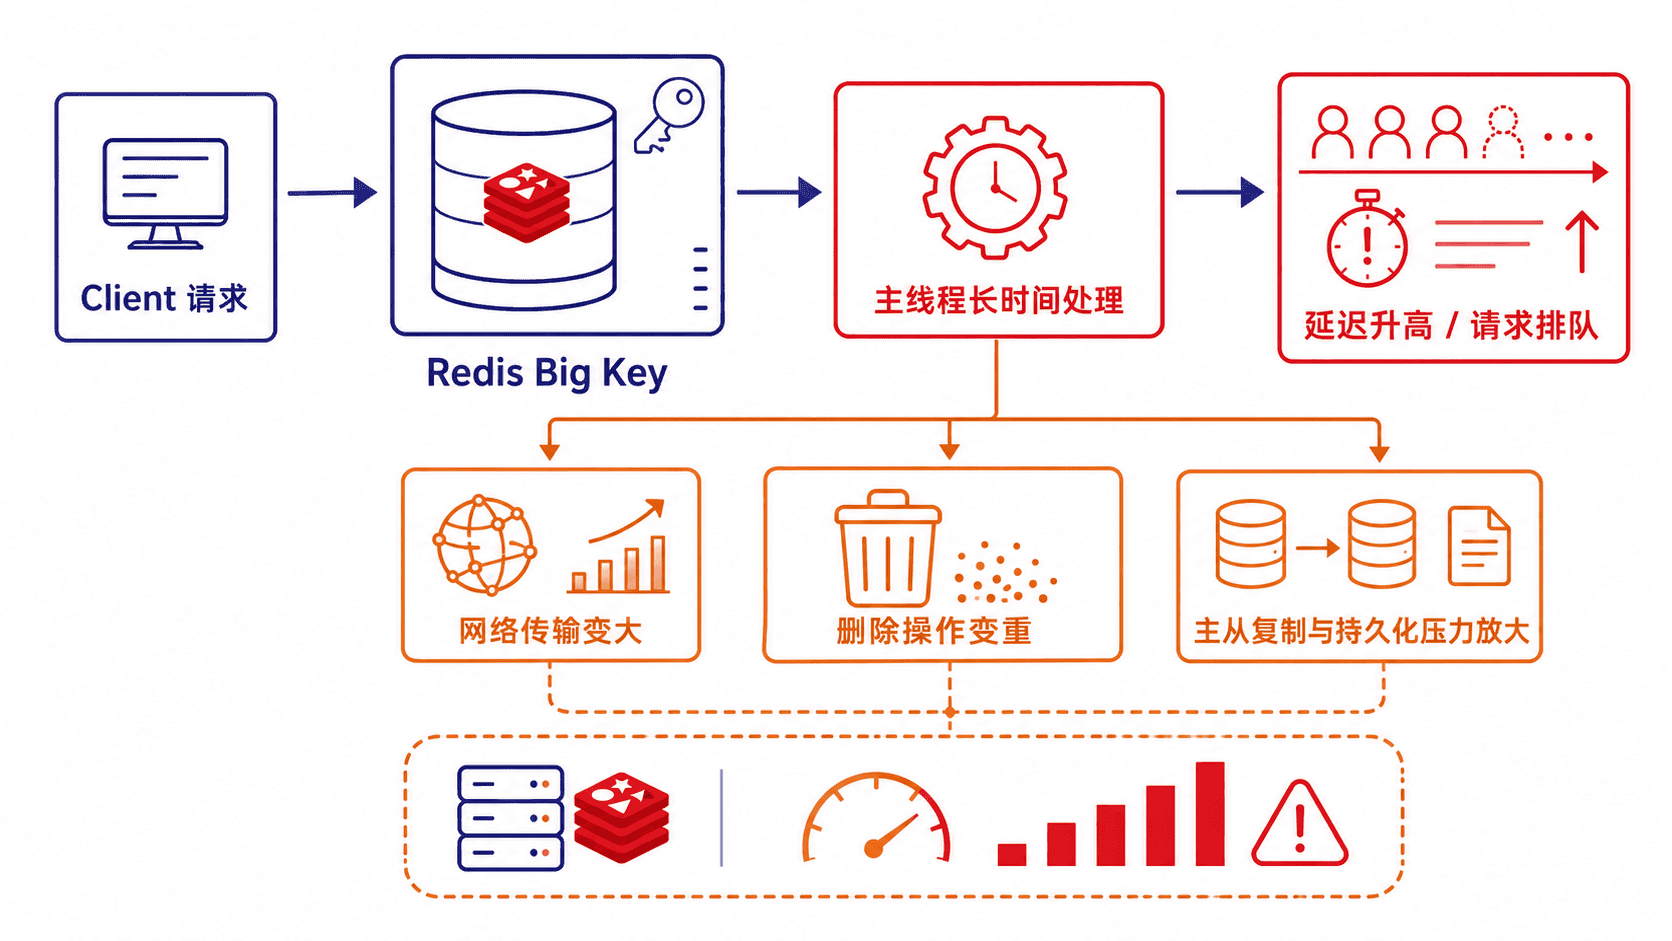
问题不只是它占用了更多内存,而是 Redis 对很多命令的处理仍然集中在主线程执行。只要某次操作需要处理这个 Key 的大量数据,执行时间就会被拉长,其他请求只能排队等待。
因此 Big Key 的本质风险可以概括为:一个局部数据问题,会通过单线程执行模型放大成整个实例的延迟问题。
读取 Big Key 会制造延迟尖峰
假设一个 String Key 保存了几十 MB 的 JSON。一次 GET 看起来只是普通读取,但 Redis 需要把整块数据从内存取出、构造响应,再通过网络发送给客户端。
数据越大,单次请求占用主线程和网络连接的时间就越长。并发一高,其他本来只需要几百微秒的小请求也可能因为排队而被拖慢。
对于集合类型也是一样。像 LRANGE key 0 -1、SMEMBERS key、HGETALL key 这类一次取全量数据的命令,在 Key 很大时尤其危险。
例如:
redis-cli STRLEN cache:article:big-payload
redis-cli LLEN queue:history
redis-cli SCARD user:huge-tags
redis-cli HLEN profile:massive-hash
预期输出:
<BYTES>
<COUNT>
<COUNT>
<COUNT>
实际数值会根据线上数据不同而变化。这里的目的不是直接判定“多大就一定危险”,而是先确认单 Key 的规模是否明显偏离同类数据。
删除 Big Key 也可能卡住 Redis
很多人会关注读取,却忽略删除。
传统 DEL 删除一个大集合时,Redis 需要释放这个 Key 关联的大量对象和内存。如果 Key 很大,释放过程本身就可能造成明显阻塞。
对于这类场景,更稳妥的方式通常是优先考虑 UNLINK,让键从主字典中快速移除,再由后台线程异步释放内存。
redis-cli UNLINK cache:article:big-payload预期输出:
(integer) 1这表示 Key 已从主键空间移除,内存释放会异步进行。
Big Key 会放大网络和复制成本
Redis 返回一个普通小 Key 时,网络开销通常很低;但如果一个请求返回几十 MB 数据,网卡、客户端连接和应用线程都会被这次响应长时间占用。
如果 Big Key 频繁更新,影响还会继续传导到复制链路。主节点需要把写命令传播给从节点,从节点也需要执行对应变更。数据越大、变更越频繁,主从同步压力越明显。
持久化同样会受到影响。大 Key 会增加 RDB 快照的数据量,某些高频更新场景也会加重 AOF 写入和重写压力。
所以 Big Key 很少只造成一个指标异常,它通常会同时影响延迟、带宽、复制和持久化。
最危险的是“热 Big Key”
并不是所有大 Key 都同样危险。
一个 20 MB、每天只访问一次的冷 Key,风险可能还可控;一个 5 MB、每秒被访问几百次的热点 Key,反而更可能拖垮实例。
判断风险时应该同时看两个维度:
- 体积有多大
- 访问频率有多高
大且热,才是生产环境最需要优先治理的组合。
识别 Big Key 不要直接扫描全量数据
生产环境排查 Big Key 时,要避免使用会一次性返回大量 Key 的高风险方式。
可以先使用 Redis 自带的扫描能力辅助发现异常 Key,例如:
redis-cli --bigkeys预期输出:
<SCAN_PROGRESS_AND_BIG_KEY_SUMMARY>实际输出会随着数据集变化,其中会按数据类型展示扫描进度和发现的较大 Key。
需要注意,--bigkeys 更适合发现“成员数多”或“长度大”的候选项,并不等同于精确内存分析。进一步确认单个 Key 的内存占用时,可以结合 MEMORY USAGE:
redis-cli MEMORY USAGE cache:article:big-payload预期输出:
<BYTES>实际值可能不同。
治理 Big Key 的核心是拆分和限制增长
真正有效的治理,不是等 Key 变大以后再删,而是在设计阶段限制单 Key 的增长边界。
常见方法包括:
- 把一个超大集合按业务维度拆成多个 Key
- 对 List、日志、历史记录设置固定长度,只保留最近 N 条
- 超大 JSON 不再整体缓存,改为按对象或字段拆分
- 对无上限增长的 Set、Hash 建立容量阈值和监控
- 对历史冷数据迁移到数据库、对象存储或其他更适合的大数据存储中
- 给 Big Key 和 Hot Key 分别建立指标,不要只看 Redis 总内存
例如,一个用户历史行为列表不应该无限增长,可以只保留最近 1000 条:
redis-cli LPUSH user:10001:history event-1001
redis-cli LTRIM user:10001:history 0 999
预期输出:
(integer) <COUNT>
OK
<COUNT> 会随当前 List 长度变化,但经过 LTRIM 后,列表最多只保留索引 0 到 999 对应的 1000 个元素。
判断 Big Key 风险要看系统级影响
Big Key 最容易被低估,是因为它看起来只是一条数据。但 Redis 的性能问题往往不是从“整个实例都很大”开始,而是从少数异常 Key 开始。
当单 Key 操作时间过长,它会占住主线程;当返回数据过大,它会占住网络;当更新频繁,它又会放大复制和持久化压力。
最终可以记住一句话:Big Key 的危险不在于它自己有多大,而在于一次操作它时,会让多少其他请求一起变慢。 设计 Redis 数据结构时,应尽量让单 Key 的大小可控、增长有上限、访问可分散。