
Redis 与缓存 / 技术文章
Redis String、List、Set 到底应该怎么选
这篇文章面向已经会用 Redis、但在 String、List、Set 之间容易凭感觉选型的后端开发者。你会从“是否需要顺序、是否允许重复、访问方式是什么”三个维度判断数据结构,并知道哪些常见场景应该避免用错。
先看三个最核心的区别
String、List、Set 都能保存数据,但它们解决的问题完全不同。选型时不要先问“哪个性能更高”,而要先问业务需要什么语义。
| 数据结构 | 是否有序 | 是否允许重复 | 典型访问方式 | 常见场景 |
|---|---|---|---|---|
| String | 单值 | 不涉及 | 按 Key 直接读写 | 缓存对象、计数器、状态值、Token |
| List | 有序 | 允许 | 按两端或索引读写 | 消息列表、时间序列、最近记录 |
| Set | 无序 | 不允许 | 按成员判断、集合运算 | 去重集合、标签、黑白名单、共同关系 |
最简单的判断方式是:一个 Key 对应一个值优先看 String;需要顺序看 List;需要去重和成员关系看 Set。
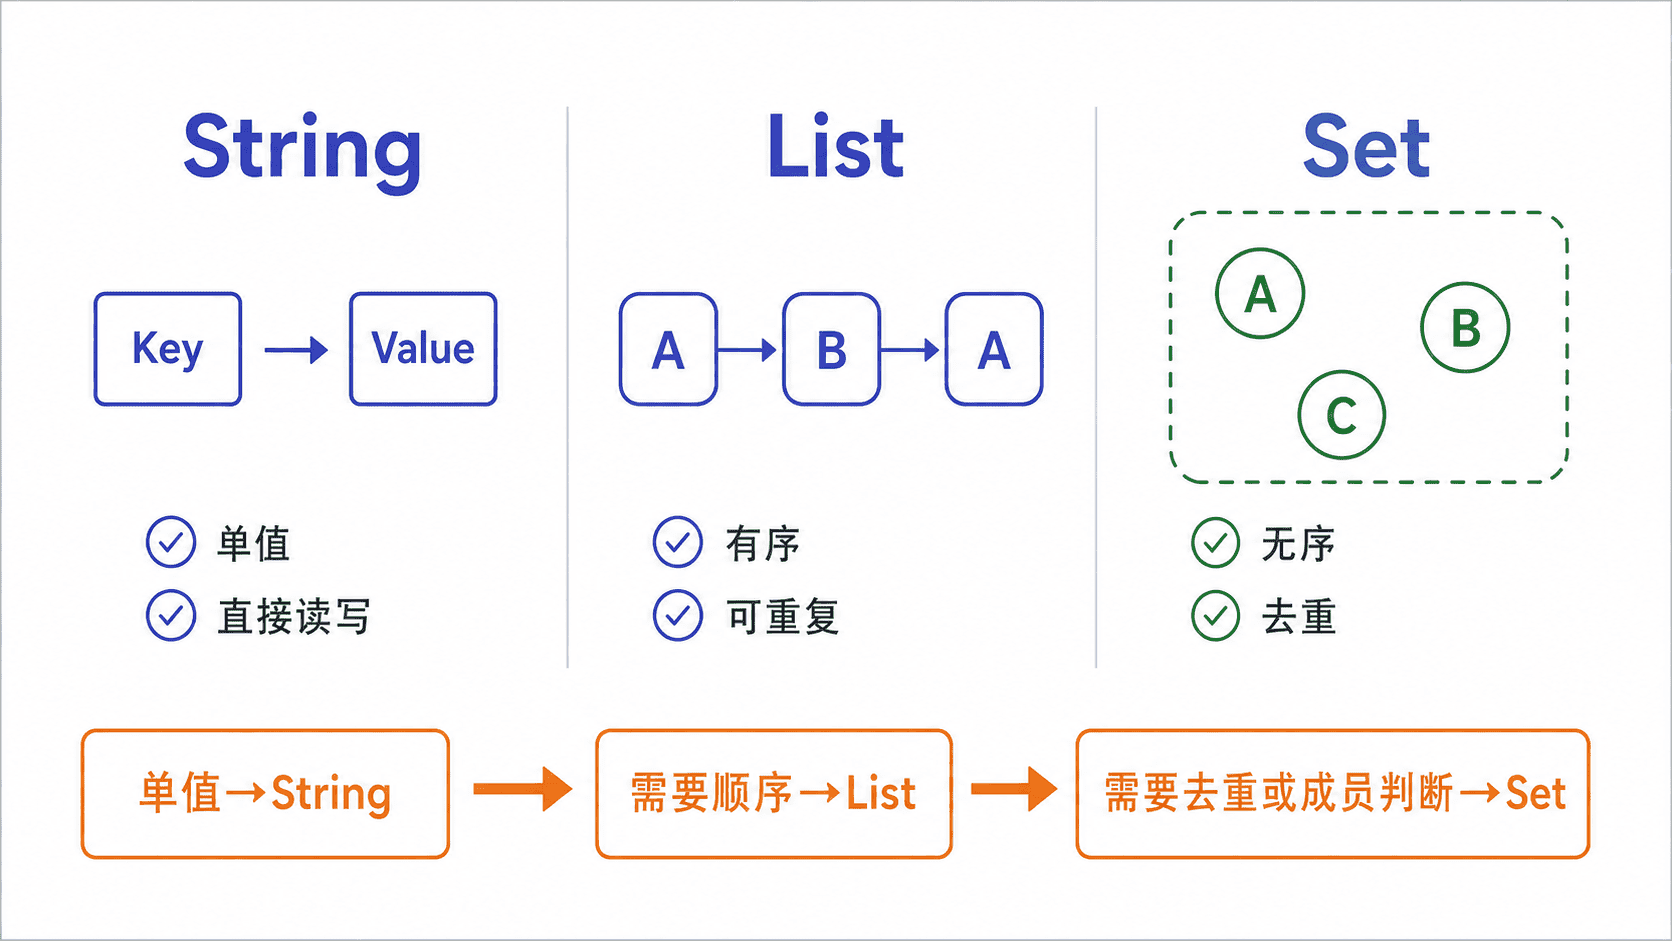
String:一个 Key 对应一个值
String 是 Redis 最基础、也最常用的数据结构。它适合“拿到 Key 就直接得到一个完整值”的场景,例如验证码、登录 Token、配置值、序列化后的对象,以及各种计数器。
例如:
redis-cli SET user:10001:nickname Simon
redis-cli GET user:10001:nickname
redis-cli SET article:100:view-count 10
redis-cli INCR article:100:view-count
预期输出:
OK
Simon
OK
11
String 最大的优势是简单直接。如果业务只需要整体读取和整体覆盖,一个 String 往往比拆成更复杂的数据结构更容易维护。
但如果你把一个不断增长的 JSON 数组全部塞进 String,每次新增一条数据都需要先读出、反序列化、修改、再整体写回,这通常说明数据结构已经选错。
List:需要顺序,而且允许重复
List 是有序序列,元素按插入顺序排列,并且允许重复。它非常适合表达“先后关系”。
例如保存某个用户最近访问过的文章:
redis-cli LPUSH user:10001:recent-articles article-101
redis-cli LPUSH user:10001:recent-articles article-102
redis-cli LPUSH user:10001:recent-articles article-101
redis-cli LRANGE user:10001:recent-articles 0 -1
预期输出:
(integer) 1
(integer) 2
(integer) 3
1) "article-101"
2) "article-102"
3) "article-101"
可以看到,List 会保留顺序,也允许 article-101 重复出现。
因此“最近访问”“最近操作”“简单消息队列”“按时间顺序排列的一段数据”都可能适合 List。
Set:需要去重和成员判断
Set 最重要的语义是元素唯一。同一个成员重复写入不会产生第二份数据,所以它很适合标签、关注关系、黑白名单、已处理 ID、权限集合等场景。
例如保存某个用户已经收藏的文章:
redis-cli SADD user:10001:favorites article-101
redis-cli SADD user:10001:favorites article-102
redis-cli SADD user:10001:favorites article-101
redis-cli SCARD user:10001:favorites
redis-cli SISMEMBER user:10001:favorites article-101
预期输出:
(integer) 1
(integer) 1
(integer) 0
(integer) 2
(integer) 1
第三次写入 article-101 返回 0,说明这个成员已经存在,没有重复添加。SCARD 返回集合中只有两个成员,SISMEMBER 可以直接判断某个成员是否存在。
如果业务经常问“这个 ID 是否已经出现过”“两个用户有哪些共同标签”“某个对象属于哪些集合”,Set 通常比 List 更合适。
最容易选错的是 List 和 Set
List 和 Set 都能保存多个元素,所以最容易混淆。判断时只需要抓住两个问题:
- 顺序重要吗? 如果重要,优先 List。
- 重复允许吗? 如果不允许,优先 Set。
例如:
- 最近 20 条搜索记录:通常更适合 List,因为顺序重要。
- 用户拥有的角色集合:更适合 Set,因为角色不能重复,顺序通常也不重要。
- 已发送通知的用户 ID:更适合 Set,因为核心目标是去重和存在性判断。
- 用户连续操作轨迹:更适合 List,因为每一次操作都需要保留,哪怕操作内容相同。
如果你用 List 保存“已处理订单 ID”,后续为了判断一个订单是否处理过,只能不断扫描列表;这通常就是把需要“成员判断”的问题错误建模成了“有序序列”。
不要只看能不能存进去
Redis 的很多数据结构都能“勉强实现”同一个需求,但能实现并不代表选型合理。
例如 String 可以保存 JSON 数组,List 可以人工去重,Set 也可以保存多个状态值,但这些做法往往会让读取、修改和维护复杂化。
更可靠的原则是让数据结构直接表达业务语义:
- 单值、计数、完整对象:优先 String。
- 有顺序、允许重复:优先 List。
- 无顺序、要求唯一、需要成员判断或集合运算:优先 Set。
如果同时需要“有序”和“去重”,就不应该在这三者里硬选,而应该进一步考虑 Sorted Set。
最终可以记成一句话:String 解决单值,List 解决顺序,Set 解决去重。 先确定业务语义,再选择数据结构,比事后用代码补偿更简单也更可靠。