
LEARN / TUTORIALS
系统教程
从基础概念到实践应用,按章节逐步建立知识体系。
人工智能 · 34 门教程
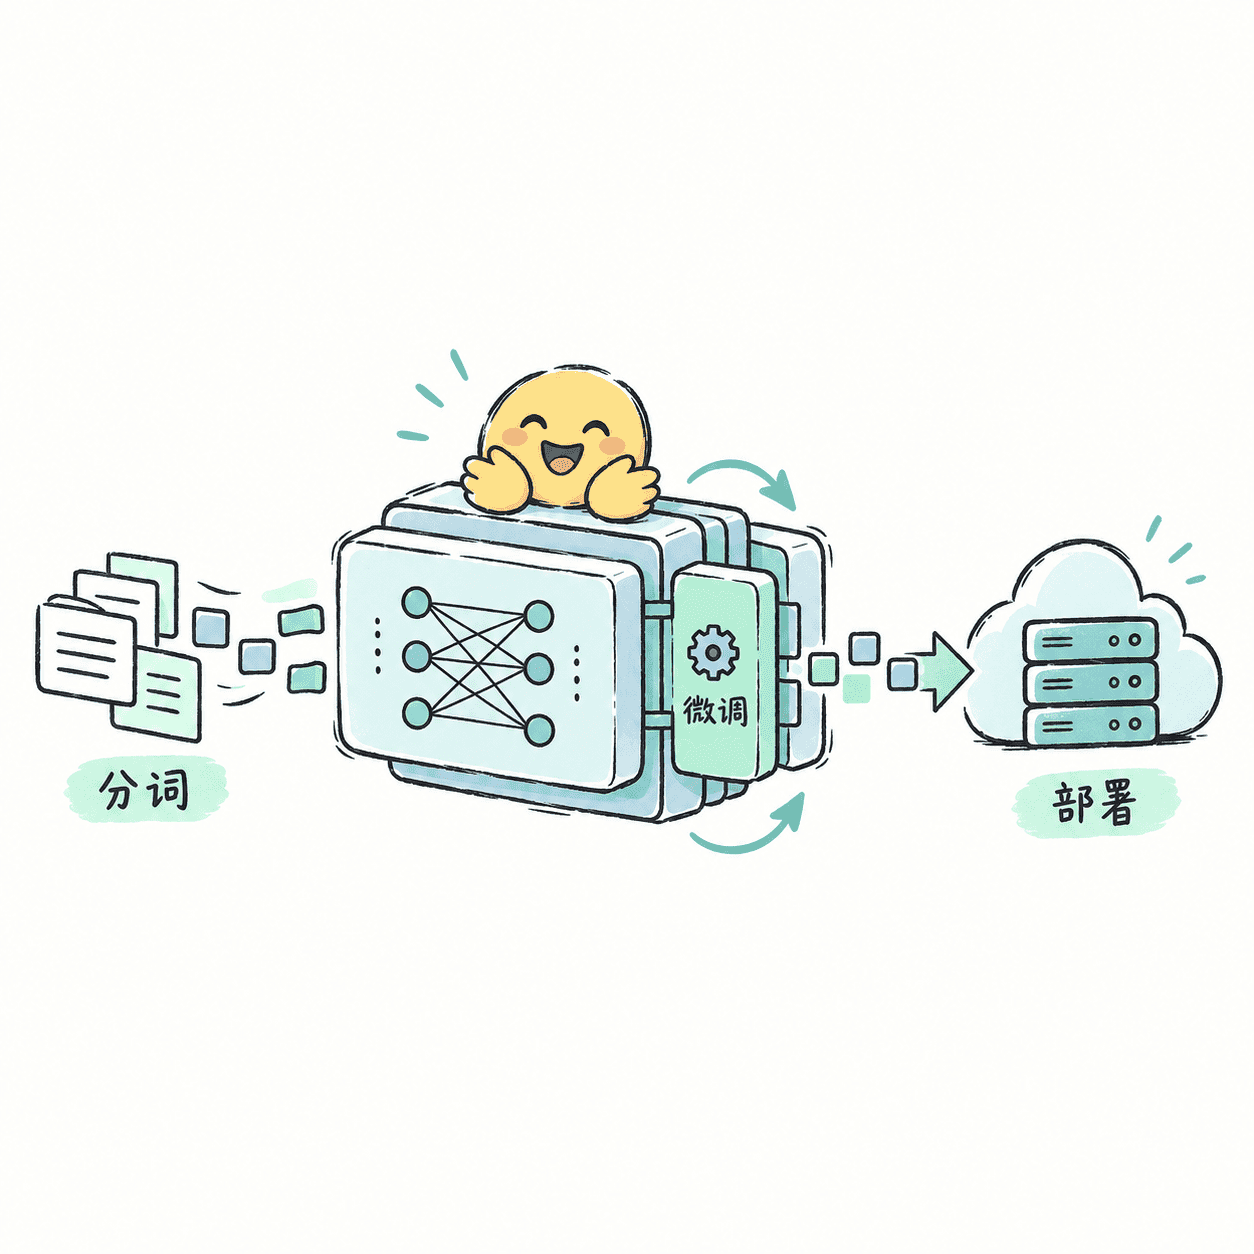
Hugging Face Transformers 实战
模型能在 Notebook 里跑起来,并不等于能稳定训练和上线。课程以文本与生成模型为主线,覆盖 Hub 与 Auto API、Tokenizer、Datasets、Trainer、PEFT/LoRA、量化、评估和服务部署,把公开预训练模型变成可复现、可微调、可压测并能上线交付的模型服务。
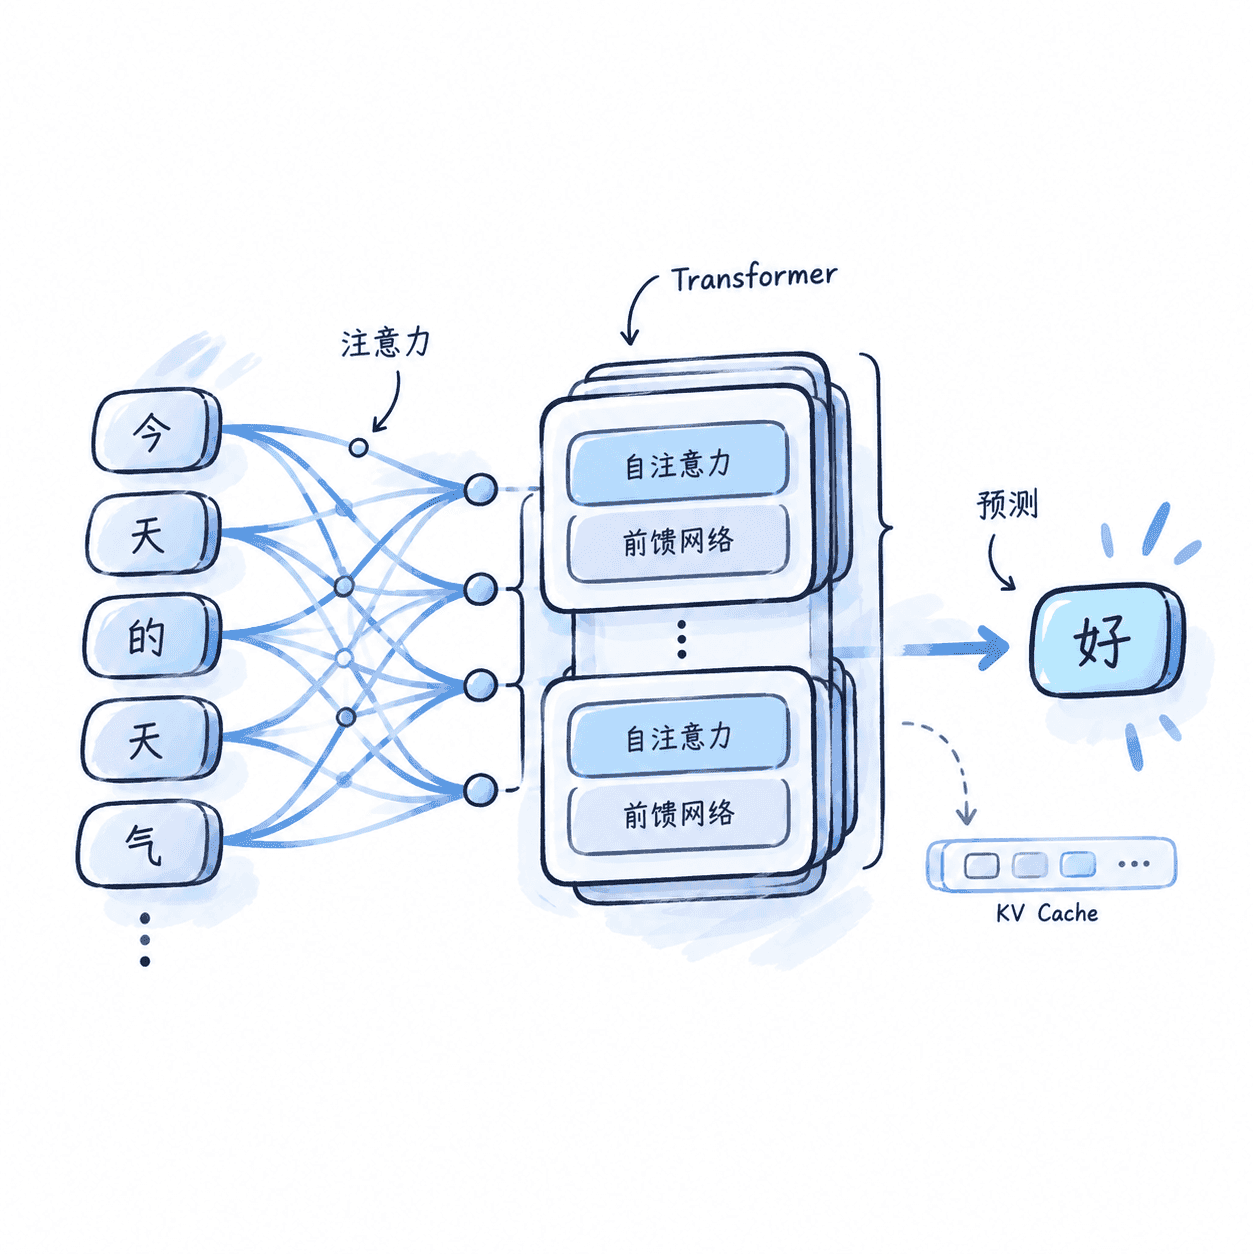
大模型原理:从 Transformer 到 GPT
调用大模型不难,难的是解释模型为何这样生成。内容从词元和注意力出发,拆解 Transformer、GPT 自回归目标、预训练、对齐与 KV Cache,并用微型 GPT 复现链路,使学习者能从张量和概率分布解释模型行为,判断训练与推理取舍。
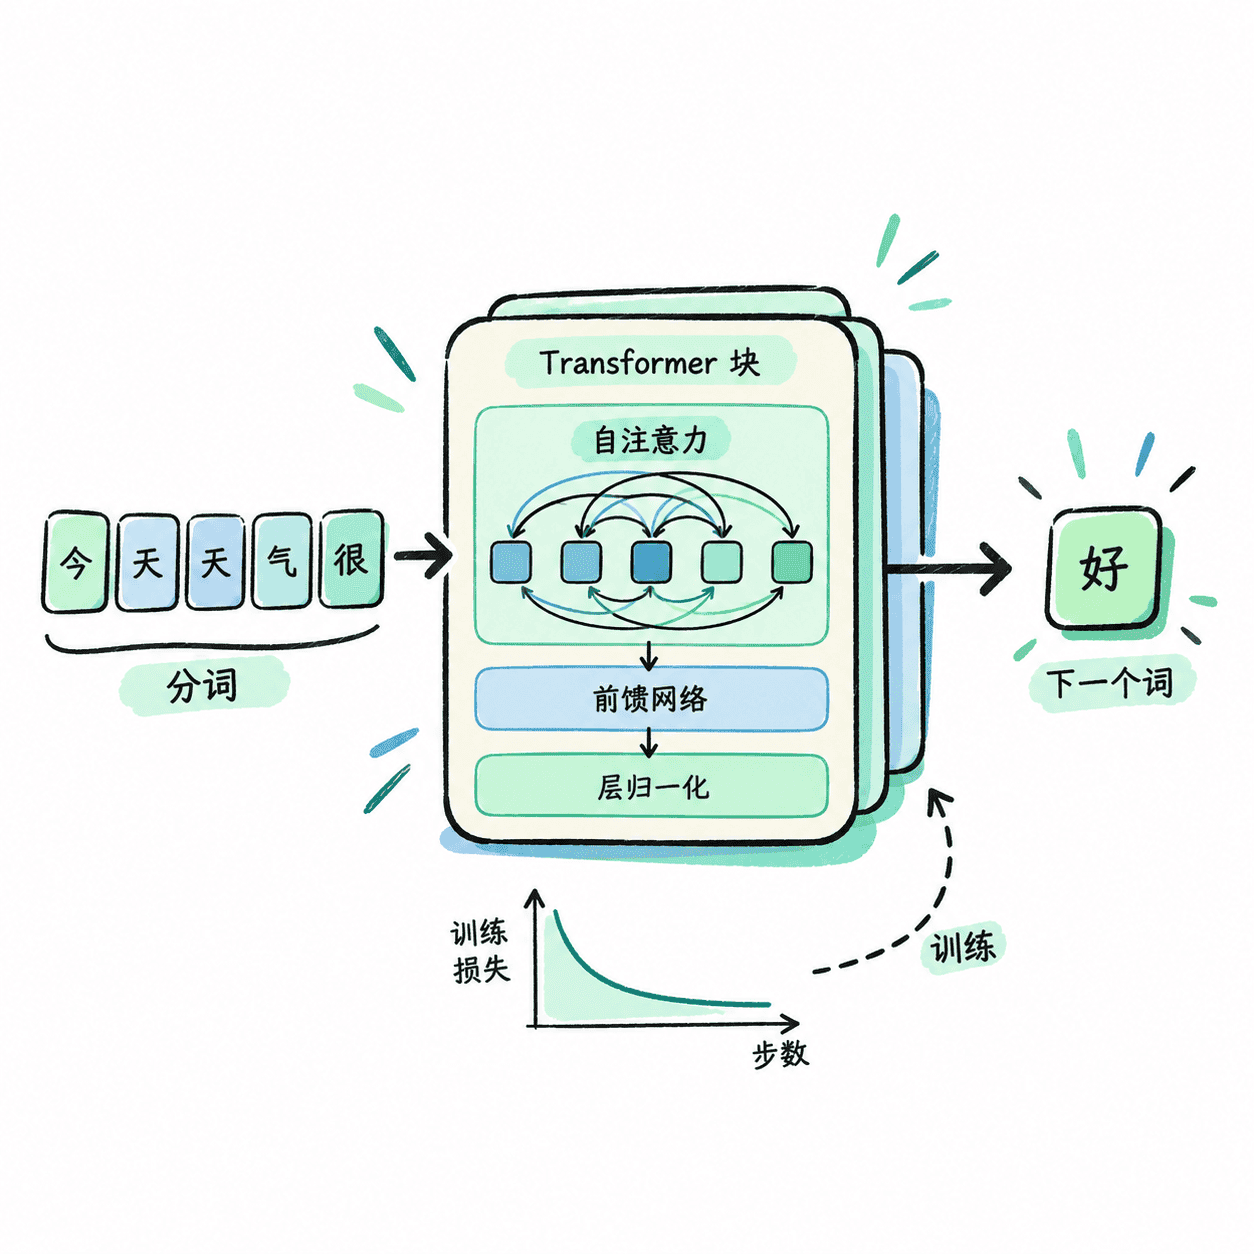
nanoGPT 从零实现 GPT:训练到生成
直接调用大模型 API 很难解释注意力、损失与训练稳定性为何这样工作。课程沿 nanoGPT 的极简路线,从数据编码、自注意力和 Transformer Block 开始亲手组装 GPT,再补齐训练循环、混合精度、多卡训练、检查点、GPT-2 权重加载与采样,最终能独立训练、评估和排查一个小型语言模型。
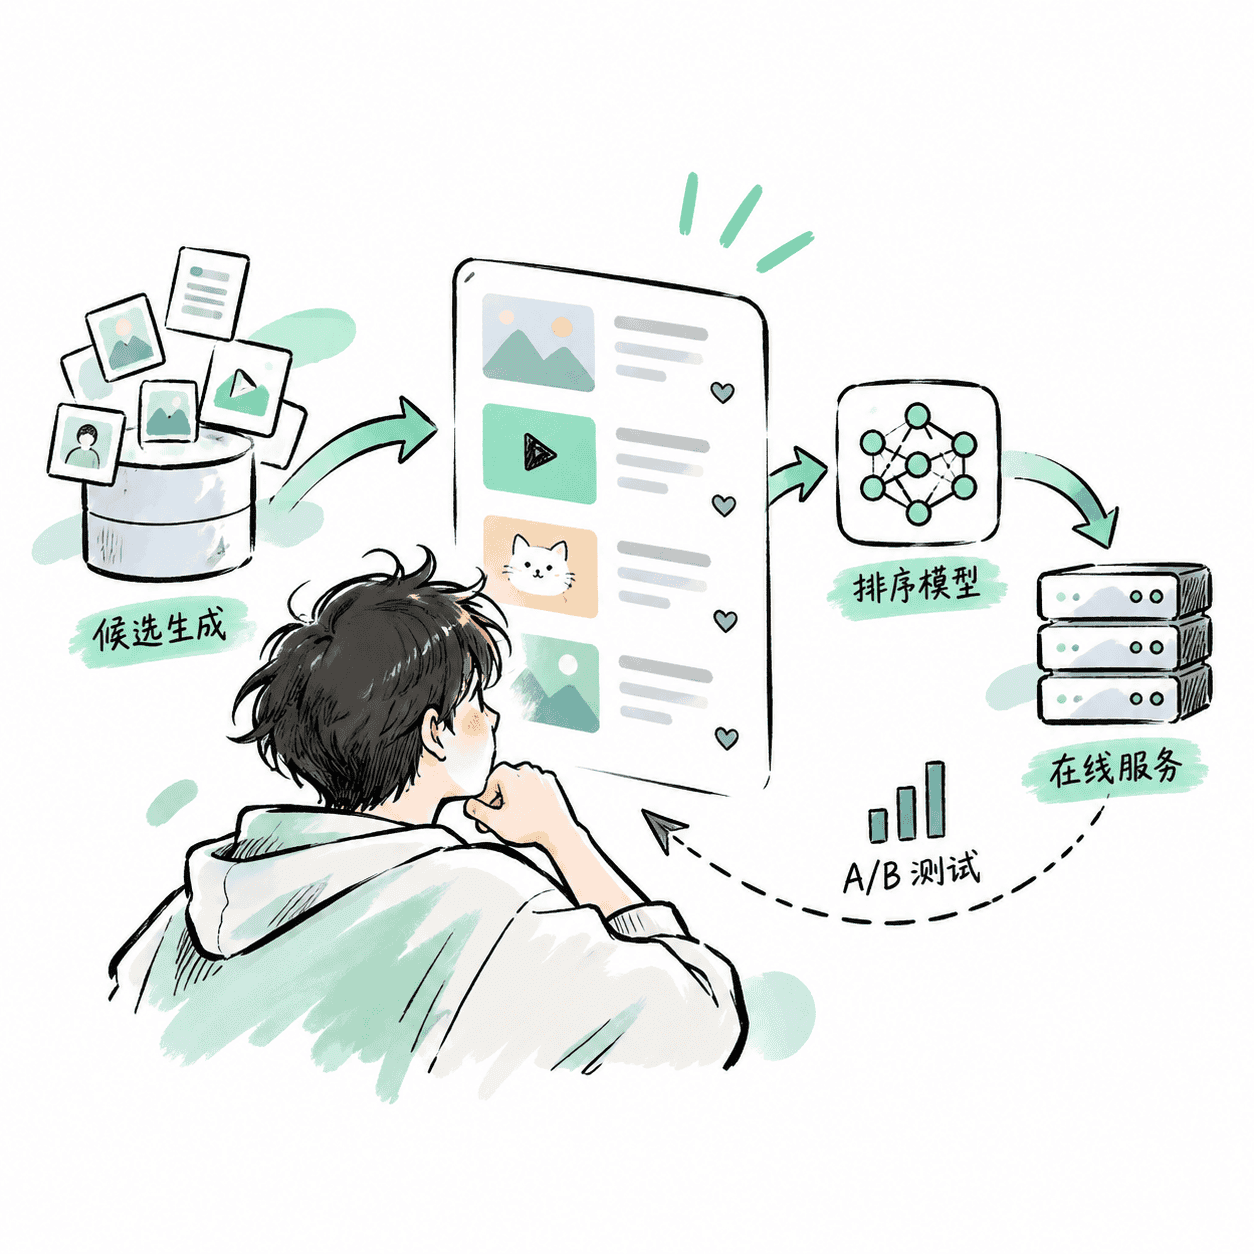
推荐系统实战:从召回排序到在线服务
推荐系统从离线算法走到线上业务,难点不只在模型精度,还在候选生成、特征一致性、实时性能与实验闭环。课程以信息流推荐为主线,覆盖协同过滤、矩阵分解、双塔召回、向量检索、排序模型、离线评估和 A/B 测试,完成可评测、可部署的在线推荐服务。
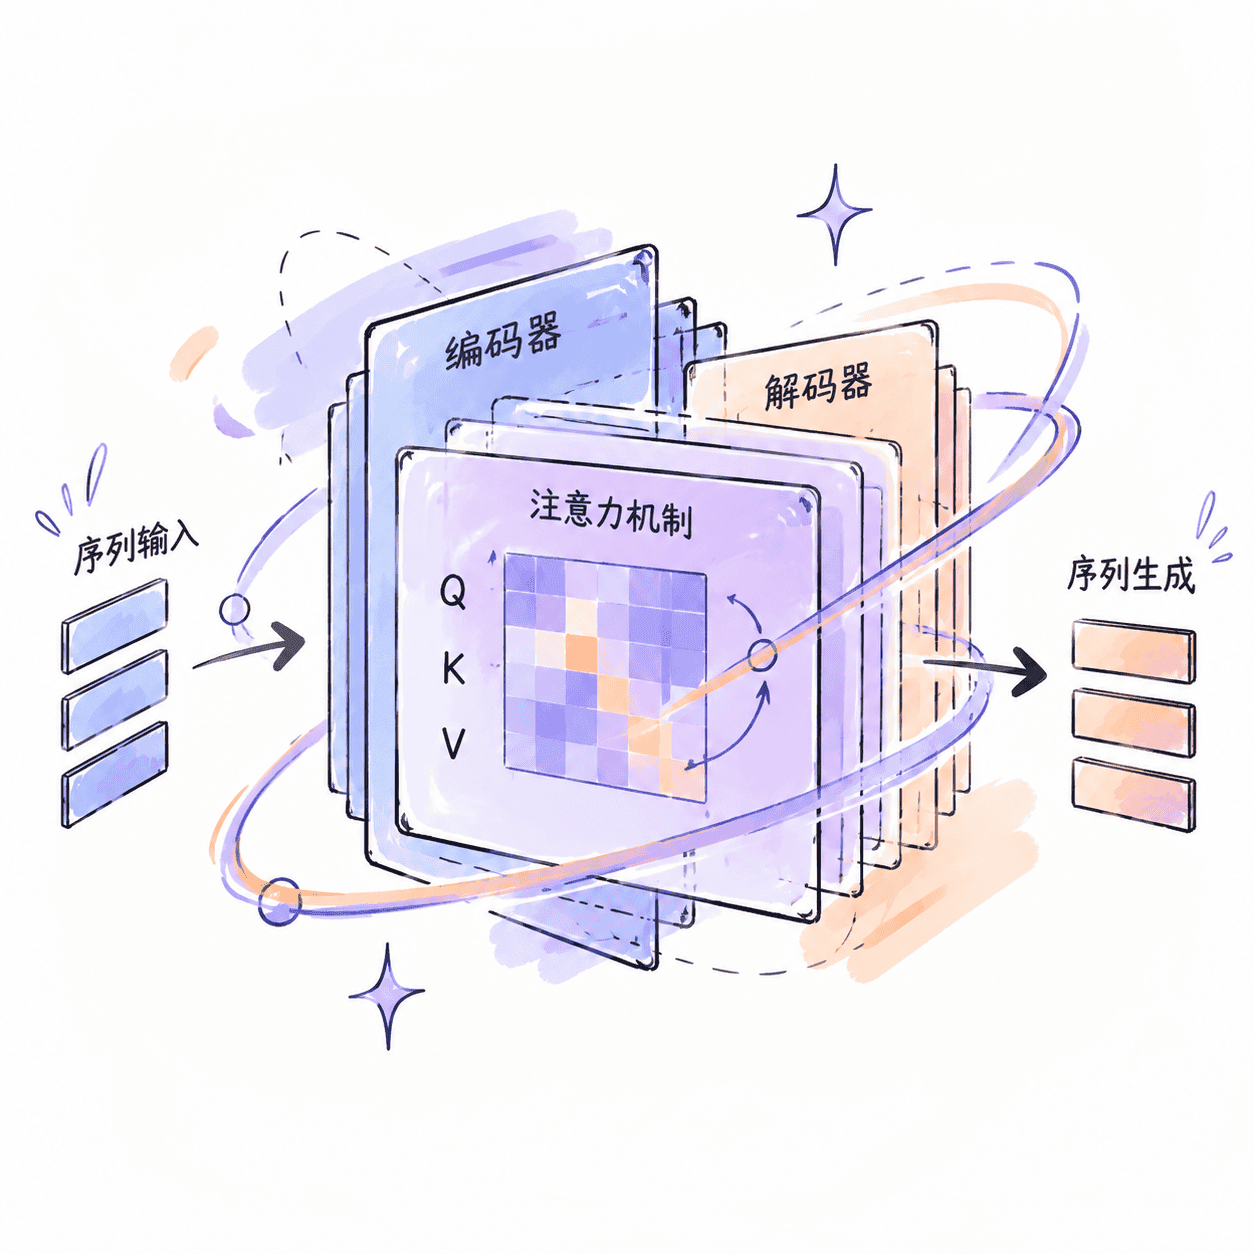
Transformer 原理与实践
本课程面向具备 Python、线性代数和基础深度学习知识的开发者,从序列建模问题出发,逐步讲解注意力机制、位置编码、编码器与解码器结构、训练优化和生成策略。课程结合 PyTorch 手写实现、预训练模型微调、评估部署与故障排查,帮助学习者建立从数学原理到工程落地的完整知识体系。
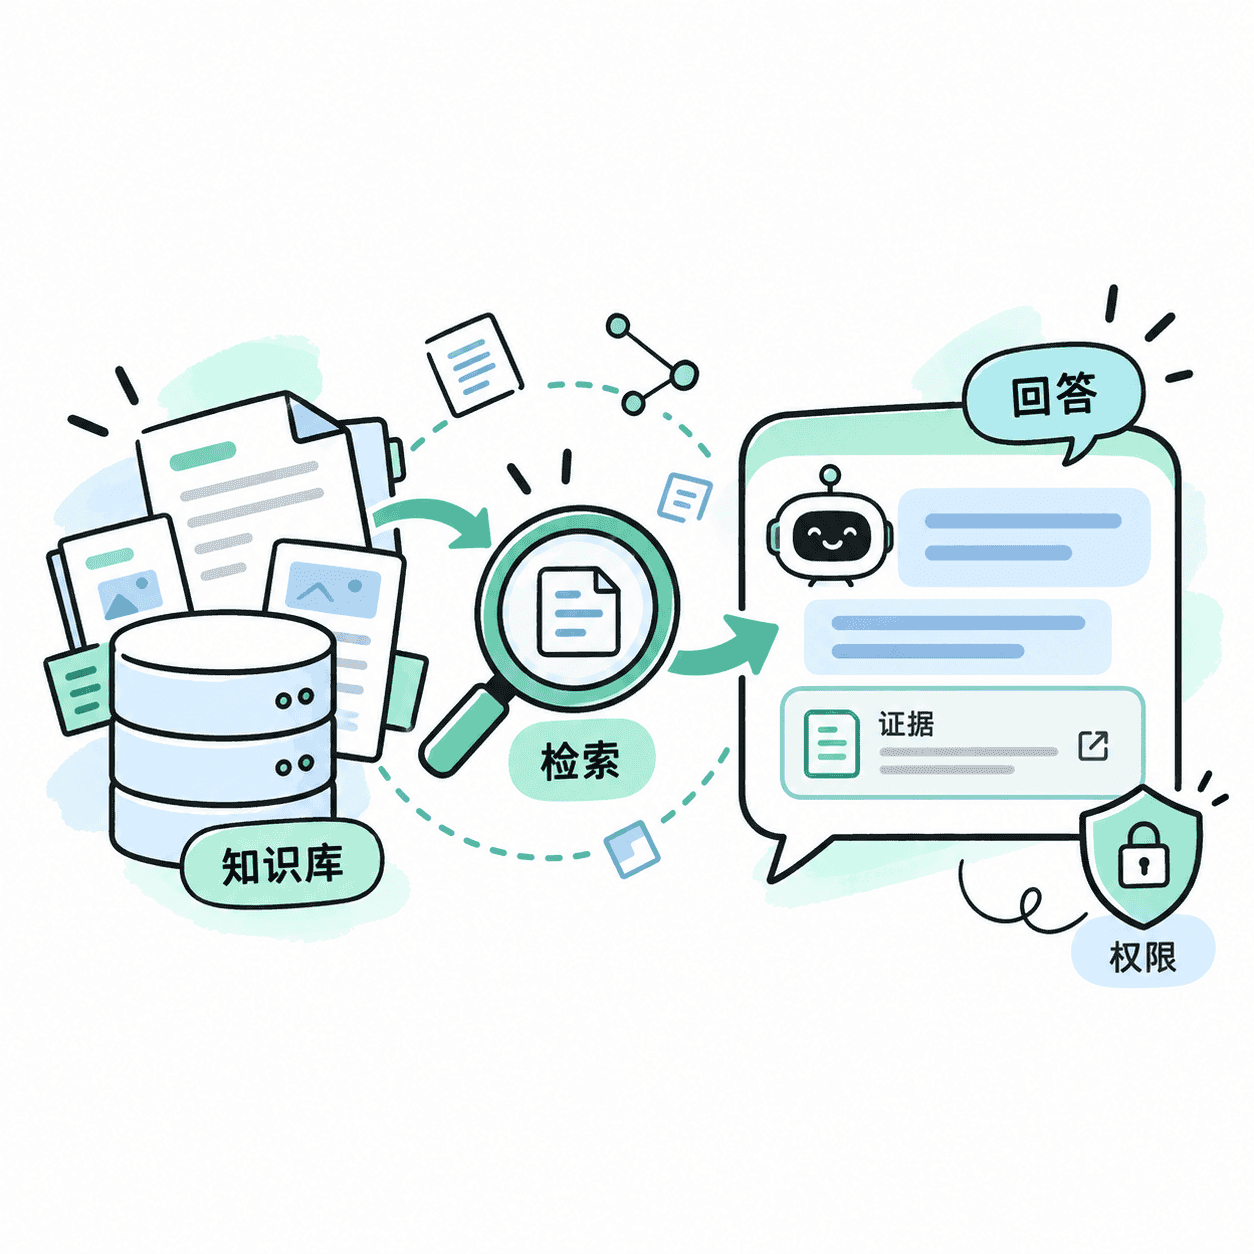
企业知识库智能客服:从 RAG 到上线
企业客服难点不在接入大模型,而在让分散知识可检索、回答有证据、权限不越界、质量可度量。课程围绕 RAG 构建知识加工、混合检索、重排、多轮会话、工具调用、评测与安全链路,并完成可部署、可观测、可回滚的企业知识库客服系统。