
AI Agent / 系统课时
让 AI 分析日志与调用链
让 AI 分析日志与调用链
当系统出现异常时,单看报错信息通常无法快速定位根因。本课将学习如何整理日志、堆栈和调用链上下文,让 AI 辅助分析故障范围,找到更可能的问题位置并设计验证方案。
学习目标
- 理解日志、堆栈和调用链在故障定位中的作用。
- 掌握向 AI 提供调试上下文的方法。
- 能根据 AI 分析结果设计下一步排查动作。
日志分析需要哪些信息
AI 分析故障的准确性取决于输入上下文是否完整。只提供一句异常消息,AI 只能猜测;加入时间线、请求参数、环境信息、关键日志片段和调用链后,AI 才能建立故障模型。常见需要收集的信息包括:
- 错误发生时间和影响范围。
- 完整异常堆栈,而不是只复制最后一行。
- 调用入口、关键函数和上下游依赖。
- 最近发布、配置变化或数据变化。
使用 AI 分析调用链
调用链描述一次请求经过哪些组件和方法。分析时应先让 AI 识别路径,再判断哪个节点最可能产生异常。
例如,一个接口请求经过网关、服务层、数据库访问层,数据库超时可能只是表现,真正原因可能是前面的查询条件异常或连接池配置不足。
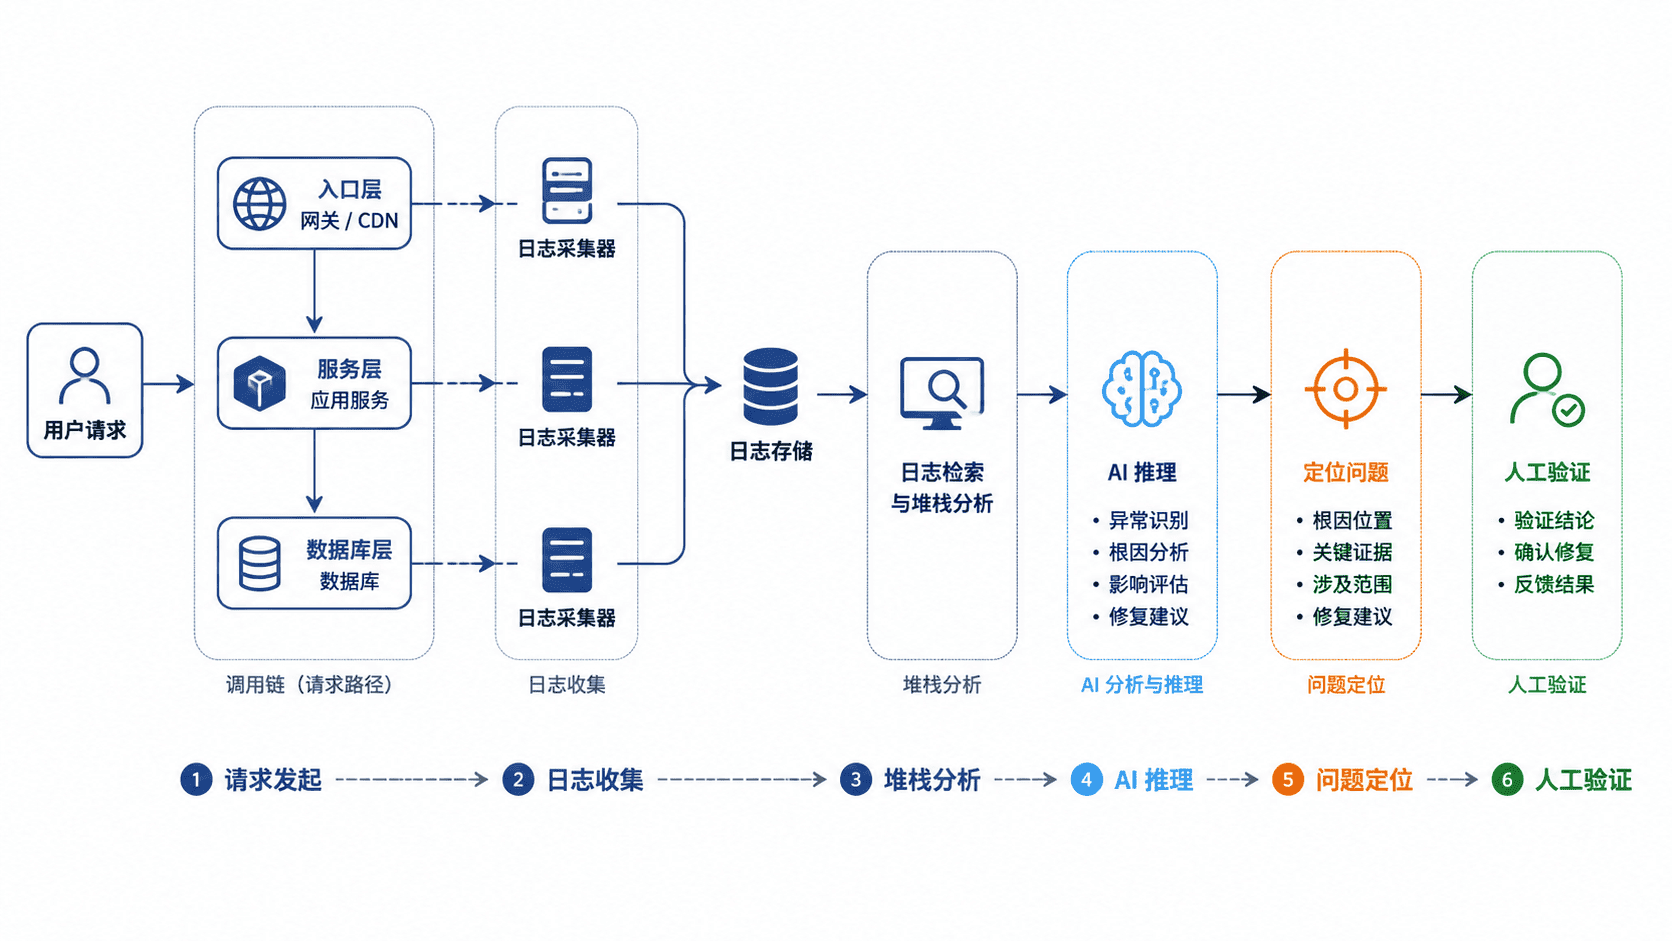
向 AI 提问时,应明确要求它区分事实和推测。例如:
text
请根据以下异常信息分析可能原因。
已知事实:接口返回超时,发生时间为 <TIME>。
调用链:Controller -> Service -> Repository。
请输出:1. 最可能故障位置;2. 判断依据;3. 下一步验证步骤。
预期结果
text
1. 可能故障位置:Repository 数据访问层。
2. 判断依据:日志显示数据库调用耗时持续升高。
3. 下一步验证:检查慢查询和连接池状态。
避免让 AI 误判
AI 生成的是分析建议,不是最终结论。排障过程中需要验证每个假设,例如检查指标、复现问题或增加日志。
常见错误包括只发送错误截图、隐藏关键上下文、忽略最近代码变更,以及把 AI 推测直接当成修复方案。
按自己的节奏,确认真正理解。