
Java 后端 / 系统课时
区分本地事务与分布式事务边界
区分本地事务与分布式事务边界
本课用数据源和服务边界来判断一个事务到底能覆盖什么。掌握边界后,你可以避免把单库 @Transactional 误认为能自动保证跨数据库或跨服务的一致性。
学习目标
- 判断单数据源事务的实际覆盖范围
- 区分跨数据库与跨服务场景中的事务边界
- 能根据一致性要求选择本地事务、消息最终一致或分布式事务方案
本地事务的真正边界
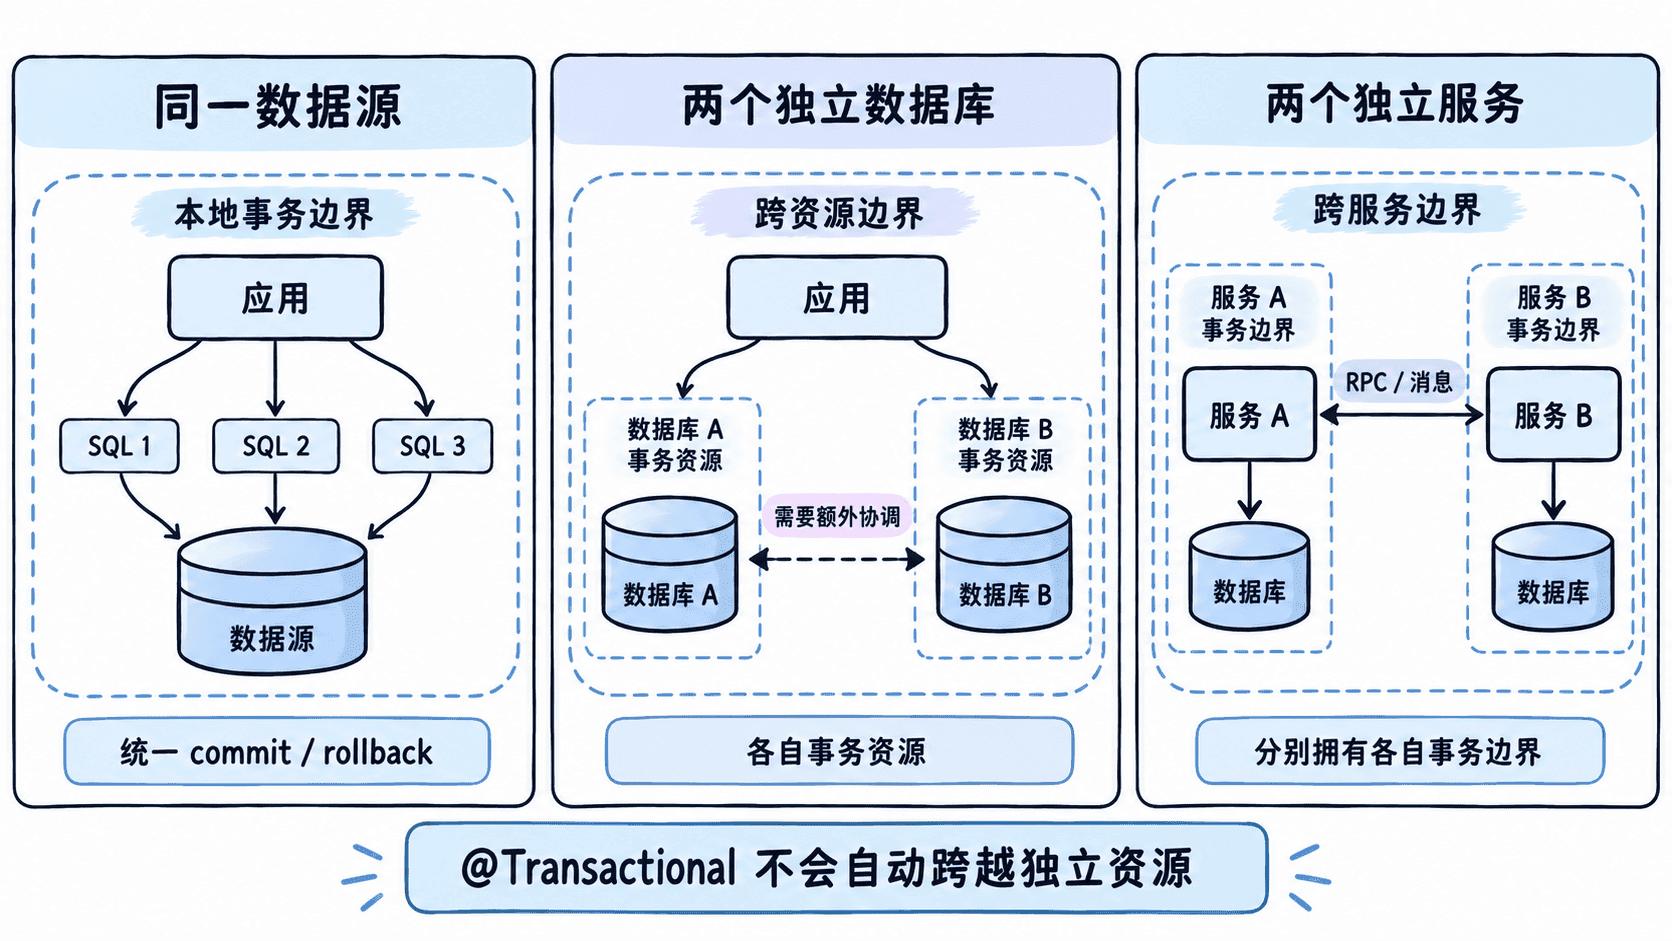
在典型 Spring Boot 单体应用中,@Transactional 最常见的语义是:一个线程中的数据库操作通过同一个事务资源协调提交或回滚。因此,一个事务可以覆盖同一数据源连接上的多条 SQL,但不会凭空扩展到另一个独立数据源。
可以把边界先简化成三种情况:
| 场景 | 单个本地事务能否直接覆盖 | 说明 |
|---|---|---|
| 同一数据源、多个 SQL | 可以 | 共同提交或回滚 |
| 两个独立数据库 | 通常不能 | 两个数据库各自拥有事务资源 |
| 两个独立服务 | 不能 | 每个服务通常有独立事务边界 |
同一数据源:事务可以统一提交
下面这个片段表示同一个事务方法连续修改两张表。两次数据库操作共享当前事务边界。
@Transactional
public void transfer() {
    jdbcTemplate.update(
        "UPDATE account SET balance = balance - ? WHERE id = ?",
        100, 1L
    );
    jdbcTemplate.update(
        "UPDATE account SET balance = balance + ? WHERE id = ?",
        100, 2L
    );
}
预期结果
正常返回:两条 UPDATE 一起提交
发生默认回滚异常:两条 UPDATE 一起回滚
这里的关键不是 SQL 有两条,而是它们是否处于同一个事务资源和事务上下文中。只要连接、事务管理器和数据源配置一致,本地事务就可以提供原子性。
跨数据库:需要显式设计协调方式
假设业务同时写订单库和账务库,即使代码仍然写在一个 @Transactional 方法里,也不能仅凭这个注解就得出“两个数据库一定一起提交”的结论。两个独立数据源通常由不同事务资源管理,是否采用 XA、JTA 等协调机制必须由具体架构和配置决定。
因此,遇到双数据库写操作时,先问三个问题:事务管理器管理的是哪个数据源?第二个数据源是否加入同一全局事务?发生提交失败时是否存在补偿或重试机制?
跨服务:事务边界通常在服务之间断开
当订单服务调用库存服务时,订单服务中的数据库事务不会因为 HTTP、RPC 或消息调用而自动延伸到库存服务。两个服务各自可能成功提交,最终却出现一边成功、一边失败的中间状态。
如何判断是否需要分布式事务
不要先从技术名词开始选型,而要先看失败场景。如果业务必须要求多个独立资源在同一原子提交点完成一致变化,就需要全局事务或其他强协调机制;如果允许短暂不一致,则更常见的是本地事务配合消息、重试、幂等和补偿机制。
可以按下面的判断顺序快速定位:
- 所有写操作是否只涉及一个事务资源?是,则优先考虑本地事务。
- 是否涉及多个独立数据库?是,则检查是否真的要求原子一致,再决定协调方式。
- 是否跨越多个服务?是,则默认认为事务边界已经断开,再设计可靠消息、幂等、重试或补偿。
需要特别注意,所谓“分布式事务”并不等于“事务范围更大”。它解决的是多个独立事务资源之间如何协调一致性的问题,代价也通常包括协调复杂度、故障恢复成本和更严格的运行要求。
最终判断标准很简单:@Transactional 只能证明当前 Spring 事务管理器能够协调其所管理的资源;一旦跨出这个资源边界,就必须显式确认协调机制,而不能默认存在一个覆盖所有数据库和服务的全局事务。