
Rust / 系统课时
分析性能热点
分析性能热点
性能优化先回答“时间和资源到底花在哪里”,而不是凭直觉改代码。本节用可重复的 Release 基线配合采样分析,把问题收敛到具体函数,再区分 CPU 热点、重复分配与锁竞争,最后用同一基线验证改动是否真的有效。
学习目标
- 建立可重复的性能基线,避免用单次运行时间下结论
- 用火焰图或采样结果定位真正占用 CPU 的调用栈
- 识别重复分配和锁竞争,并用复测确认优化收益
先固定可重复的基线
性能数据只有在输入、构建模式和机器负载基本一致时才可比较。优先使用 --release,准备固定规模的数据,并至少重复运行数次;调试构建包含额外检查和不同的优化级别,通常不能代表生产性能。
下面的最小程序把待测函数重复执行,并用 black_box 降低编译器把计算整体消掉的可能性。它不是统计型基准框架,但足以建立一个可复现的本地起点。
use std::hint::black_box;
use std::time::{Duration, Instant};

fn workload(data: &[u64]) -> u64 {
    data.iter()
        .map(|n| n.wrapping_mul(31).rotate_left(7))
        .sum()
}

fn measure(data: &[u64], rounds: usize) -> (u64, Duration) {
    let start = Instant::now();
    let mut checksum = 0;

    for _ in 0..rounds {
        checksum ^= black_box(workload(black_box(data)));
    }

    (checksum, start.elapsed())
}

fn main() {
    let data: Vec<u64> = (0..100_000).collect();
    let (checksum, elapsed) = measure(&data, 200);
    println!("checksum={checksum}, elapsed={elapsed:?}");
}
预期结果:将代码保存为当前 Cargo 包的 src/main.rs 后,可以在 Release 模式执行,并得到校验值与耗时。
运行基线:
cargo run --release预期输出:
checksum=<VALUE>, elapsed=<TIME><VALUE> 和 <TIME> 会随实现与机器不同。真正要记录的是同一环境下多次运行的稳定区间,而不是某一次恰好更快的结果。
用采样结果找到耗时函数
基线稳定后,再用采样工具回答“CPU 时间集中在哪条调用路径”。Linux 上常见做法是 perf 或 cargo flamegraph;macOS 可使用 Instruments,Windows 可使用 Windows Performance Recorder/Analyzer。工具不同,但判断逻辑相同:先找最宽或采样占比最高的栈,再向下追到自己可修改的函数。
为了让 Release 二进制保留更可读的符号,可在 Cargo.toml 中加入:
[profile.release]
debug = 1
已安装 cargo-flamegraph 且系统允许性能采样时,可对当前二进制生成火焰图:
cargo flamegraph --release预期结果:
生成 flamegraph.svg;最宽的栈帧代表采样时间占比较高的调用路径。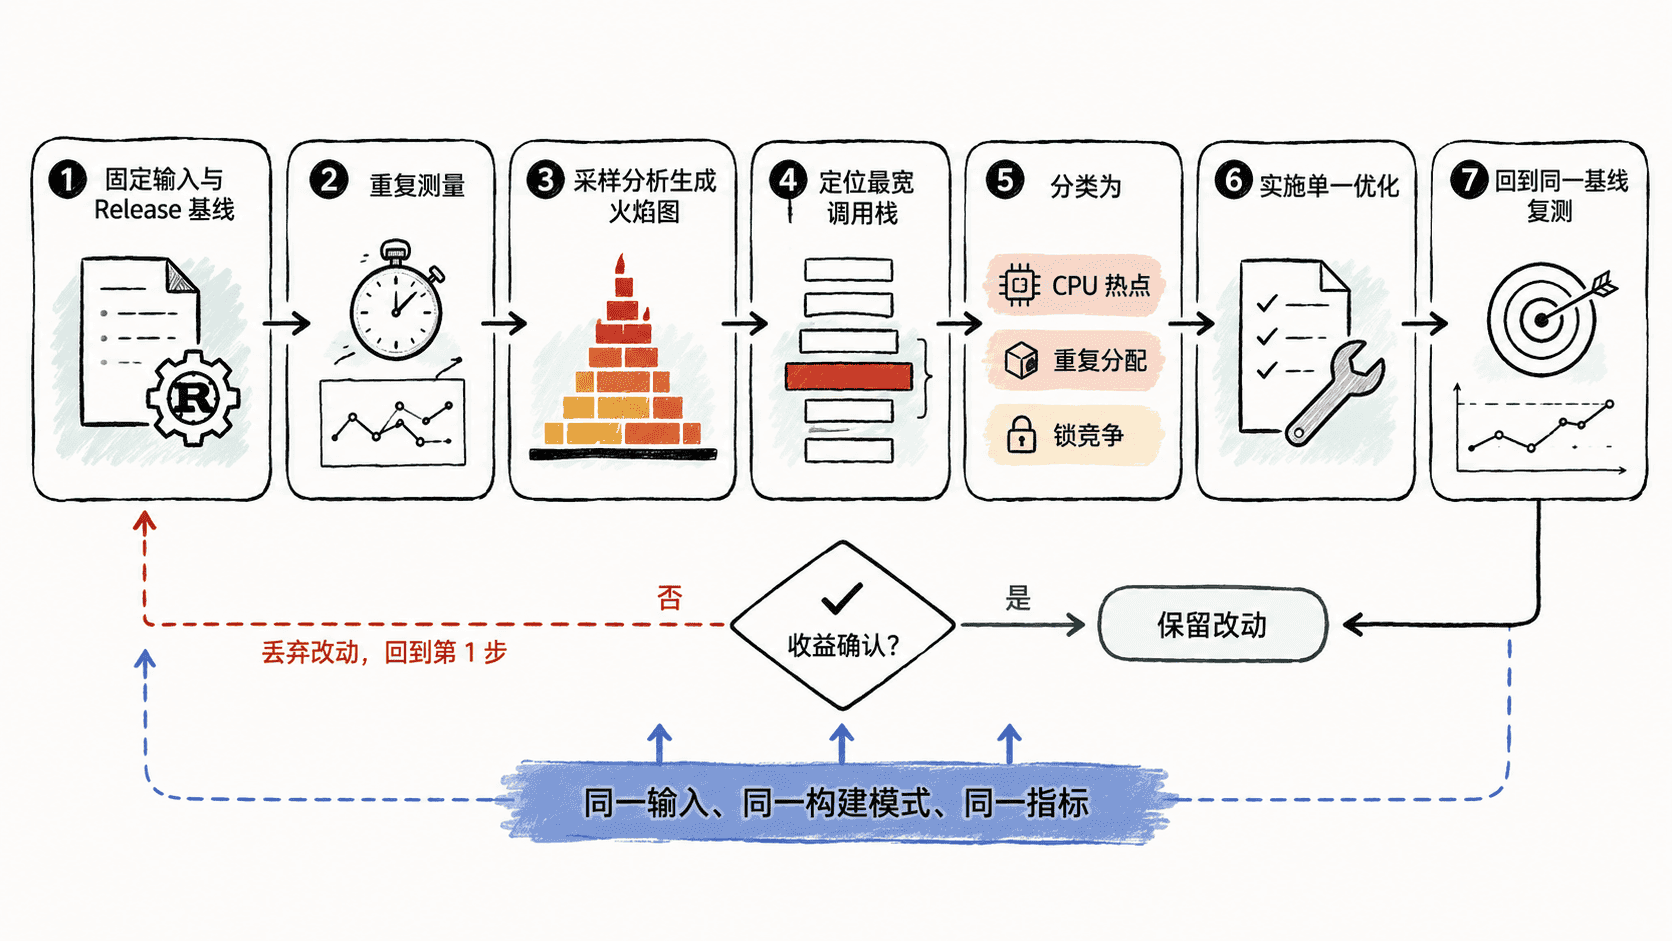
火焰图的“宽”表示采样占比,不等于调用次数,也不直接告诉你一次调用有多慢。一个高频的小函数可能很宽;一个偶发但单次极慢的操作则可能需要结合延迟追踪或分段计时确认。
区分 CPU、分配与锁竞争
看到热点函数后,先判断它属于哪类成本。CPU 热点通常表现为解析、哈希、拷贝或算法循环占据大量样本;先检查是否有重复计算、可以批处理的操作,或复杂度明显过高的路径。
重复分配常见于循环内不断创建 String、Vec、临时缓冲区。若热点附近频繁出现分配器调用,应优先复用缓冲区、提前 with_capacity,或把可借用的数据从拥有型转换为引用;但不要只凭“看起来会分配”就改,最好配合堆分析工具确认分配次数和总字节数。
锁竞争的特征是线程把时间花在等待互斥量,而不是实际计算。Linux 可用 perf lock 等工具观察锁等待;也可以在应用指标中记录锁等待时间。常见修复方向包括缩小临界区、把慢 I/O 移出锁、降低共享可变状态,或把一个全局锁拆成互不相关的多个锁。
用同一指标验证优化
一次只改一个主要因素,然后回到最初的 Release 基线。比较中位数或稳定区间,同时观察吞吐、延迟、内存与正确性是否出现回退。若热点只是从函数 A 移到函数 B,而总耗时没有下降,这不是有效优化。
性能排查的可靠顺序是:先复现并量化,再采样定位,随后判断成本类型,最后用同一基线复测。这样才能把“代码看起来更快”变成可以验证的工程结论。