
Java 后端 / 系统课时
设计自定义通信协议
设计自定义通信协议
本节解决网络程序中消息如何被准确识别和持续演进的问题。通过设计消息结构、长度字段与版本信息,让客户端和服务端能够稳定交换数据,并为后续协议升级保留空间。
学习目标
- 理解自定义协议中消息边界、字段设计和版本控制的作用
- 掌握基于长度字段解决 TCP 粘包拆包问题的方法
- 能够设计具备兼容能力的简单二进制通信协议
为什么需要自定义通信协议
TCP 只负责可靠传输字节流,不理解业务消息边界。一次发送的数据可能被拆成多个网络包,也可能多个消息合并到一次读取结果中,因此应用层必须定义自己的消息格式。
一个可维护的协议通常需要明确消息开始位置、内容长度、业务类型以及版本信息。这样接收方才能根据协议规则恢复完整消息,而不是依赖一次读取返回的数据大小。
设计消息结构
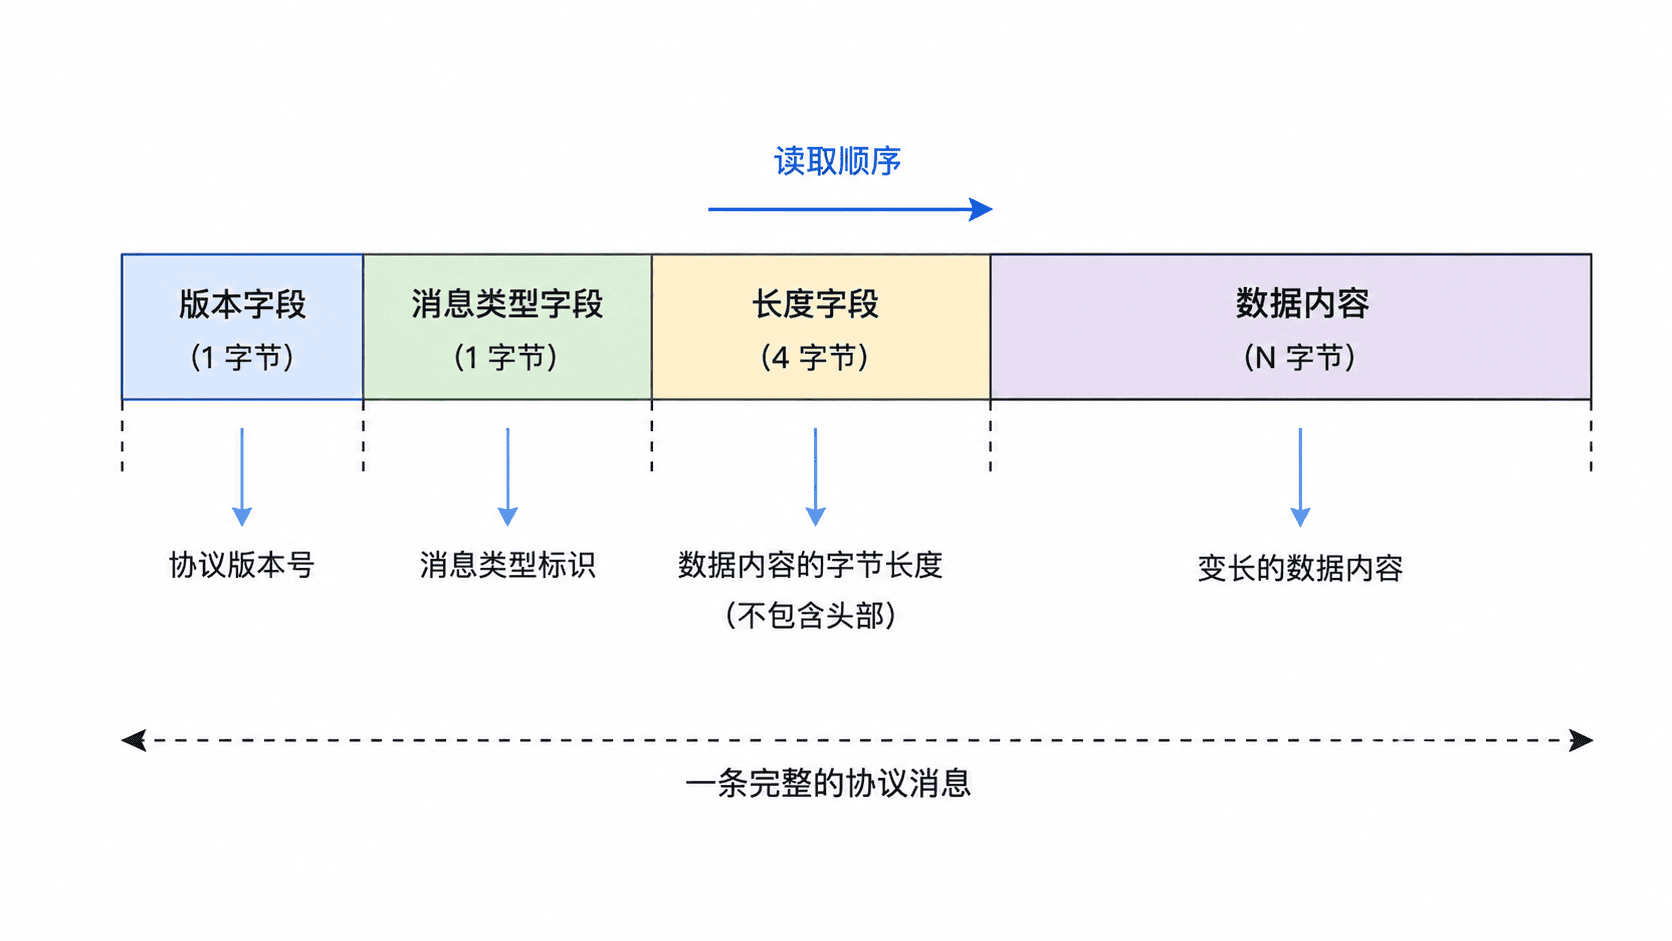
常见协议会将固定长度头部放在消息前方,头部记录后续数据长度。服务端读取头部后,可以准确知道还需要读取多少字节。
下面是一个简单协议定义示例,头部包含版本、类型和正文长度三个字段。
java
public class MessageHeader {
    private byte version;
    private byte type;
    private int length;

    public MessageHeader(byte version, byte type, int length) {
        this.version = version;
        this.type = type;
        this.length = length;
    }
}
预期输出
text
MessageHeader 对象创建成功,保存协议版本、消息类型和正文长度信息使用长度字段处理消息边界
长度字段是网络协议中处理粘包拆包的核心方式。接收端先读取固定长度的头部,再根据 length 字段读取完整消息体。
例如消息格式如下:
| 字段 | 长度 | 作用 |
|---|---|---|
| version | 1 字节 | 标识协议版本 |
| type | 1 字节 | 区分业务消息类型 |
| length | 4 字节 | 表示正文长度 |
| body | N 字节 | 实际业务数据 |
当协议升级增加字段时,可以通过版本号选择不同解析逻辑,避免旧客户端收到新格式数据后无法处理。
版本兼容设计
协议演进时应尽量保持向后兼容。新增字段时可以放在扩展区域,并让旧版本解析器忽略未知内容。
实际生产环境中还需要考虑字段废弃、默认值处理和灰度升级策略。一个稳定协议的关键不是字段数量,而是明确的演进规则。
设计自定义通信协议时,应优先保证消息边界清晰、字段含义稳定、版本变化可控。协议越简单明确,后续使用 Netty 编解码器实现时越容易维护。
按自己的节奏,确认真正理解。