
Java 后端 / 系统课时
使用 Netty 编解码器
使用 Netty 编解码器
本节解决 Netty 通信中字节数据与业务对象转换的问题,明确 Pipeline 中编解码器的职责,并掌握从 ByteBuf 到业务对象的正确处理链路。
学习目标
- 理解 ChannelPipeline 中 Encoder、Decoder 与 ByteBuf 的协作关系
- 掌握基于 MessageToMessageCodec 和 ByteToMessageDecoder 的编解码设计方式
- 能够根据协议边界处理完整消息、半包数据和业务转换
Netty 编解码处理流程
网络传输的数据本质是字节流,而业务代码通常处理对象。Netty 通过 Pipeline 中不同 Handler 完成数据转换:入站方向通常由 Decoder 将 ByteBuf 转换为业务对象,出站方向由 Encoder 将对象转换为待发送数据。
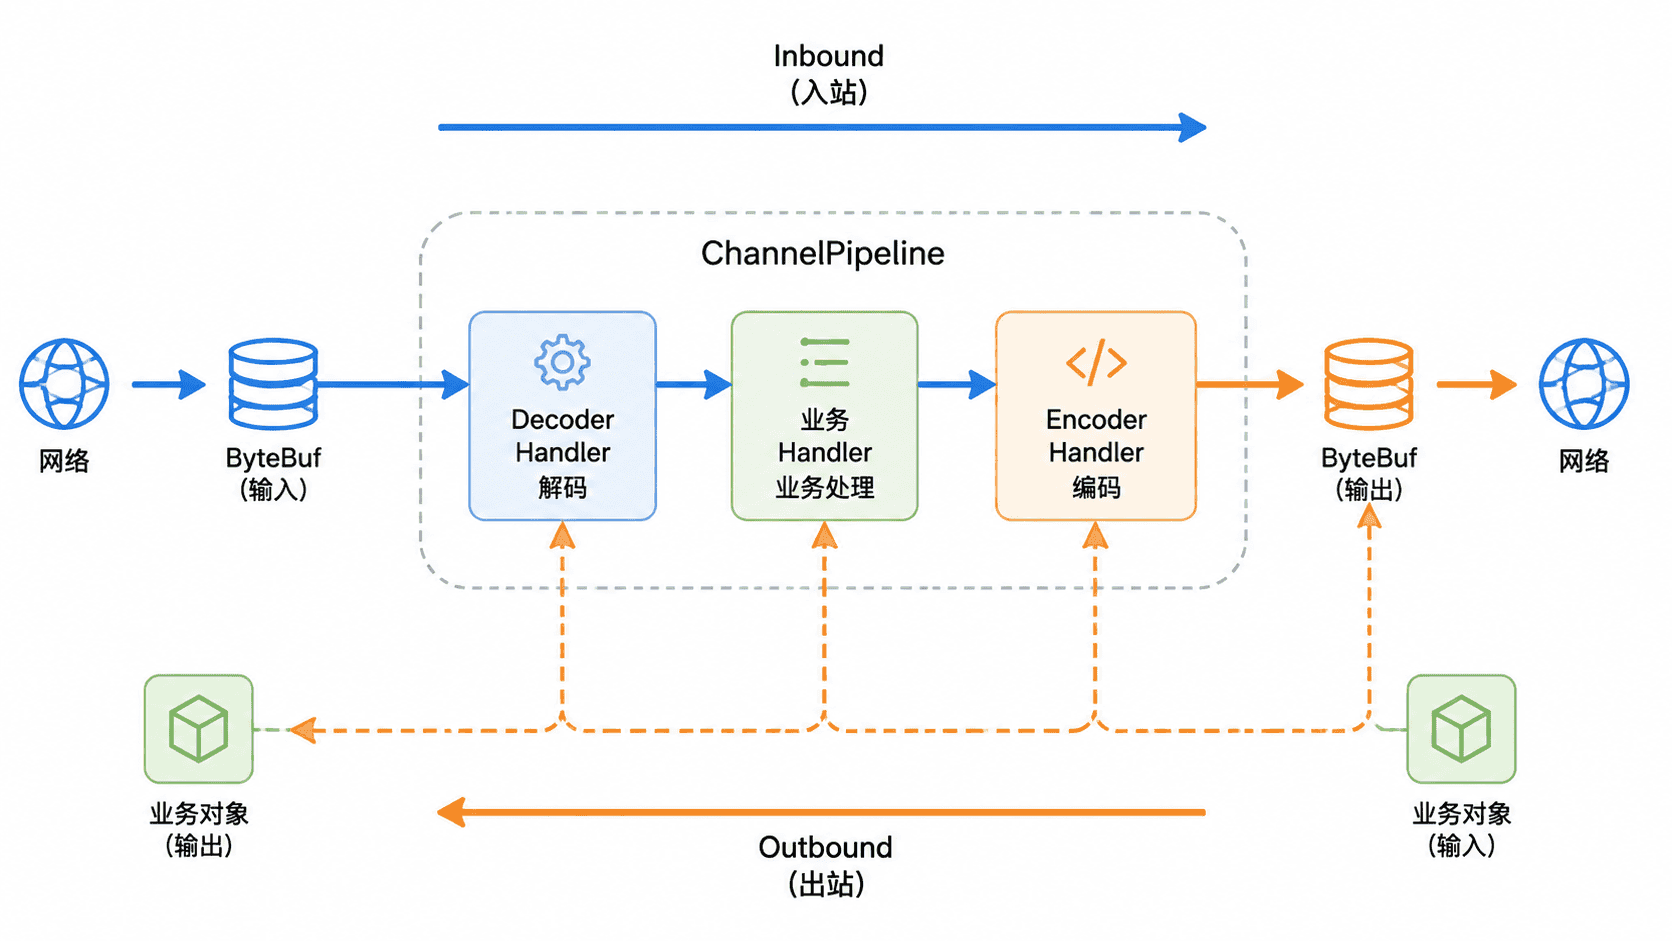
编解码器只负责数据格式转换,不应该承担订单处理、权限校验等业务逻辑。业务 Handler 接收转换后的对象后,再执行具体业务操作。
使用 Decoder 转换入站消息
MessageToMessageDecoder 适用于上游 Handler 已经将原始数据转换成指定消息类型的场景。例如前一个 Decoder 已完成字符串解析,当前 Handler 再负责生成业务对象。如果直接处理网络字节流,应优先使用 ByteToMessageDecoder 处理 ByteBuf 和拆包问题。
import io.netty.channel.ChannelHandlerContext;
import io.netty.handler.codec.MessageToMessageDecoder;
import java.util.List;

public class UserDecoder extends MessageToMessageDecoder<String> {
    @Override
    protected void decode(ChannelHandlerContext ctx, String message, List<Object> out) {
        // 将已经解析好的消息转换为业务对象
        out.add(new UserMessage(message));
    }

    static class UserMessage {
        private final String value;

        UserMessage(String value) {
            this.value = value;
        }

        public String getValue() {
            return value;
        }
    }
}
预期输出
输入消息: client-message
输出对象: UserMessage(value=client-message)
实际生产链路中,常见结构是 ByteToMessageDecoder 负责读取 ByteBuf 并判断消息边界,再交给后续 Handler 完成对象转换。
ByteBuf 的核心使用方式
ByteBuf 是 Netty 对字节缓冲区的抽象,通过 readerIndex 和 writerIndex 分离读写位置,比传统 ByteBuffer 更适合网络场景。
常用概念包括:
| 概念 | 作用 |
|---|---|
| readerIndex | 当前可读取数据的位置 |
| writerIndex | 当前写入数据的位置 |
| readableBytes | 当前可读取字节数量 |
读取数据前需要检查可读长度,避免因为半包数据导致越界读取。
import io.netty.buffer.ByteBuf;
import io.netty.buffer.Unpooled;
import java.nio.charset.StandardCharsets;

public class ByteBufDemo {
    public static void main(String[] args) {
        ByteBuf buffer = Unpooled.buffer();
        buffer.writeBytes("netty".getBytes(StandardCharsets.UTF_8));

        byte[] data = new byte[buffer.readableBytes()];
        buffer.readBytes(data);

        System.out.println(new String(data, StandardCharsets.UTF_8));
    }
}
预期输出
netty编解码器设计边界
可靠的 Codec 需要处理协议细节,例如长度字段、消息完整性和异常输入。不要假设一次读取就能获得完整消息,因为 TCP 可能产生半包或粘包。
生产环境使用编解码器时需要注意:
- Decoder 应明确输入类型,避免 Pipeline 中 Handler 顺序错误。
- Encoder 输出必须符合通信协议,不能混入业务状态判断。
- 使用 ByteBuf 时关注引用计数,避免内存泄漏。
将协议解析、数据转换和业务处理分离,可以降低网络服务维护成本,并让问题定位更加清晰。