
Go / 系统课时
固化模糊测试失败样本
固化模糊测试失败样本
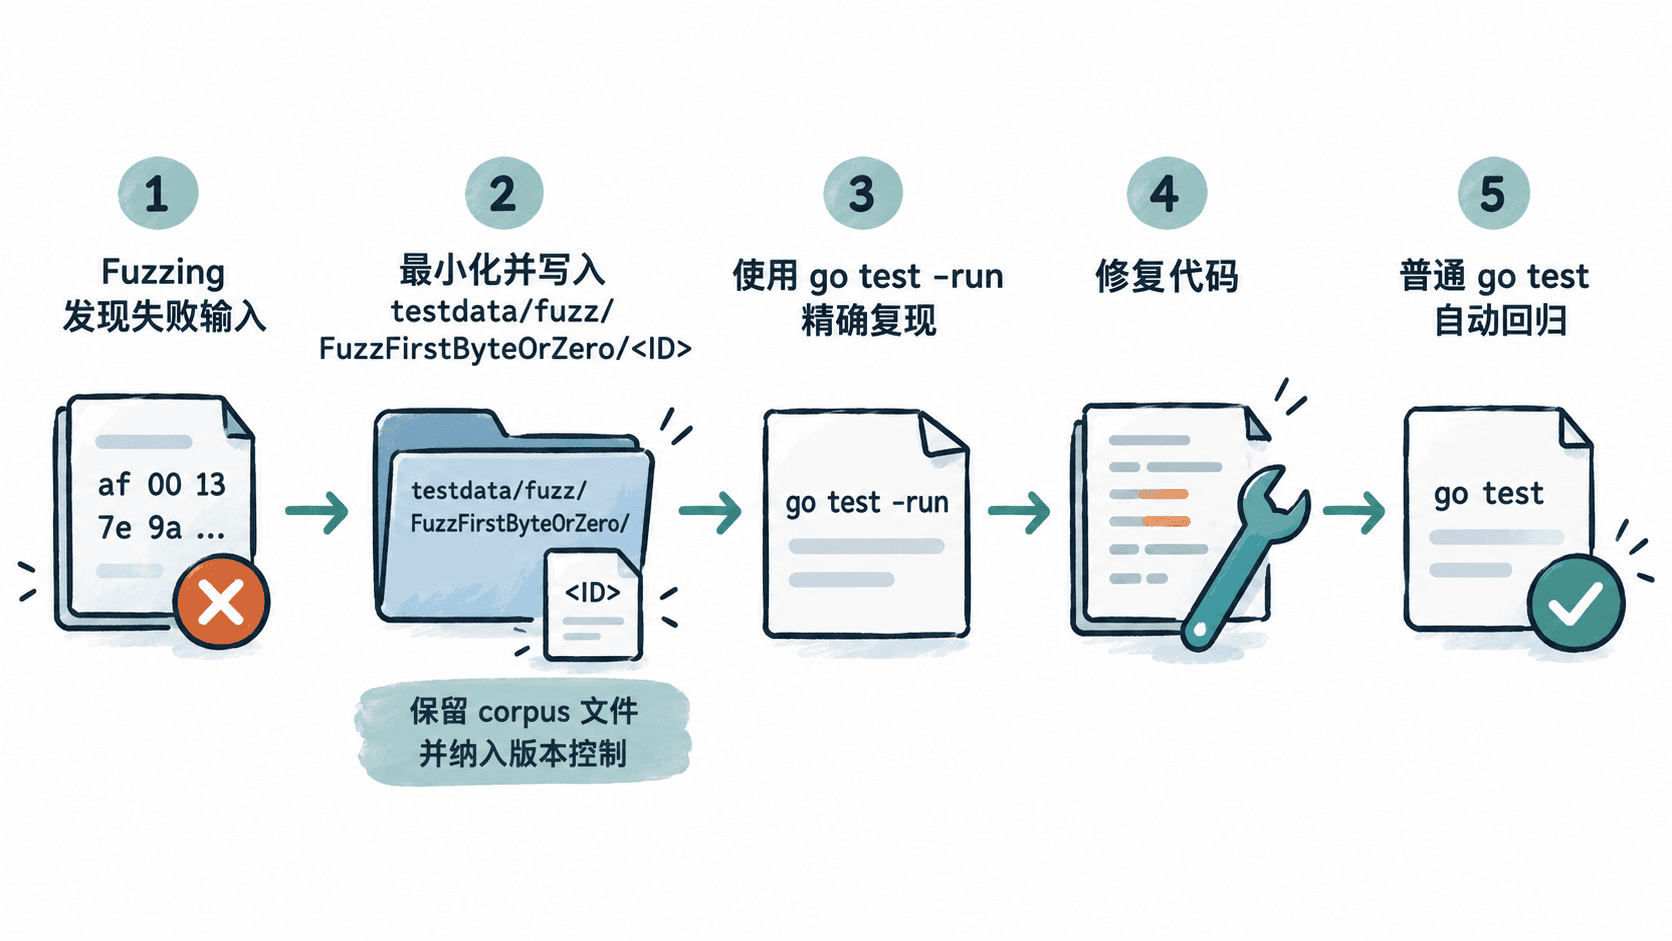
Fuzzing 找到崩溃后,真正有价值的工作是把随机发现转成可重复的回归用例。本节用一个可复现的越界缺陷演示失败样本落盘、按样本重跑、修复以及保留 corpus 文件的完整闭环。
学习目标
- 识别 Go 模糊测试生成的失败样本文件与复现命令
- 使用最小化后的 corpus 输入稳定复现同一缺陷
- 修复后让普通
go test持续执行该失败样本,防止回归
先让失败样本真正落盘
下面的目标函数对空字符串没有边界检查。种子只有 "abc",但模糊引擎在变异过程中可能生成空字符串,一旦触发越界,Go 会尝试最小化输入并把失败样本写入 testdata/fuzz/FuzzFirstByteOrZero/。
package fuzzdemo

import "testing"

func firstByteOrZero(s string) byte {
    // 缺陷:空字符串没有第 0 个字节。
    return s[0]
}

func FuzzFirstByteOrZero(f *testing.F) {
    f.Add("abc")

    f.Fuzz(func(t *testing.T, s string) {
        _ = firstByteOrZero(s)
    })
}
预期结果:代码可直接作为 fuzz_test.go 运行;当引擎生成空字符串时会出现越界 panic,并保存导致失败的最小化输入。
执行:
go test -fuzz=FuzzFirstByteOrZero -fuzztime=10s预期输出(保留关键行,堆栈与耗时省略):
--- FAIL: FuzzFirstByteOrZero (<TIME>)
    --- FAIL: FuzzFirstByteOrZero/<ID> (<TIME>)
panic: runtime error: index out of range [0] with length 0
Failing input written to testdata/fuzz/FuzzFirstByteOrZero/<ID>
FAIL
<ID> 是本次失败样本的文件名标识,<TIME> 是动态耗时。真实运行时还会包含栈信息和 fuzz 进度行。
用保存的样本精确复现
不要在看到 panic 后立即删除 testdata/fuzz。先使用失败输出中的 <ID> 重跑对应样本,这一步把“随机发现”转成稳定复现。
go test -run='FuzzFirstByteOrZero/<ID>'预期输出:
--- FAIL: FuzzFirstByteOrZero (<TIME>)
    --- FAIL: FuzzFirstByteOrZero/<ID> (<TIME>)
panic: runtime error: index out of range [0] with length 0
FAIL
把 <ID> 替换为实际生成的文件名。若这里不能稳定重现,应先检查代码、构建标签、环境变量和外部依赖是否发生变化,而不是直接修改样本。
修复缺陷并保留回归输入
根因是函数默认字符串一定非空。修复时让空字符串成为明确边界,而不是在 fuzz target 中用 t.Skip() 跳过它;因为空字符串属于函数可接收的 string 输入,跳过只会掩盖缺陷。
片段示例:在同一个 fuzz_test.go 中替换原来的 firstByteOrZero 函数,其余 fuzz target 保持不变。
func firstByteOrZero(s string) byte {
    if len(s) == 0 {
        return 0
    }
    return s[0]
}
生效行为:空字符串返回 0,其他字符串仍返回首字节。由于失败 corpus 文件仍位于 testdata/fuzz/FuzzFirstByteOrZero/,后续普通测试会把它作为种子语料再次执行。
再次运行全部测试:
go test ./...预期输出:
ok <PATH> <TIME><PATH> 和 <TIME> 会随项目路径和机器环境变化。
把失败样本当作版本化测试资产
一个值得保留的失败样本应当足够小、稳定,并且不依赖临时环境。修复提交时,应把对应 testdata/fuzz/FuzzFirstByteOrZero/<ID> 一并纳入版本控制,这样 CI 即使没有启用持续 fuzz,也会在普通测试阶段重新执行该 corpus 输入。
如果失败样本包含敏感数据、时间戳、随机外部 ID 或巨大载荷,不要原样提交。应先最小化和脱敏,再保留能触发同一缺陷的最小输入。只有在已经用等价且更可读的单元测试完整覆盖该缺陷时,才考虑用显式回归测试替代 corpus 文件;否则删除失败样本等于丢掉一次已经获得的缺陷证据。