
交互与用户体验 / 系统课时
按影响和证据强度排序机会
按影响和证据强度排序机会
当研究团队同时发现多项用户痛点时,不能只按声音大小或方案成本排开发顺序。本篇用首次结算的虚构案例,建立统一的影响、触达、证据与成本口径,算出可复核的机会排序,再区分立即实施、先验证和暂缓处理。
学习目标
- 为候选机会定义统一的用户影响、触达范围、证据强度与实施成本。
- 使用同一公式计算相对优先级,并解释分数的适用边界。
- 依据证据门槛和实施约束,将排序转为可执行决策。
固定比较对象和研究口径
假设研究范围是“首次结算、持有可用优惠券、未自动用券”的新客。某两周内有 2000 名符合条件的用户;以下人数、评分与工期均为教学假设,不代表真实调研结论。整理出三张机会卡:
- A:在结算页突出提示“有可用券”,减少寻找入口的反复操作。
- B:自动推荐最优优惠券,减少用户逐张比价的负担。
- C:在券选择处解释限制条件,避免误解后放弃支付。
每张机会卡记录问题描述、受影响用户、证据编号、预期改善的行为和初步依赖。例如 A 的证据可标作访谈 INT-04、观察 OBS-07、事件统计 EVT-02;这些编号是示例索引,不是实际研究资料。三张卡应使用同一时间窗口和目标人群作分母,且用户可能重叠,触达人数不能相加。
定义可复核的评分尺度
先约定各维度的刻度,再给候选机会打分,避免先偏爱某个方案、后修改权重。
| 维度 | 统一口径 |
|---|---|
| 用户影响 I | 1~5 分:1=几乎不影响任务,3=多一次操作,4=反复尝试或额外耗时超过 60 秒,5=导致任务无法完成;以观察结果校准 |
| 触达范围 R | 受影响人数 ÷ 同口径目标人数,取 0~1;例如 1000 ÷ 2000=0.50 |
| 证据强度 C | 0.30=少量单一来源自述;0.60=多名用户行为与事件数据相互支持;0.90=观察、行为数据及不同样本复核一致 |
| 实施成本 E | 设计、开发、测试合计人周;由对应岗位评估,必须大于 0 |
证据强度是团队约定的决策等级,不是统计学置信概率。若行为事件缺失或样本只来自高活跃用户,应降低 C,并在卡片上注明缺口。影响评分衡量的是用户问题严重程度,不是团队对功能的喜好。
计算排序并识别不确定性
使用相对比较指标 S=I × R × C ÷ E。它将影响大、覆盖广且证据较充分的机会向前排,同时反映实施资源;不应解释为收益金额或转化率预测。
| 机会 | I | R(受影响人数) | C | E(人周) | S |
|---|---|---|---|---|---|
| A 结算页用券提示 | 4 | 0.50(1000 人) | 0.90 | 2 | 0.900 |
| C 用券限制说明 | 5 | 0.25(500 人) | 0.30 | 1 | 0.375 |
| B 自动推荐优惠券 | 3 | 0.70(1400 人) | 0.60 | 4 | 0.315 |
例如 A 的计算为 4 × 0.50 × 0.90 ÷ 2=0.900。按分数得到 A、C、B,但 C 的证据较弱,不应因为开发快就直接排进实施队列;B 也可能受到优惠叠加规则和推荐能力的依赖限制。分数只解决“同口径比较”,不能取代决策门槛。
把优先级转换为行动
示例团队约定:C 低于 0.60 的机会先补证据;达到 0.60 后再检查合规、依赖和可用资源。只有通过约束检查的机会,才按 S 排实施次序。高风险变更可以要求更严格的证据门槛,门槛要在评审前公布。
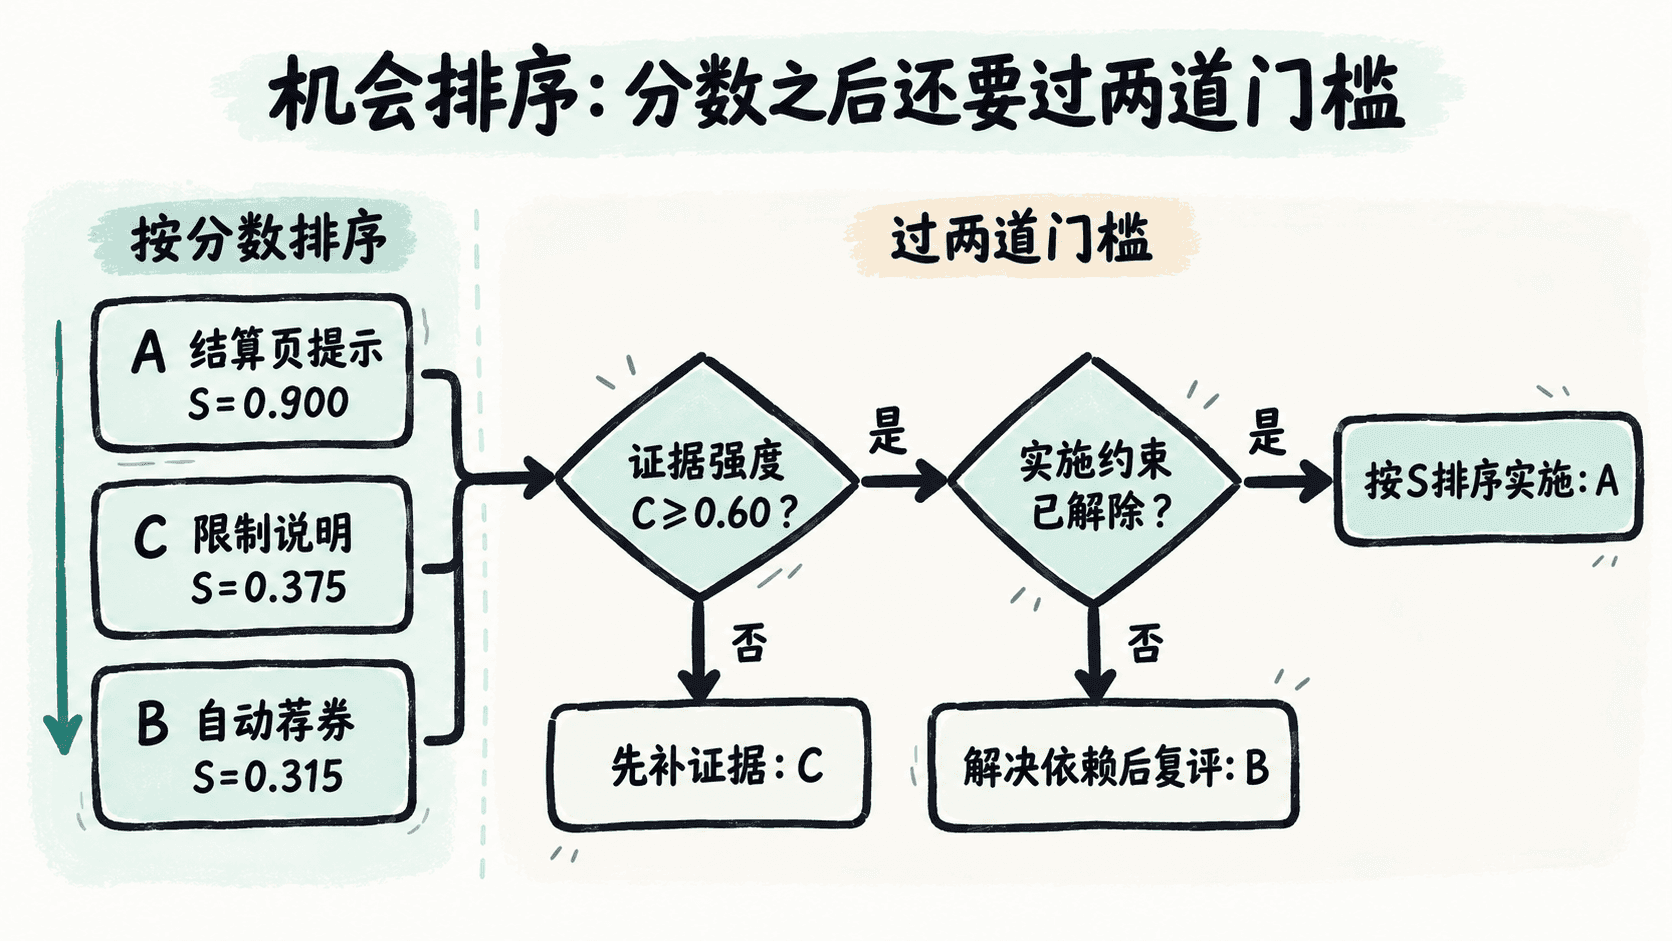
据此,A 可以进入方案设计与小范围测试:例如把“找到可用券入口”的任务成功率从示例基线 35% 提升到目标 50%,同时观察结算完成率是否下降。C 先补做 8 次针对性任务观察,并核对相应行为事件;8 人结果只用于发现机制,不能直接推断总体触达率。B 先确认优惠叠加规则、推荐逻辑和开发依赖,再更新成本估计。
用敏感性检查避免伪精确
复评时至少改动一个关键假设:若 A 从 2 人周增加到 4 人周,其 S 变为 0.450,仍高于原估计的 C 和 B;若 B 可降到 2 人周,其 S 会升为 0.630,但实施依赖未解除前仍不能直接启动。这说明估算变化会改变分数,却不会自动消除证据和约束问题。
保留一张决策记录,写明评审日期、机会编号、I/R/C/E 取值、证据索引、评估负责人、受阻项、处理动作及复评日期。新证据到来时按原口径重新计算;如果目标人群、任务或成本单位发生变化,应先统一口径再比较,而不是拿两版分数直接相减。