
交互与用户体验 / 系统课时
依据影响程度归类体验问题
依据影响程度归类体验问题
在同一次结算观察中,有人无法提交地址,有人花了很久寻找优惠码,也有人只是短暂停顿。若只按抱怨强烈程度排序,容易忽略真正阻断任务的问题。本篇用任务阻断程度、发生频率和受影响人群三个维度整理观察证据,形成有依据、可复核的体验问题分级清单。
学习目标
- 根据用户是否完成任务、绕行成本和失败后果,判断体验问题的严重程度。
- 计算观察样本中的问题发生率,并结合受影响人群范围进行初步分级。
- 将问题等级、原始证据和待验证事项整理为可交付的问题清单。
把观察记录转成独立问题
观察记录往往混合了行为、用户表达和研究者推测。正式分级前,需要先整理成可核对的问题条目,而不是直接使用“结算体验差”“用户不喜欢这个页面”等笼统描述。
以首次购买用户的结算任务为例,研究者记录到以下行为:
- 用户填写地址后点击提交,系统提示地址无效,连续尝试两次仍无法继续。
- 用户想使用活动优惠码,先后查看订单摘要、支付方式和帮助入口,85 秒后才找到输入位置。
- 用户阅读配送说明时停顿约 15 秒,随后正常完成支付。
这三条分别对应任务阻断、明显绕行和轻微理解成本,不能因为第三位用户表达了强烈不满,就认定第三个问题最严重。
每条问题至少保留以下记录:
| 记录字段 | 示例 |
|---|---|
| 问题编号 | UX-01 |
| 任务与条件 | 首次购买,填写收货地址 |
| 可观察行为 | 点击提交两次,均无法进入下一步 |
| 实际后果 | 结算任务未完成 |
| 证据位置 | OBS-03,录屏 02:14~02:48 |
| 待验证原因 | 地址校验规则或错误提示可能存在问题 |
注意区分观察事实与原因假设。看到地址提交失败,可以记录“提交后无法继续”,但不能在没有进一步验证时直接认定“后端地址校验接口存在故障”。
同一原因造成的重复表现可以合并为一个问题,但要保留不同用户的证据编号。若两个问题产生的条件或后果不同,应先分开记录,避免过早合并导致影响范围失真。
用三个维度衡量实际影响
建议分别记录严重程度 S、观察发生率 F 和触达人群比例 R。三个维度回答不同的问题,不能互相替代。
严重程度:任务是否被阻断
采用三级量表,以任务结果和实际额外成本判断,而不是以用户情绪强弱判断。
| 等级 | 判定条件 | 典型表现 |
|---|---|---|
| S3:阻断 | 核心任务无法完成,且没有有效替代路径 | 地址无法提交,结算终止 |
| S2:严重摩擦 | 任务可以完成,但需明显绕行、求助或额外耗时达到 60 秒 | 多次寻找优惠码入口 |
| S1:轻微摩擦 | 任务正常完成,仅出现短暂停顿或额外耗时不足 60 秒 | 阅读说明时短暂停顿 |
这里的 60 秒是本案例的研究判定线,不是通用行业标准。实际项目应结合任务正常耗时设定,例如一个正常只需 20 秒的操作,额外等待 40 秒也可能构成严重摩擦。
如果问题伴随数据丢失、重大隐私风险或安全风险,应单独触发风险处理流程,不应只按普通体验耗时分级。
发生频率:多少有效任务遇到问题
观察发生率按以下方式计算:
发生率 F = 遇到该问题的有效任务数 ÷ 实际进入对应步骤的有效任务数。
例如,12 次有效的优惠码使用任务中,有 7 次出现明显寻找绕行,则 F = 7 ÷ 12,约为 58.3%。
计算时必须统一统计单位。如果按任务计数,同一任务里重复点击三次也只算一次问题发生。没有进入优惠码相关步骤的任务,不应随意纳入这一问题的发生率分母。
触达人群:问题覆盖多少目标用户
触达人群比例 R 表示在本次研究定义的总体中,有多大比例属于可能遭遇该问题的场景人群。
假设产品分析数据显示,在全部首次购买用户中:
- 35% 会进入某类特殊地址填写场景。
- 70% 属于本次优惠活动覆盖的新客群体。
- 80% 会到达本次观察的配送说明区域。
这三个比例分别可作为对应问题的 R 值。它们来自假设的产品分析数据,而不是把观察样本人数直接当作总体占比。
若没有可靠数据估计 R,应标记“范围待核实”,不要默认填写 100%。
用具体观察数据完成问题分级
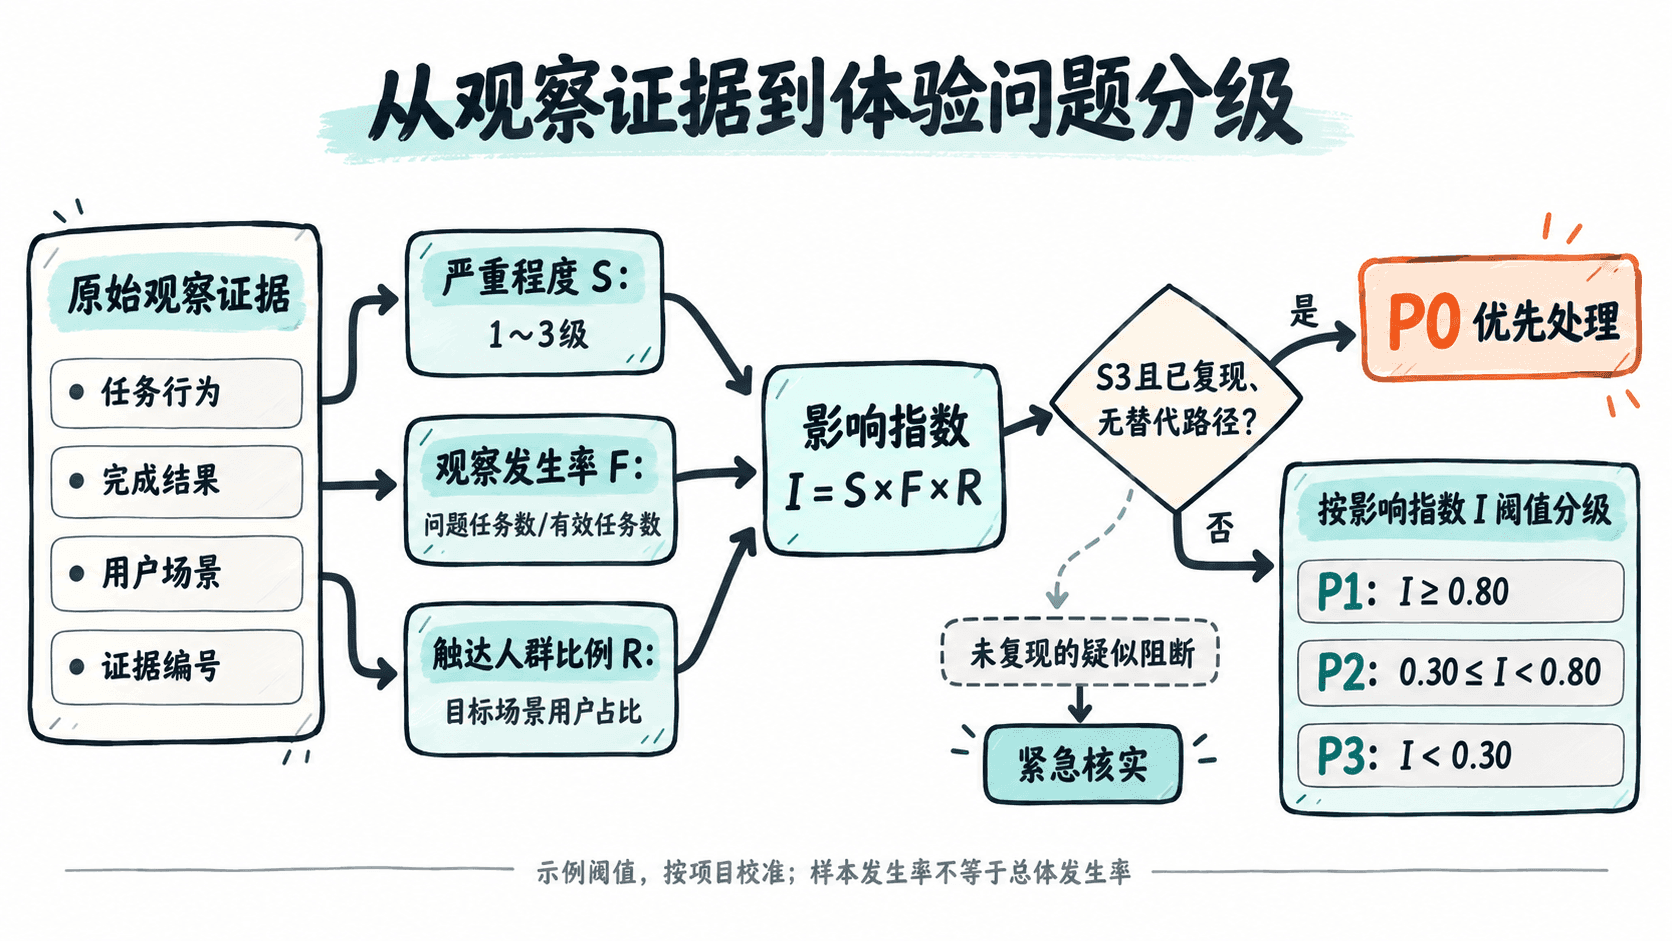
为了在同一批问题之间初步比较,可以采用一个简单的影响指数:
影响指数 I = S × F × R
其中 S 取 1~3,F 和 R 取 0~1。这个指数是团队内部的粗排工具,不代表真实商业损失,也不是经过统计验证的总体风险估计。
本案例约定以下处理规则:
- P0:S3 问题已复现,核心任务无可用替代路径,优先处理,不受指数阈值限制。
- P1:其余问题中,I 大于或等于 0.80,进入近期重点修复清单。
- P2:I 大于或等于 0.30 且小于 0.80,进入正常迭代计划。
- P3:I 小于 0.30,记录并持续观察,除非存在其他重要业务约束。
如果疑似 S3 阻断尚未复现,应立即安排核实并同步风险,而不是简单地降为 P3。
假设完成一轮首次结算观察,并从产品数据中取得对应场景的覆盖比例,可得到以下结果:
| 体验问题 | S | F | R | I | 初步等级 |
|---|---|---|---|---|---|
| 特殊地址无法提交 | 3 | 2/10 | 35% | 0.21 | P0,已复现阻断 |
| 优惠码入口难以找到 | 2 | 7/12 | 70% | 0.82 | P1 |
| 配送说明阅读费力 | 1 | 6/12 | 80% | 0.40 | P2 |
以优惠码问题为例,计算过程是 2 × (7 ÷ 12) × 0.70 ≈ 0.82,因此被分到 P1。
地址问题虽然只有 0.21,但因为已确认可以复现,且没有替代结算路径,所以按例外规则提升为 P0。这避免了低频但后果严重的问题被简单的平均分数掩盖。
需要特别注意:如果问题发生率的分母已经覆盖全部目标用户,而 R 又代表相同范围,就不应再次乘以 R,否则会重复折减影响。只有明确区分“场景内发生率”和“总体中的场景覆盖比例”,上述计算才有意义。
校准优先级并交付问题清单
初步等级产生后,还需要检查证据是否充分。尤其是只有 10~12 次观察的情况,分级应写明置信程度和待验证条件,不能把 0.82 当成精确、稳定的产品指标。
可以按照以下顺序完成复核:
- 检查样本覆盖:确认首次购买、设备类型、活动参与情况与实际目标用户一致;没有观察到的群体注明研究空白。
- 核对严重程度:回看录屏,确认任务确实失败或发生了超过判定线的绕行,而不是将用户主动探索误判为障碍。
- 检查重复计数:同一任务反复出现相同问题,只按预先约定的统计单位计数一次。
- 补充关键证据:对地址阻断,在相同输入条件和不同设备上复现;对优惠码问题,可增加 8 次来自活动新客的有效观察,比较独立完成率与查找耗时。
- 确定处理责任:为每个问题标明负责人、预计复核日期、暂定级别和升级条件。
交付清单可以沿用以下字段:问题编号、问题描述、任务场景、证据编号、严重程度、有效观察分子与分母、触达人群比例及数据来源、影响指数、初步等级、证据置信程度、处理责任人与下一步动作。
例如,UX-01 可以写为:“P0,特殊地址填写后无法继续结算;10 次有效任务中出现 2 次;已在相同地址条件下复现;由结算模块负责人优先排查。”如果尚未复现,则应明确改写为“疑似阻断,紧急待核实”。
修复后的验证也必须对应原问题:地址问题检查相同条件下能否成功提交;优惠码问题比较入口查找成功率与耗时;配送说明问题检查用户能否准确理解费用和配送条件。只有任务行为和结果发生了可观察的改善,才能确认问题已得到解决。
最终的分级清单应同时保留严重程度、发生率、触达人群和证据可信度。团队可以调整排序规则,但每一次优先级变化都应能追溯到具体观察或新增数据,而不是只依据会议中的主观判断。