
多人游戏与网络同步 / 系统课时
如何记录一次同步异常
如何记录一次同步异常
角色出现瞬移、回拉或位置持续漂移时,只看“当前坐标不对”很难还原原因。本篇把一次异常拆成可关联的序号、客户端时间、服务器 Tick、输入、预测位置、权威位置和纠正量,并用结构化日志保存,让问题能够按同一条时间线复现和比较。
学习目标
- 设计一条能关联客户端输入、服务器状态与纠正行为的同步日志
- 用序号和时间字段定位丢包、乱序、重复应用与预测偏差
- 通过最小可运行示例生成可检索、可比较的 JSON Lines 证据
先记录能回答问题的字段
同步日志的价值不在“字段越多越好”,而在异常发生后能回答三个问题:哪一次更新出了问题、当时两端分别认为角色在哪里、客户端为什么发生纠正。因此至少要保留一组稳定关联键和一组状态差异字段。
建议每条记录包含:seq 表示输入或快照序号,clientTimeMs 表示客户端本地时间线,serverTick 表示服务器模拟进度;再记录本地预测位置、服务器权威位置、触发该预测的输入,以及最终纠正向量和纠正距离。若系统还有连接重建、传送、碰撞修正等特殊路径,可再增加 reason,但不要把渲染帧率、设备信息等无关内容混进每一条高频日志。
把异常还原成一条证据链
一次回拉通常同时涉及客户端输入、本地预测、服务器权威模拟、快照返回和客户端纠正。排查时需要把这些对象放到同一条时间轴上,而不是分别看几份互不关联的日志。
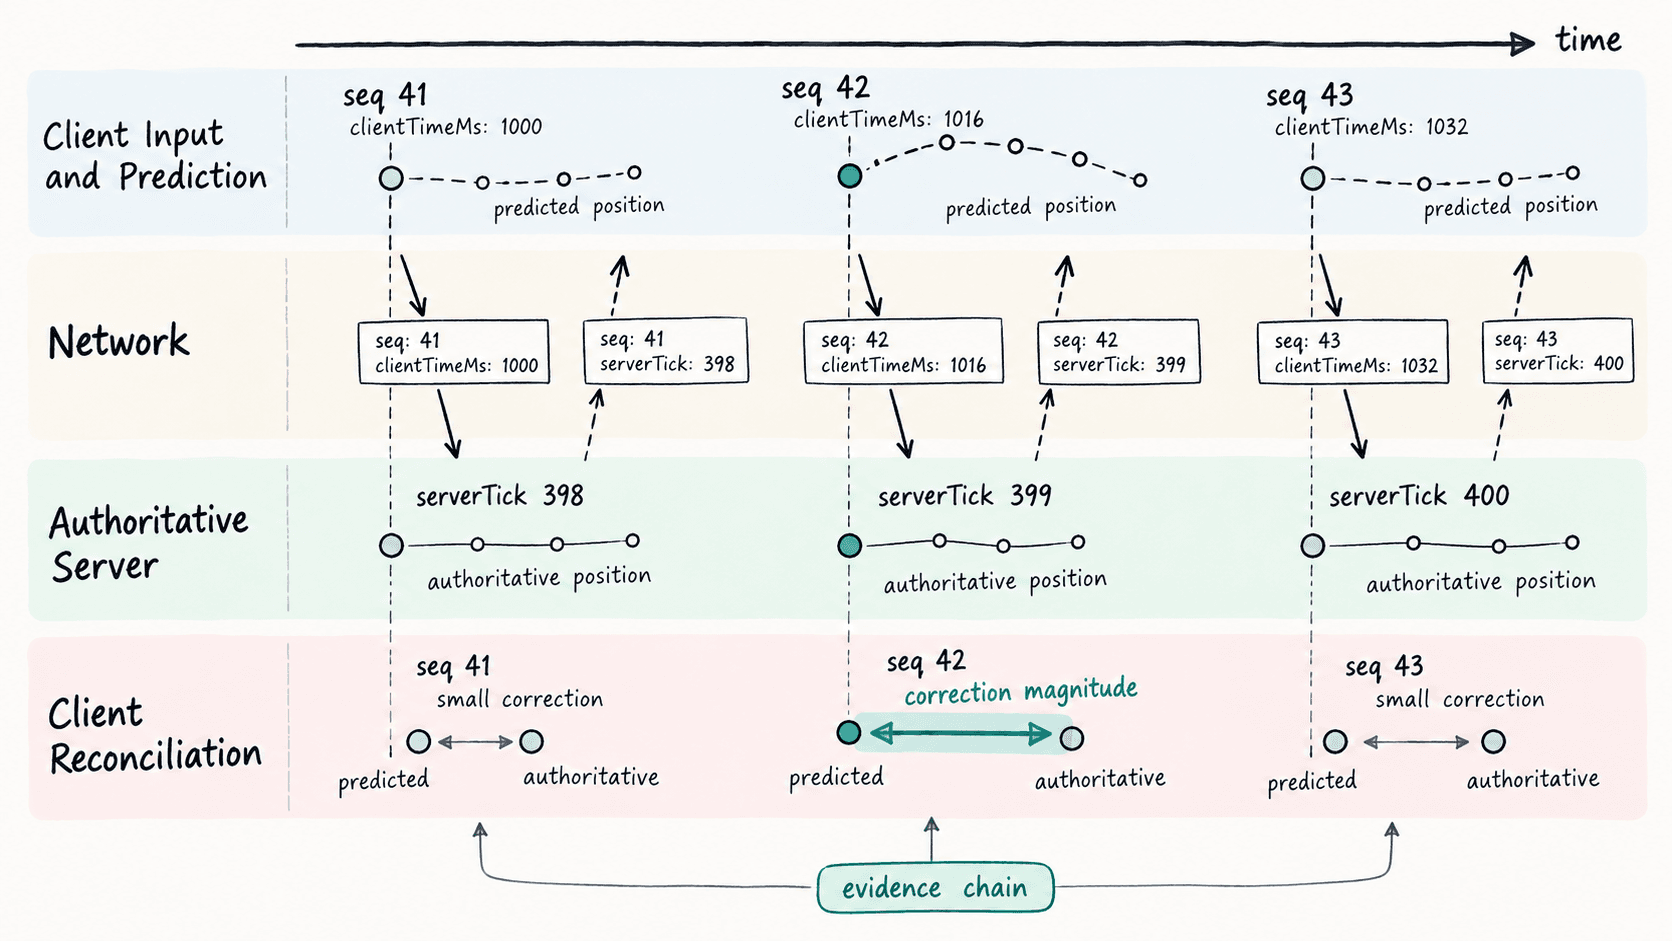
出现异常后先按 seq 排序,再检查服务器是否连续处理;随后比较同一序号对应的预测位置与权威位置。如果序号连续但误差逐步扩大,更像预测模型或碰撞规则不一致;如果序号有缺口或到达顺序反转,应优先检查网络与快照应用顺序;如果权威位置正确而客户端重复应用旧快照,则应检查去重和“只接受更新序号”的逻辑。
生成一份可比较的结构化日志
下面的 Python 示例不依赖第三方库,模拟三次同步更新,并把每次预测与权威位置之间的纠正量输出为 JSON Lines。固定输入便于你先验证字段设计,再把相同结构接入真实客户端或服务器日志系统。
import json
import math

# 固定样本让每次运行都能得到相同结果,便于比较日志字段。
events = [
    {"seq": 41, "clientTimeMs": 1200, "serverTick": 398,
     "predicted": {"x": 8.1, "z": 3.0},
     "authoritative": {"x": 8.0, "z": 3.0},
     "input": {"moveX": 1.0, "moveZ": 0.0}},
    {"seq": 42, "clientTimeMs": 1250, "serverTick": 399,
     "predicted": {"x": 8.4, "z": 3.0},
     "authoritative": {"x": 8.2, "z": 3.0},
     "input": {"moveX": 1.0, "moveZ": 0.0}},
    {"seq": 43, "clientTimeMs": 1300, "serverTick": 400,
     "predicted": {"x": 8.55, "z": 3.0},
     "authoritative": {"x": 8.5, "z": 3.0},
     "input": {"moveX": 0.0, "moveZ": 0.0}},
]

for event in events:
    # 纠正向量统一定义为“权威位置 - 预测位置”。
    dx = round(event["authoritative"]["x"] - event["predicted"]["x"], 3)
    dz = round(event["authoritative"]["z"] - event["predicted"]["z"], 3)
    # 只输出排查同步问题需要的关联键、状态和纠正结果。
    record = {
        "seq": event["seq"],
        "clientTimeMs": event["clientTimeMs"],
        "serverTick": event["serverTick"],
        "predictedPosition": event["predicted"],
        "authoritativePosition": event["authoritative"],
        "input": event["input"],
        "correction": {
            "dx": dx,
            "dz": dz,
            "magnitude": round(math.hypot(dx, dz), 3),
        },
    }
    print(json.dumps(record, ensure_ascii=False, separators=(",", ":")))
预期输出
{"seq":41,"clientTimeMs":1200,"serverTick":398,"predictedPosition":{"x":8.1,"z":3.0},"authoritativePosition":{"x":8.0,"z":3.0},"input":{"moveX":1.0,"moveZ":0.0},"correction":{"dx":-0.1,"dz":0.0,"magnitude":0.1}}
{"seq":42,"clientTimeMs":1250,"serverTick":399,"predictedPosition":{"x":8.4,"z":3.0},"authoritativePosition":{"x":8.2,"z":3.0},"input":{"moveX":1.0,"moveZ":0.0},"correction":{"dx":-0.2,"dz":0.0,"magnitude":0.2}}
{"seq":43,"clientTimeMs":1300,"serverTick":400,"predictedPosition":{"x":8.55,"z":3.0},"authoritativePosition":{"x":8.5,"z":3.0},"input":{"moveX":0.0,"moveZ":0.0},"correction":{"dx":-0.05,"dz":0.0,"magnitude":0.05}}
这三行里 seq=42 的纠正距离最大,因此它应成为下一步排查入口。真实系统中不要只在“发现异常后”才开始记录;更可靠的做法是保留一个有限大小的环形缓冲区,在纠正量越过阈值、发生传送式回拉或用户主动上报时,把异常前后若干秒的数据一次性落盘。
让日志真正可复现
日志格式稳定之后,还要控制采样和上下文。高频角色同步不适合无限打印到控制台,否则 I/O 本身会扰动帧时间;可以常驻内存缓冲,只在异常触发时导出。导出的文件中应记录构建版本、角色实体 ID、会话 ID 和测试场景标识,但这些字段可以放在文件头或批次元数据里,不必在每一行重复。
排查时用同一套顺序:先确认 seq 是否连续且只应用一次,再对齐 serverTick,然后计算预测与权威状态差异,最后才看纠正策略。这样得到的不是“角色刚才抖了一下”的描述,而是一段能够重放、比较和验证修复效果的证据。