
多人游戏与网络同步 / 系统课时
用帧号定位客户端不同步
用帧号定位客户端不同步
客户端不同步最难处理的不是“结果不一样”,而是“不知道从哪一帧开始不一样”。本课建立一条可复现的诊断链:帧号标识执行位置,输入序列说明执行依据,状态摘要负责快速比较结果,最终把问题缩小到首个发生分歧的逻辑帧。
学习目标
- 建立帧号、输入序列和状态摘要之间的对应关系
- 找到客户端首次出现确定性分歧的帧
- 使用稳定摘要减少逐字段比对的排查成本
先固定诊断坐标
排查不同步时,必须让日志中的数据能够互相对应。最基本的坐标是 frame,它表示逻辑模拟走到了哪一帧;inputSeq 表示这一帧使用的输入序号或输入集合版本;stateHash 或状态摘要则表示该帧执行完成后的关键状态结果。
三者形成一条定位链:先发现某个帧的摘要不同,再检查这一帧使用了什么输入,最后向前搜索找到第一个摘要开始不同的帧。这样可以避免从当前错误画面开始猜测,而是直接寻找“第一次分叉”。
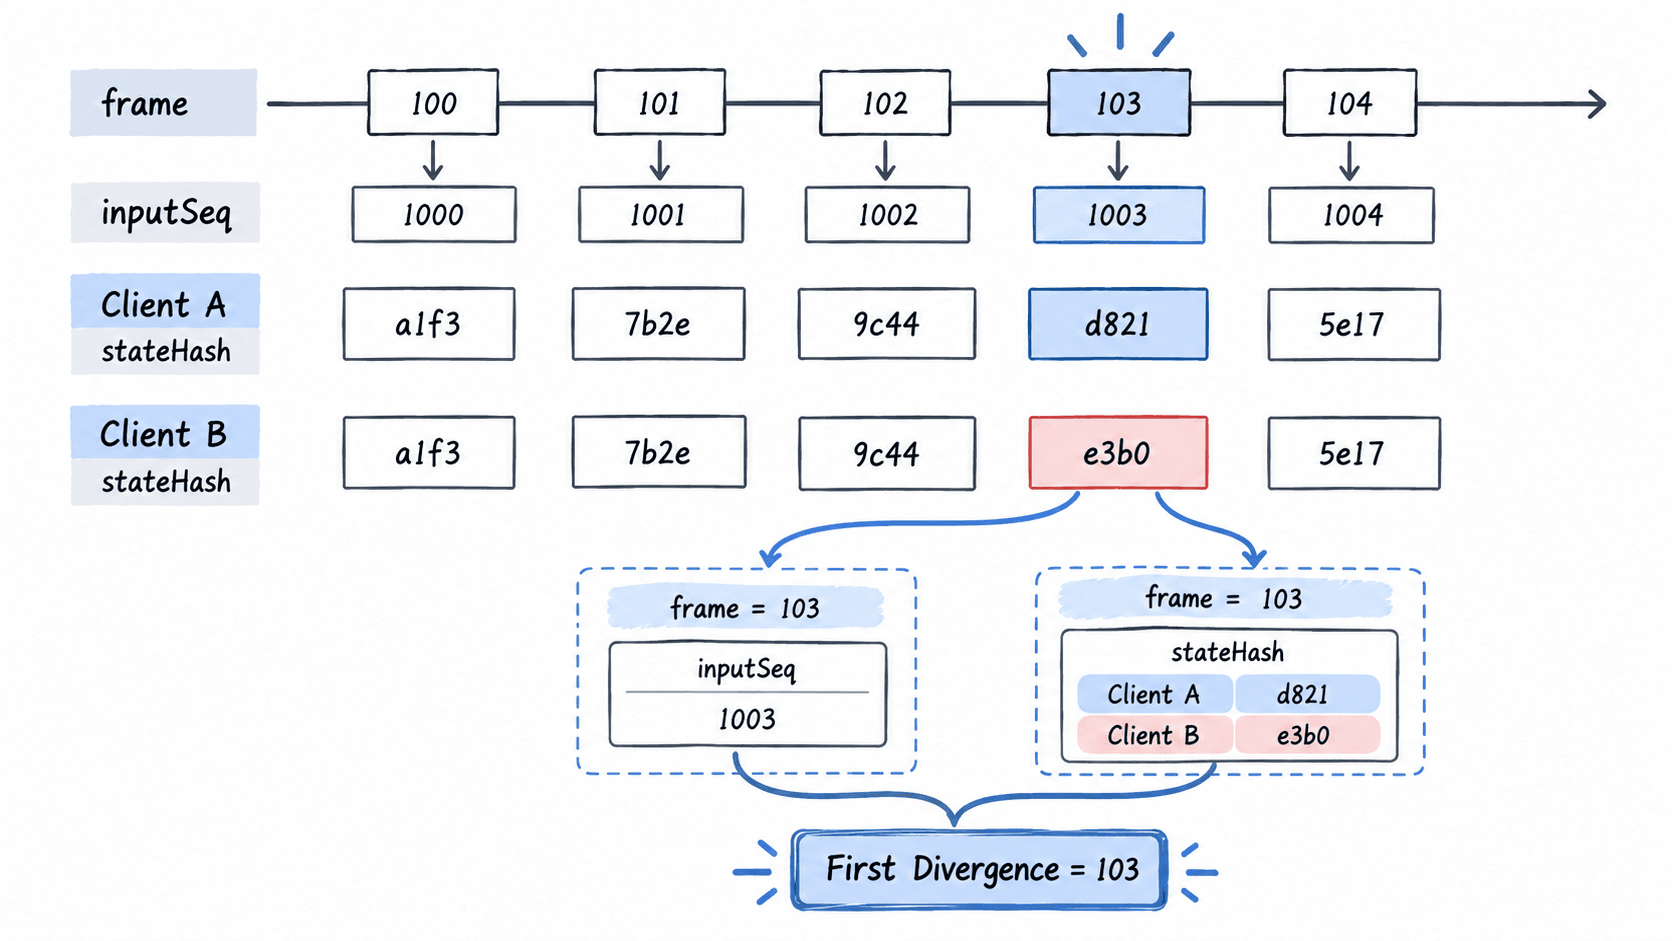
这里的状态摘要不必一开始就覆盖整个内存状态。工程上通常选择真正影响后续模拟的核心状态,例如实体位置、速度、生命值、技能状态、随机数游标或关键计时器,再按照固定顺序序列化后计算摘要。只要两个客户端使用相同输入后得到的核心状态摘要不同,就已经足以触发进一步排查。
为什么一定要找“第一个不同的帧”
假设第 103 帧已经不同,第 104、105、106 帧自然可能全部继续不同。如果从 106 帧开始比较,你会看到大量字段异常,却很难知道哪个异常是根因。确定性模拟的错误通常会扩散,所以真正有价值的是首个分歧点,而不是最后一个错误状态。
排查时可以先记录每帧摘要,再用二分思路缩小范围。若 2000 帧的最终状态不同,可以先比较中点附近摘要;找到第一次不同的大致区间后,再继续缩小。对于短回放直接顺序扫描即可,重点是把“最后不同”转化成“第一次不同”。
用稳定摘要快速比较状态
摘要函数必须满足一个重要条件:同一逻辑状态在不同客户端上必须得到相同输入字节。不要直接依赖语言运行时对字典或对象的默认序列化顺序,也不要把平台相关浮点格式、内存地址或随机对象标识放进摘要。
下面的 Python 示例把一个最小战斗状态按固定字段排序后编码,再计算 SHA-256 摘要。两个客户端在 frame=103 使用不同的 hp 后,日志会明确指出首个分歧帧。
import hashlib


def state_hash(state: dict) -> str:
    # 固定字段顺序,避免不同运行环境产生不同字节序列。
    payload = (
        f"x={state['x']:.3f};"
        f"y={state['y']:.3f};"
        f"hp={state['hp']};"
        f"skill={state['skill']}"
    ).encode("utf-8")
    return hashlib.sha256(payload).hexdigest()[:8]

states_a = {
    101: {"x": 10.0, "y": 4.0, "hp": 100, "skill": "idle"},
    102: {"x": 11.0, "y": 4.0, "hp": 100, "skill": "idle"},
    103: {"x": 12.0, "y": 4.0, "hp": 90, "skill": "hit"},
}
states_b = {
    101: {"x": 10.0, "y": 4.0, "hp": 100, "skill": "idle"},
    102: {"x": 11.0, "y": 4.0, "hp": 100, "skill": "idle"},
    103: {"x": 12.0, "y": 4.0, "hp": 100, "skill": "hit"},
}

for frame in sorted(states_a):
    hash_a = state_hash(states_a[frame])
    hash_b = state_hash(states_b[frame])
    status = "MATCH" if hash_a == hash_b else "DIVERGED"
    print(f"frame={frame} A={hash_a} B={hash_b} {status}")
预期输出
frame=101 A=2f4b6a31 B=2f4b6a31 MATCH
frame=102 A=9fbd8b7a B=9fbd8b7a MATCH
frame=103 A=0afc2f49 B=7e2d6d64 DIVERGED
摘要值由具体实现计算,实际运行时可能与示例中的哈希字符串不同;诊断重点是相同帧得到相同摘要、分歧帧得到不同摘要,以及日志明确标出 DIVERGED。
从分歧帧继续向前追查
找到 frame=103 后,不要立即检查所有系统。先比较这一帧的输入集合:是否使用了同一个 inputSeq,输入内容是否完全一致,输入是否按同样顺序应用。若输入已经不同,优先检查网络记录、输入打包和重放;若输入完全一致,再继续比较随机数推进、浮点计算、碰撞结果、实体遍历顺序和状态更新顺序。
为了让问题可以重复复现,建议每条诊断记录至少包含 frame、inputSeq、stateHash 和必要的关键事件标识。这样一次线上或测试环境中的不同步就能转化成一个明确的问题区间:先找首个分歧帧,再比较该帧输入,最后锁定产生不同结果的模拟步骤。