
多人游戏与网络同步 / 系统课时
状态漂移怎么快速定位
状态漂移怎么快速定位
状态漂移最难查的不是发现“两个客户端不一样”,而是确定差异第一次出现在哪里。这一课建立客户端状态、服务器状态、网络消息三点对照法,用同一个序列号、tick 和状态摘要把问题缩小到发送、传输、应用或模拟阶段。
学习目标
- 能用客户端、服务器、网络消息三点定位漂移起点
- 能区分消息已经错了,还是消息没错但应用后状态错了
- 能用状态摘要和序列号建立可复现的最小诊断日志
先找第一次分叉
不要从最终画面倒推原因。先按时间顺序寻找第一个不一致的 tick 或序列号。如果服务器发送的状态已经错误,问题在服务器模拟;如果服务器正确而网络消息内容错误,检查编码、传输和重组;如果消息正确但客户端应用后错误,则继续检查状态覆盖、插值、预测或本地模拟。
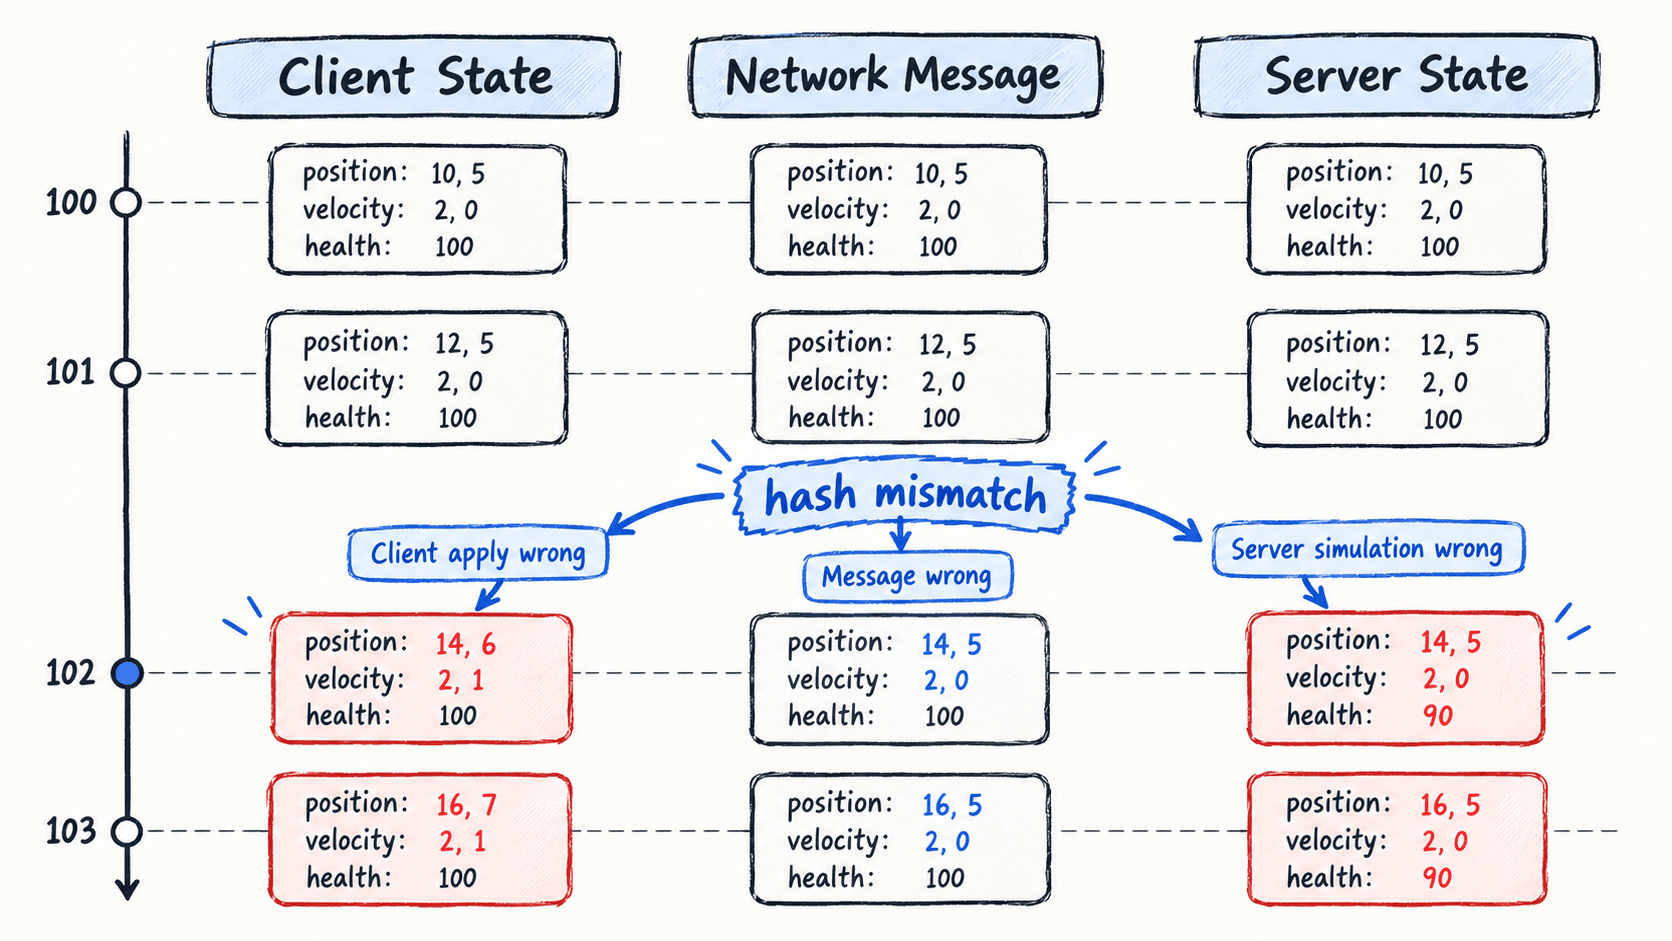
用同一份证据记录三端
排障日志至少应能把一次状态更新关联起来。常用字段包括 tick、seq、entityId、关键状态摘要和消息类型。状态摘要不必包含全部对象,可以先选受影响实体的关键字段,再计算稳定哈希;这样既方便比较,也避免日志膨胀。
下面是一个可直接运行的最小诊断程序。它分别模拟服务器状态、网络消息和客户端应用后的状态,并在第一次发现差异时立即停止检查。
import hashlib
import json


def state_hash(state: dict) -> str:
    payload = json.dumps(state, sort_keys=True, separators=(",", ":"))
    return hashlib.sha256(payload.encode("utf-8")).hexdigest()[:8]


def diagnose(records: list[dict]) -> None:
    for record in records:
        server = record["server"]
        message = record["message"]
        client = record["client"]

        server_hash = state_hash(server)
        message_hash = state_hash(message)
        client_hash = state_hash(client)

        print(
            f"tick={record['tick']} seq={record['seq']} "
            f"server={server_hash} message={message_hash} client={client_hash}"
        )

        if server != message:
            print("drift starts before client apply: inspect serialization/transport")
            return
        if message != client:
            print("drift starts during client apply: inspect prediction/merge logic")
            return

    print("no drift found in inspected range")


if __name__ == "__main__":
    diagnose([
        {
            "tick": 101,
            "seq": 501,
            "server": {"position": 10, "health": 100},
            "message": {"position": 10, "health": 100},
            "client": {"position": 10, "health": 100},
        },
        {
            "tick": 102,
            "seq": 502,
            "server": {"position": 12, "health": 100},
            "message": {"position": 12, "health": 100},
            "client": {"position": 13, "health": 100},
        },
    ])
预期输出
tick=101 seq=501 server=1f6f8b1d message=1f6f8b1d client=1f6f8b1d
tick=102 seq=502 server=0d9c0b8a message=0d9c0b8a client=2e2f8f5c
drift starts during client apply: inspect prediction/merge logic
示例中的哈希值只是由当前字段和 JSON 排序规则计算出来的摘要,实际运行值可能不同。真正需要关注的是同一 tick 的三份状态是否一致,以及第一次出现不一致的边界。
按第一次分叉选择排查方向
当三点对照建立后,可以按顺序缩小范围。如果 server != message,优先检查序列化、量化、字段裁剪、压缩解码以及消息重组;如果 message == server 但 client != message,重点检查客户端是否错误覆盖本地状态、错误处理旧包,或者把预测结果合并到了错误版本上。
还有一种常见情况是三点在某个 tick 都一致,但随后客户端又漂移。这时不要回到网络层反复抓包,而应继续检查下一跳:例如渲染前插值、客户端独立模拟、浮点差异或本地随机源。定位的目标不是证明“网络正常”,而是找到状态第一次分叉的那一步。
让问题可以重复出现
固定 tick、seq 和 entityId 后,再保存触发漂移前后的少量输入与消息,通常就能把一次偶发问题变成可复现案例。对于高频排障,建议把“状态摘要、消息摘要、首次分叉 tick、对应输入序列”作为固定诊断字段,而不是只依赖截图或最终血量。
当你能回答“服务器在什么 tick 得到什么状态、发出了什么消息、客户端在什么 tick 应用了什么结果”,状态漂移就不再是模糊的同步问题,而会变成一条可以继续验证的具体执行链。