
游戏客户端架构 / 系统课时
声音延迟怎样定位来源
声音延迟怎样定位来源
声音“慢半拍”不能只靠体感判断,因为资源加载、解码、调度、音频缓冲和外部设备都可能贡献延迟。本节把一次播放拆成可测时间点,用同一套数据判断延迟究竟积累在哪一段。
学习目标
- 把总延迟拆成输入、资源、解码、调度和输出等可测阶段
- 通过统一时间戳建立可重复的延迟测量方法
- 根据延迟落点判断应优化资源、调度还是设备输出
先把总延迟拆成阶段
从玩家操作到真正听见声音,通常要经过游戏输入、资源准备、解码、播放调度、音频线程处理以及设备输出。若只记录“按键时间”和“听见时间”,只能得到总延迟,无法判断应该优化哪一层。
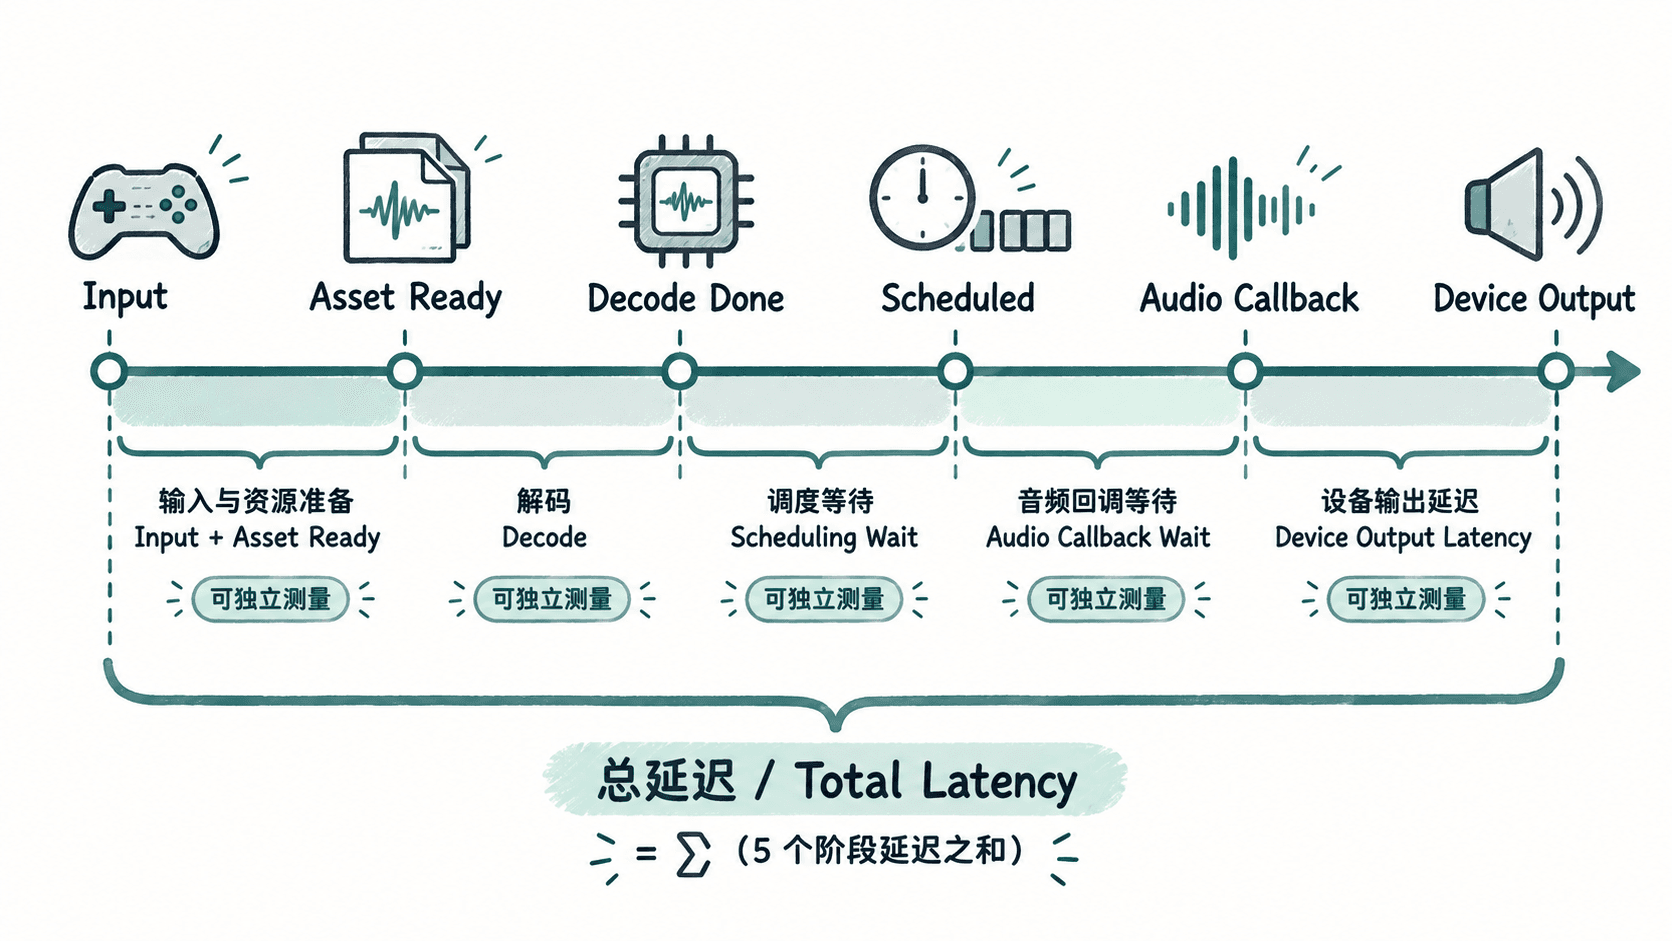
可以把关键时间点定义为:
t0:输入事件进入游戏逻辑t1:目标音频资源已经可用t2:首批可播放音频数据解码完成t3:播放请求提交给音频调度系统t4:音频回调真正开始消费该声音t5:设备侧实际产生声音
其中 t0 到 t4 通常可以通过程序埋点获得。t5 若需要精确测量,往往要使用回环录音、外部麦克风或平台提供的低层测量能力,不能简单用主观听感代替。
统一时钟再测每一段
所有程序内时间戳应来自同一个单调时钟。若混用系统墙上时钟、不同线程中的不同计时源,系统校时或时钟精度差异就可能污染结果。
下面的 Python 示例根据一组纳秒时间戳计算程序内各阶段延迟,可用于理解埋点数据应该怎样拆分。
from dataclasses import dataclass

@dataclass
class AudioTimeline:
    input_ns: int
    asset_ready_ns: int
    decode_done_ns: int
    scheduled_ns: int
    callback_ns: int

def to_ms(delta_ns: int) -> float:
    return delta_ns / 1_000_000

timeline = AudioTimeline(
    input_ns=1_000_000_000,
    asset_ready_ns=1_018_000_000,
    decode_done_ns=1_026_000_000,
    scheduled_ns=1_029_000_000,
    callback_ns=1_041_000_000,
)

print(f"load={to_ms(timeline.asset_ready_ns - timeline.input_ns):.1f} ms")
print(f"decode={to_ms(timeline.decode_done_ns - timeline.asset_ready_ns):.1f} ms")
print(f"schedule={to_ms(timeline.scheduled_ns - timeline.decode_done_ns):.1f} ms")
print(f"callback_wait={to_ms(timeline.callback_ns - timeline.scheduled_ns):.1f} ms")
print(f"known_total={to_ms(timeline.callback_ns - timeline.input_ns):.1f} ms")
预期输出:
load=18.0 ms
decode=8.0 ms
schedule=3.0 ms
callback_wait=12.0 ms
known_total=41.0 ms
这里的 known_total 只计算到音频回调开始,不包含之后的系统缓冲、无线传输和扬声器输出。如果程序内数据已经很低,但玩家仍明显感觉声音滞后,就应把注意力转向输出链路。
用重复测量区分抖动和固定延迟
单次数据不能代表真实表现。应在相同条件下重复触发多次,同时观察典型值和高延迟样本。如果大多数播放都在较低范围,偶尔突然升高,问题更像资源加载抖动、线程抢占、垃圾回收或后台任务干扰。
如果每次延迟都比较稳定,却始终明显偏高,则更像固定缓冲、调度策略、系统音效处理或无线输出链路造成的基线延迟。两类问题的优化方向完全不同,因此不要只记录平均值。
测试条件也必须固定,包括同一音频资源、同一设备、同一输出方式和相同冷启动状态。否则所谓“优化前后”可能实际上走的是两套不同路径。
按延迟落点选择修复方向
如果 t0 到 t1 明显最大,说明播放请求到来时资源尚未准备好。高频短音效可考虑提前加载,并检查是否存在频繁释放后又重新加载的情况。
如果 t1 到 t2 最大,应关注音频编码格式、首次解码成本和解码线程是否拥塞。不要为了降低少量延迟就把所有资源无条件改成无压缩格式,应只针对延迟敏感且体积可控的声音取舍。
如果 t3 到 t4 最大,说明资源已经准备完成,重点应转向调度粒度、音频缓冲和音频线程负载。此时继续优化文件读取通常不会解决主要问题。
如果程序内各段都正常,但外部测得的 t5 仍很晚,应检查蓝牙耳机、虚拟声卡、系统增强效果和平台输出模式。更换为设备扬声器或有线输出进行对照,通常能迅速判断延迟是否来自系统外部链路。
用单变量对照确认根因
确认根因时一次只改变一个因素。例如同一设备分别测试扬声器和蓝牙耳机,同一资源分别测试冷加载和预加载,同一场景比较音频线程正常与高负载状态。只有一个改变能够稳定移动对应时间段,才算形成了有效证据。
最终应保留时间点定义、设备与输出方式、资源状态以及多次测量结果。下一次再遇到“声音慢半拍”时,就能直接比较同一套指标,而不是依赖不同测试者的主观感受。