
编码与格式 / 系统课时
视频里有哪些冗余
视频里有哪些冗余
如果把 30 FPS 视频的每一帧都当作独立高清图片保存,体积会非常大。视频编码之所以能压得更小,是因为它同时利用单帧内部、连续帧之间以及人眼感知上的冗余。本课先建立这三类冗余的整体模型。
学习目标
- 能区分空间冗余、时间冗余与感知冗余
- 能解释视频为何比逐帧图片序列更容易压缩
- 能理解预测与量化分别利用了哪类冗余
空间冗余来自相邻像素
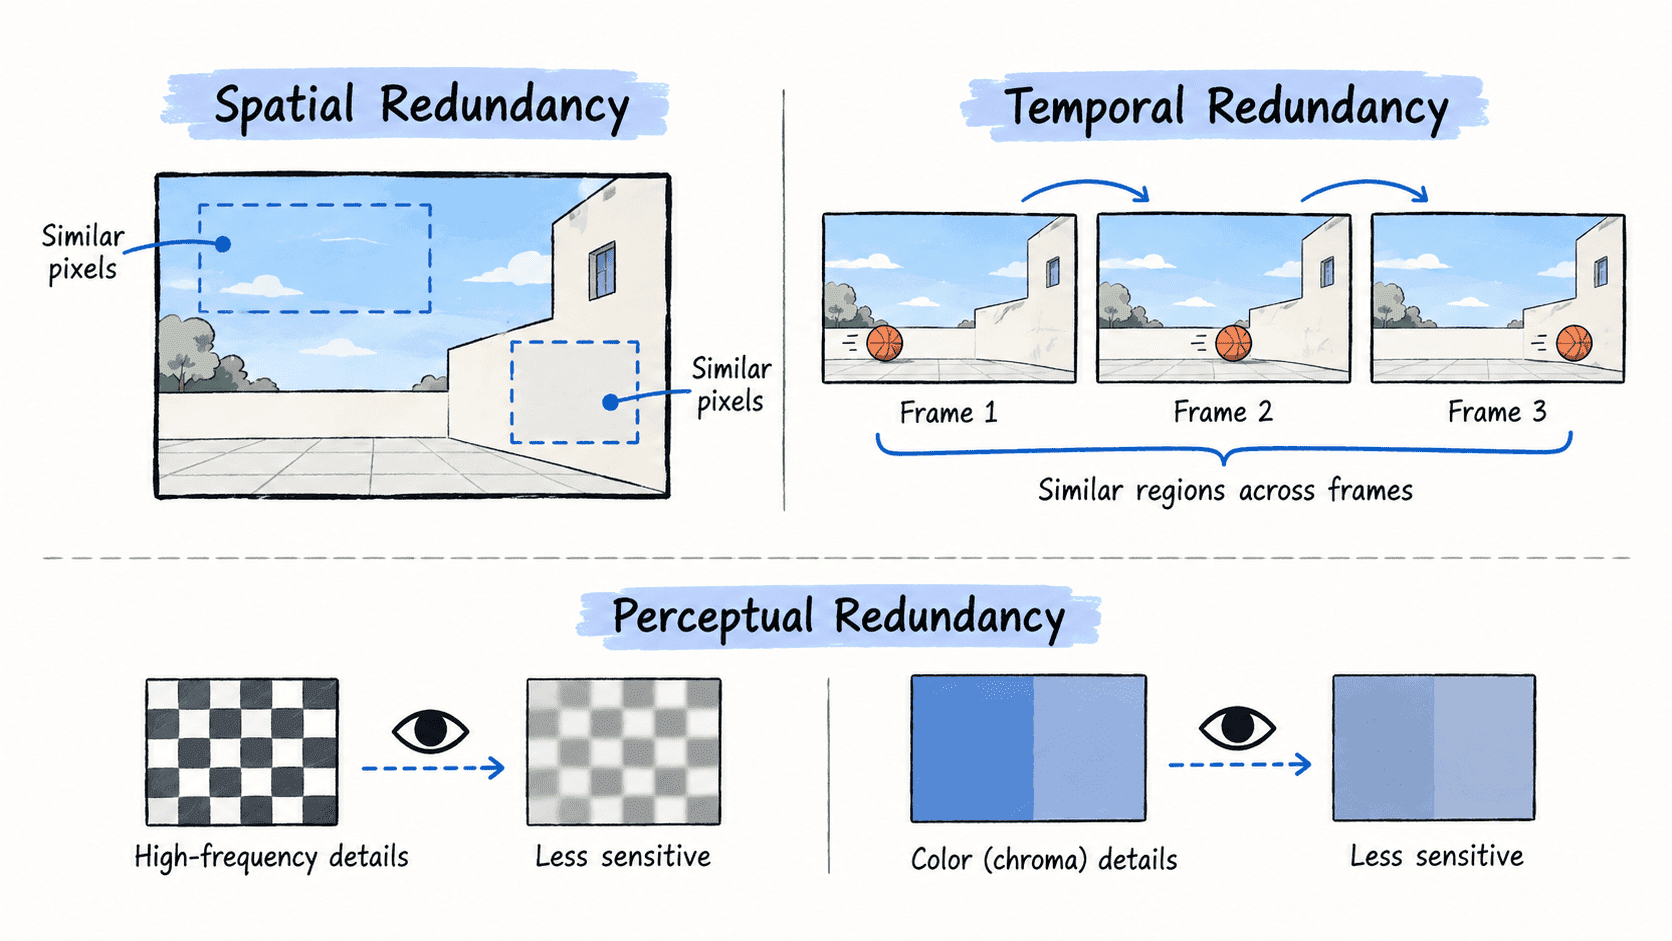
一张自然画面里,相邻区域往往颜色和亮度相近,例如天空、墙面、皮肤和渐变背景。编码器不必把每个像素完全独立描述,而可以根据邻近区域预测当前块,只编码“预测错了多少”。
这类同一帧内部的相关性叫空间冗余,也是帧内预测、变换编码能够发挥作用的基础。
时间冗余来自连续帧
连续视频中,大量背景并不会每帧完全变化。人物从左向右移动时,很多像素只是换了位置。编码器可以在参考帧里寻找相似块,用运动向量描述位移,再编码少量残差。
感知冗余允许有损压缩
人眼对不同频率、亮度和色度细节的敏感度并不相同。JPEG、H.264、HEVC、AV1 等有损编码会把更难察觉的信息压得更狠,把有限码率留给更重要的结构。
量化就是这种取舍最关键的步骤之一:它会降低变换系数的精度,因此产生真正不可逆的信息损失。
三类冗余如何串起来
现代编码器通常先做预测,减少空间或时间上的重复;再对残差做变换,让能量集中;随后量化舍弃部分细节;最后用熵编码无损地压缩符号表示。
按自己的节奏,确认真正理解。