
C / C++ / 系统课时
用 break 和 continue 控制循环
用 break 和 continue 控制循环
循环并不总要从头执行到尾:找到目标后可以立即结束,遇到不需要处理的数据也可以跳过当前一轮。break 与 continue 都会改变正常循环流程,但作用范围和后续执行位置完全不同。本节用一个可运行示例把这两个关键字的行为放在同一个程序里验证。
学习目标
- 理解
break如何立即结束当前循环 - 理解
continue如何跳过当前迭代并进入下一轮 - 能根据“提前结束”与“忽略当前数据”选择正确关键字
两个关键字改变的是不同位置
在 for、while 或 do...while 循环中,break 会直接终止它所在的最内层循环,程序随后从循环之后继续执行。它适合“目标已经找到,没有必要再遍历”的场景。
continue 不会结束整个循环,而是放弃当前这一轮尚未执行的循环体内容,然后进入下一次迭代。它适合过滤无效数据、跳过特殊值,但仍要继续处理后续元素。
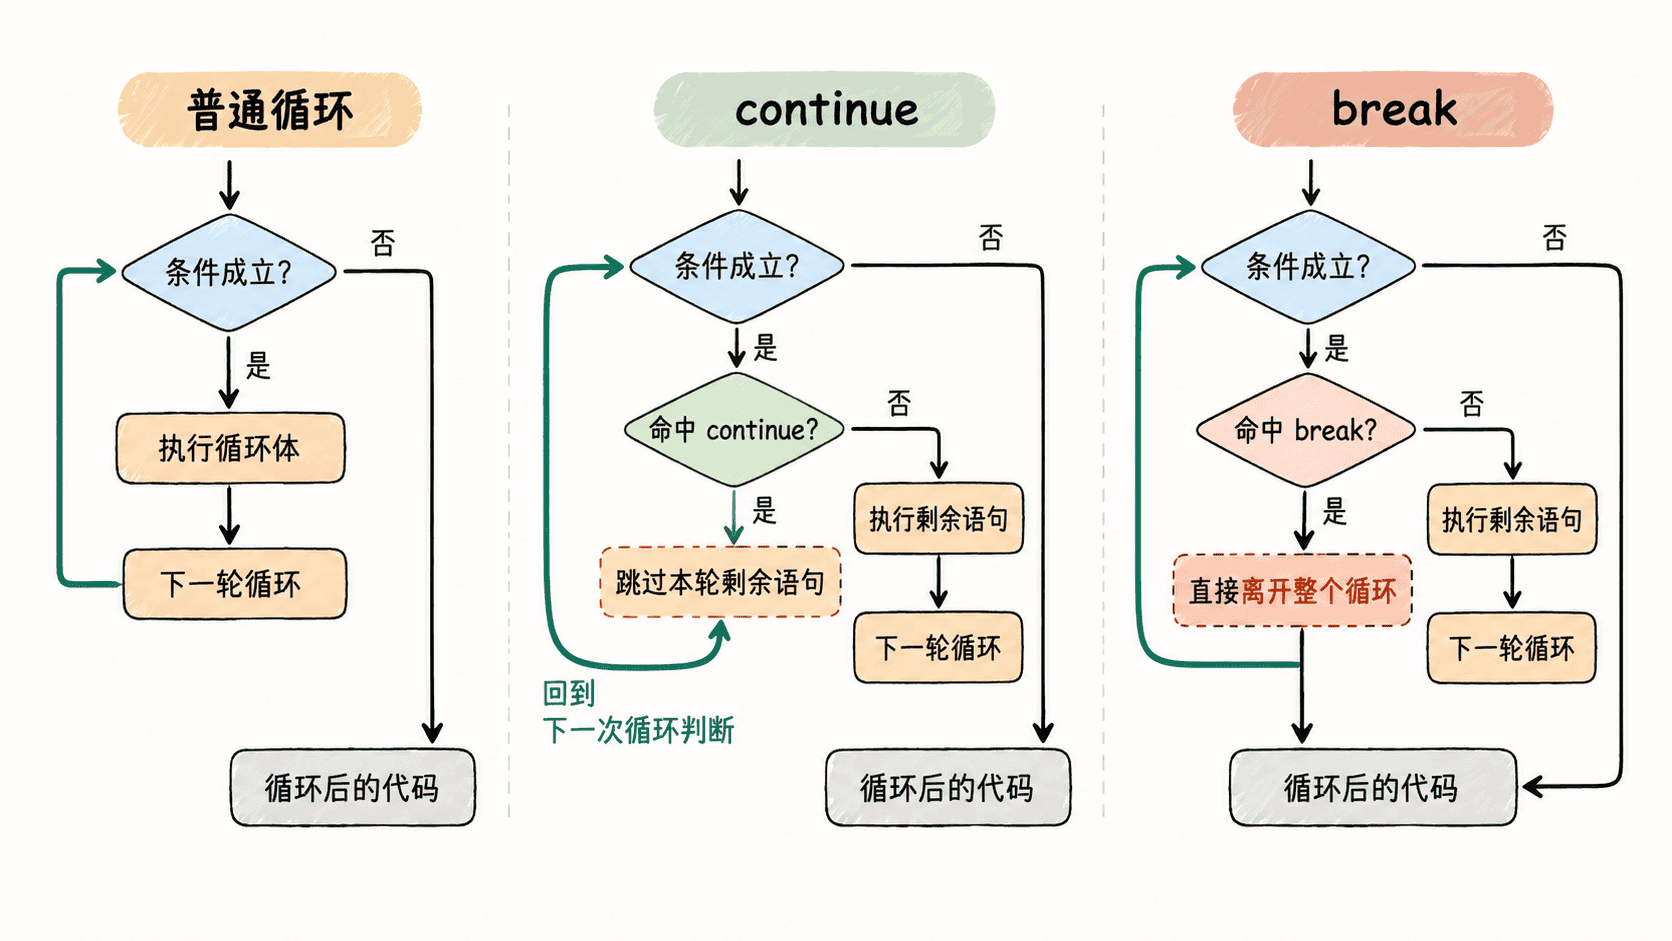
用一个程序观察执行差异
下面的程序遍历 1 到 10。遇到偶数时使用 continue 跳过输出;遇到 7 时使用 break 结束循环,因此 7 之后的数字不会再被检查。
#include <stdio.h>

int main(void) {
    for (int i = 1; i <= 10; i++) {
        if (i == 7) {
            // 已经到达停止条件,直接结束整个循环。
            break;
        }

        if (i % 2 == 0) {
            // 偶数只跳过当前这一轮,后面的数字仍会继续检查。
            continue;
        }

        printf("%d\n", i);
    }

    printf("loop finished\n");
    return 0;
}
预期输出
1
3
5
loop finished可以从结果看到,2、4、6 因为 continue 没有打印,但循环仍继续;当 i 变成 7 后执行 break,所以 8、9、10 根本不会进入后续处理。
注意 continue 在不同循环中的落点
在 for 循环中执行 continue 后,会先执行更新表达式,例如 i++,然后再判断循环条件。对于 while 循环,continue 会直接回到条件判断位置。
这也是 while 中常见的陷阱:如果控制循环推进的变量更新写在 continue 之后,某个分支可能不断跳过更新,从而形成死循环。因此使用 continue 时,要确认下一轮循环所依赖的状态一定能够推进。
break 只结束最内层循环
如果存在嵌套循环,break 只结束它直接所在的那一层,不会自动跳出所有外层循环。需要同时结束多层循环时,通常应通过额外状态变量、调整循环条件,或把搜索逻辑拆进函数后用 return 结束函数,而不是误以为一个 break 能穿透多层结构。
判断时可以抓住一个简单原则:后续数据已经没有处理价值就用 break;只有当前数据不处理、后续数据仍需要继续就用 continue。