线上告警太多没人看怎么治理
线上告警持续堆积、重复通知和低价值触发会让值班人员逐渐忽略真正的故障信号。内容从分级、去重、抑制、路由和效果评估入手,建立可持续维护的告警规则体系,并能定位噪声来源。
技术文章 · 技术实践
TOPIC / 技术方向
一个方向,串起完整学习路径。
线上告警持续堆积、重复通知和低价值触发会让值班人员逐渐忽略真正的故障信号。内容从分级、去重、抑制、路由和效果评估入手,建立可持续维护的告警规则体系,并能定位噪声来源。
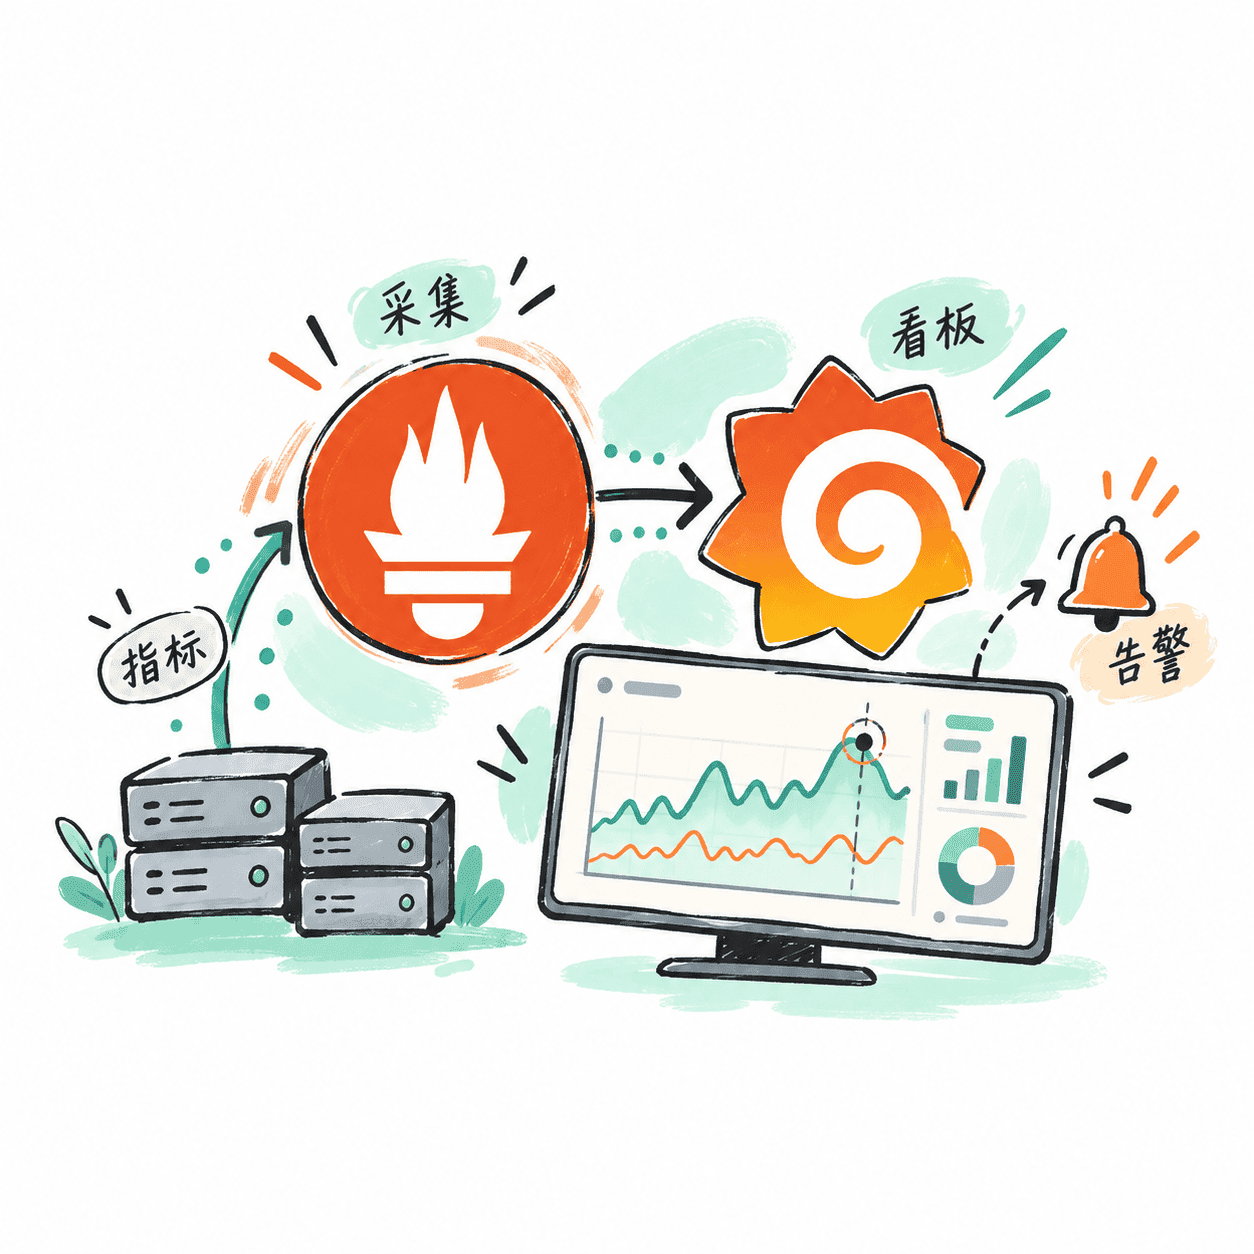
服务器和应用上线后,仅靠人工登录检查很难及时发现 CPU、内存、磁盘、接口延迟和服务异常。课程围绕 Prometheus 指标模型、Exporter、PromQL、Grafana 仪表盘和 Alertmanager 展开,从单机监控逐步进入应用指标、告警规则和故障分析,学完可以搭建一套常见 Linux 服务监控体系。
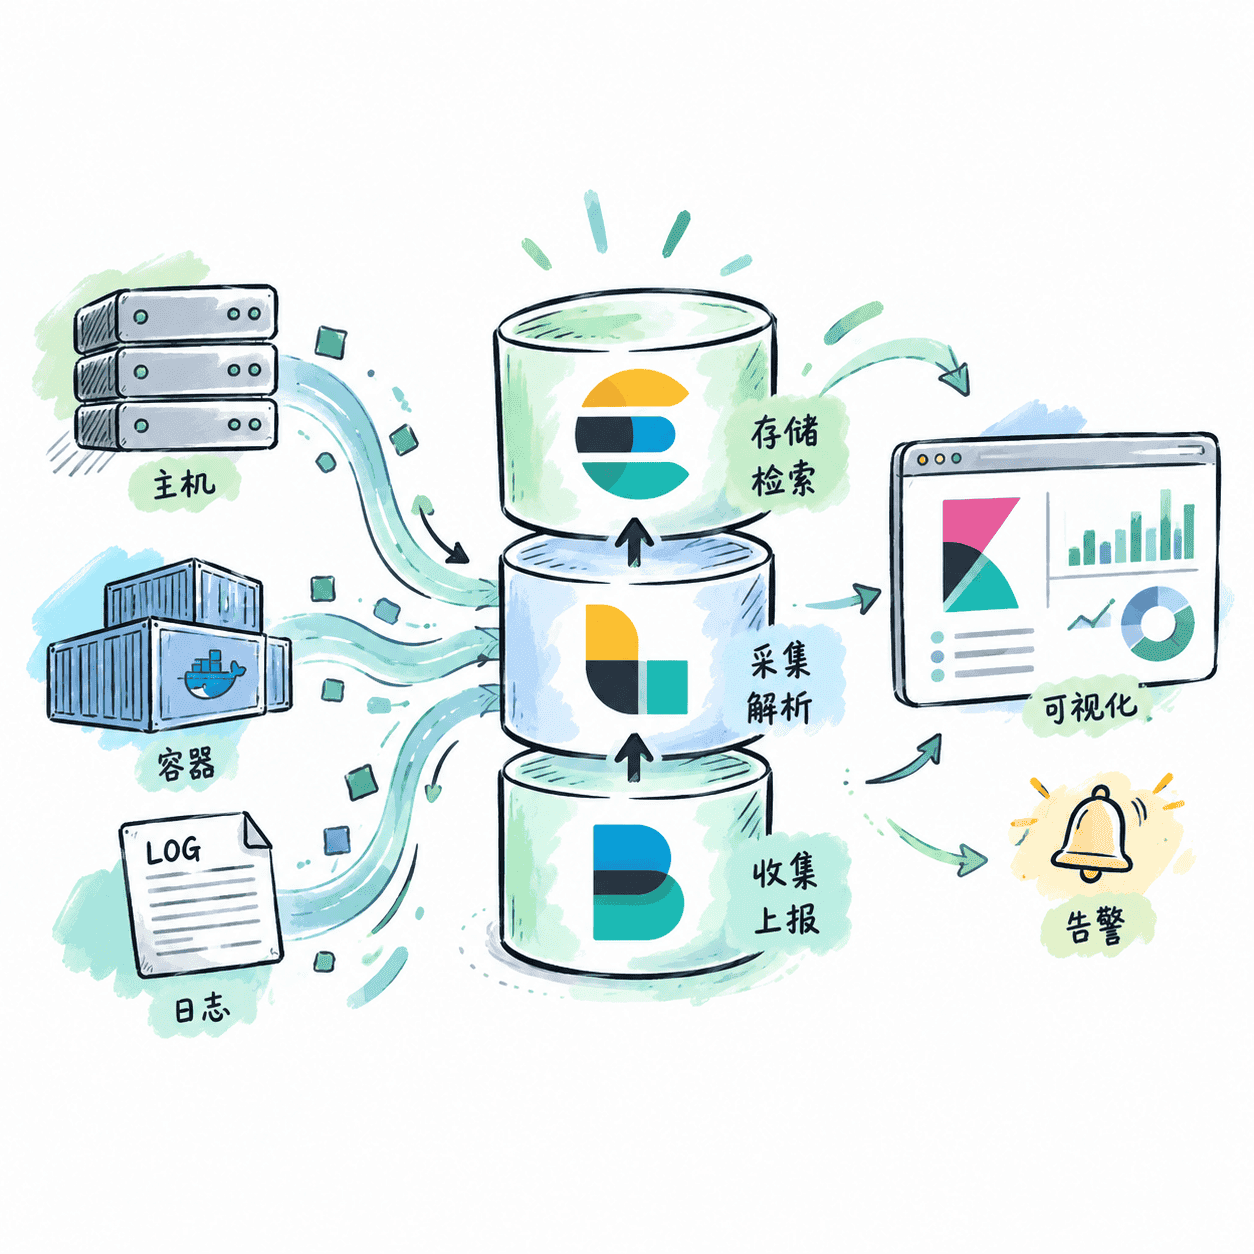
线上日志分散在多台主机和容器后,常出现查找慢、字段混乱、磁盘失控和故障难定位的问题。课程围绕 Elasticsearch、Logstash、Kibana 与 Beats 构建日志平台,覆盖部署、采集解析、索引与生命周期、检索可视化、告警、安全、性能调优和故障恢复,使学习者能够独立维护并排查生产级日志链路。
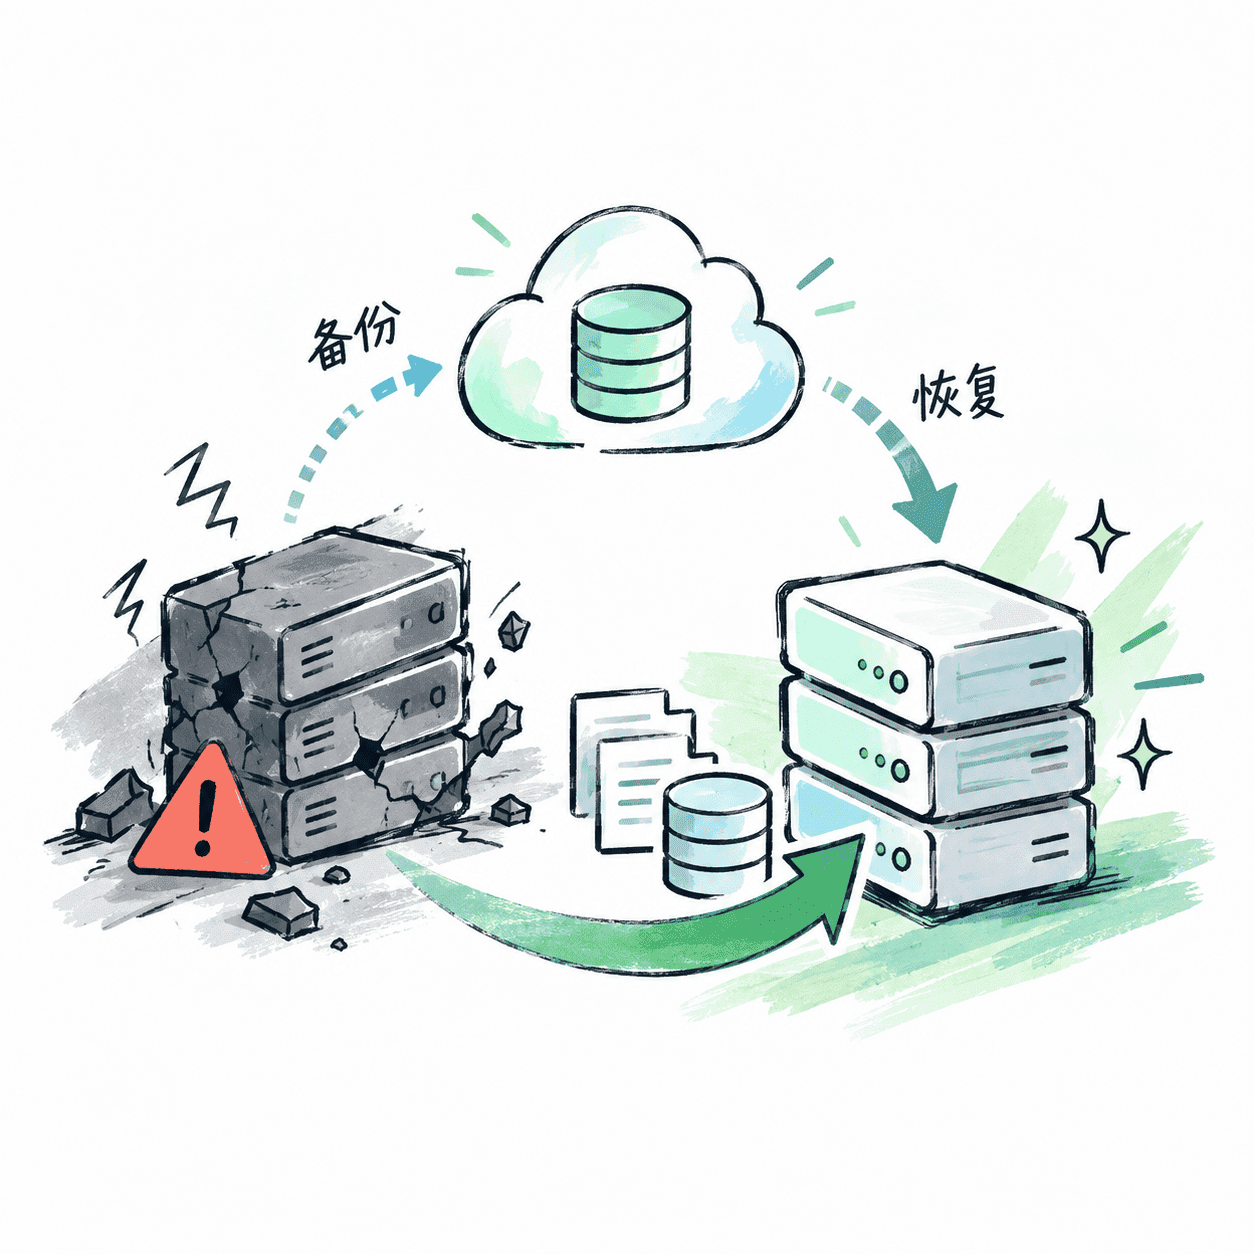
服务器误删、磁盘损坏、数据库故障或整机不可用时,真正困难的是确认备份是否可用、恢复顺序是否正确以及业务何时能重新对外提供服务。本课程围绕备份策略、文件与数据库备份、异地保护、恢复演练、故障切换和灾难重建展开,最终形成可验证、可回滚的恢复方案。
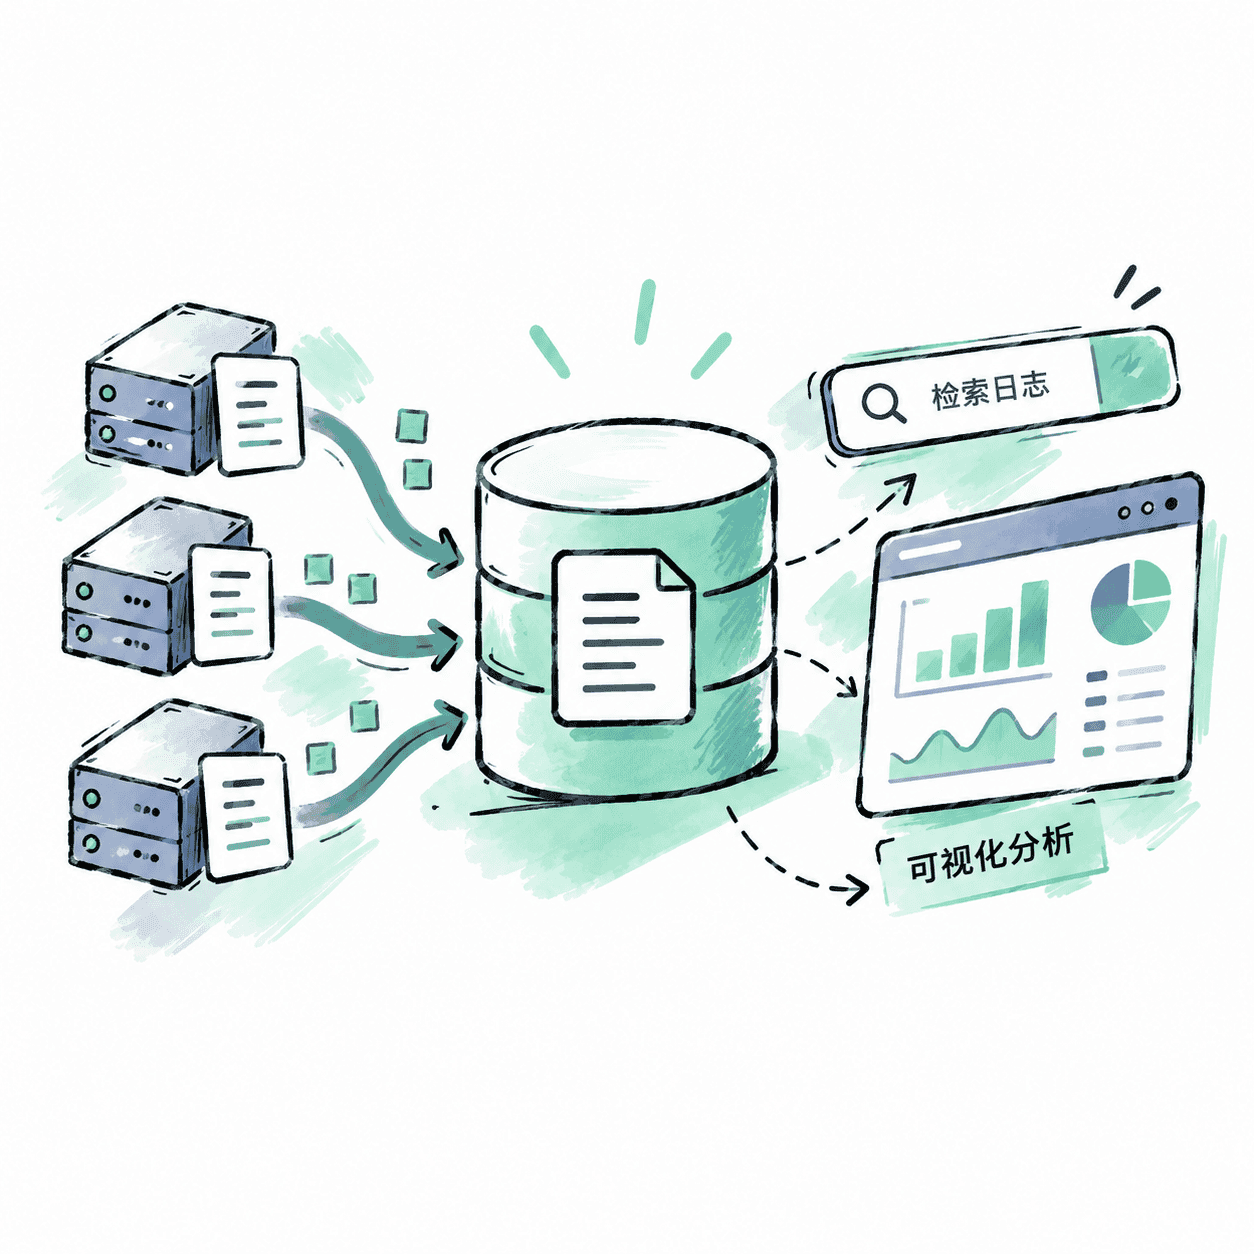
服务器和服务数量增加后,通过 SSH 登录机器逐个 grep 日志很难快速还原一次线上故障。课程从结构化日志和集中日志架构开始,逐步讲解日志采集、字段解析、索引与 Mapping、全文检索、聚合分析、Dashboard、生命周期管理和故障排查,并介绍 OpenSearch 与 Elastic Stack 中对应组件的使用思路。
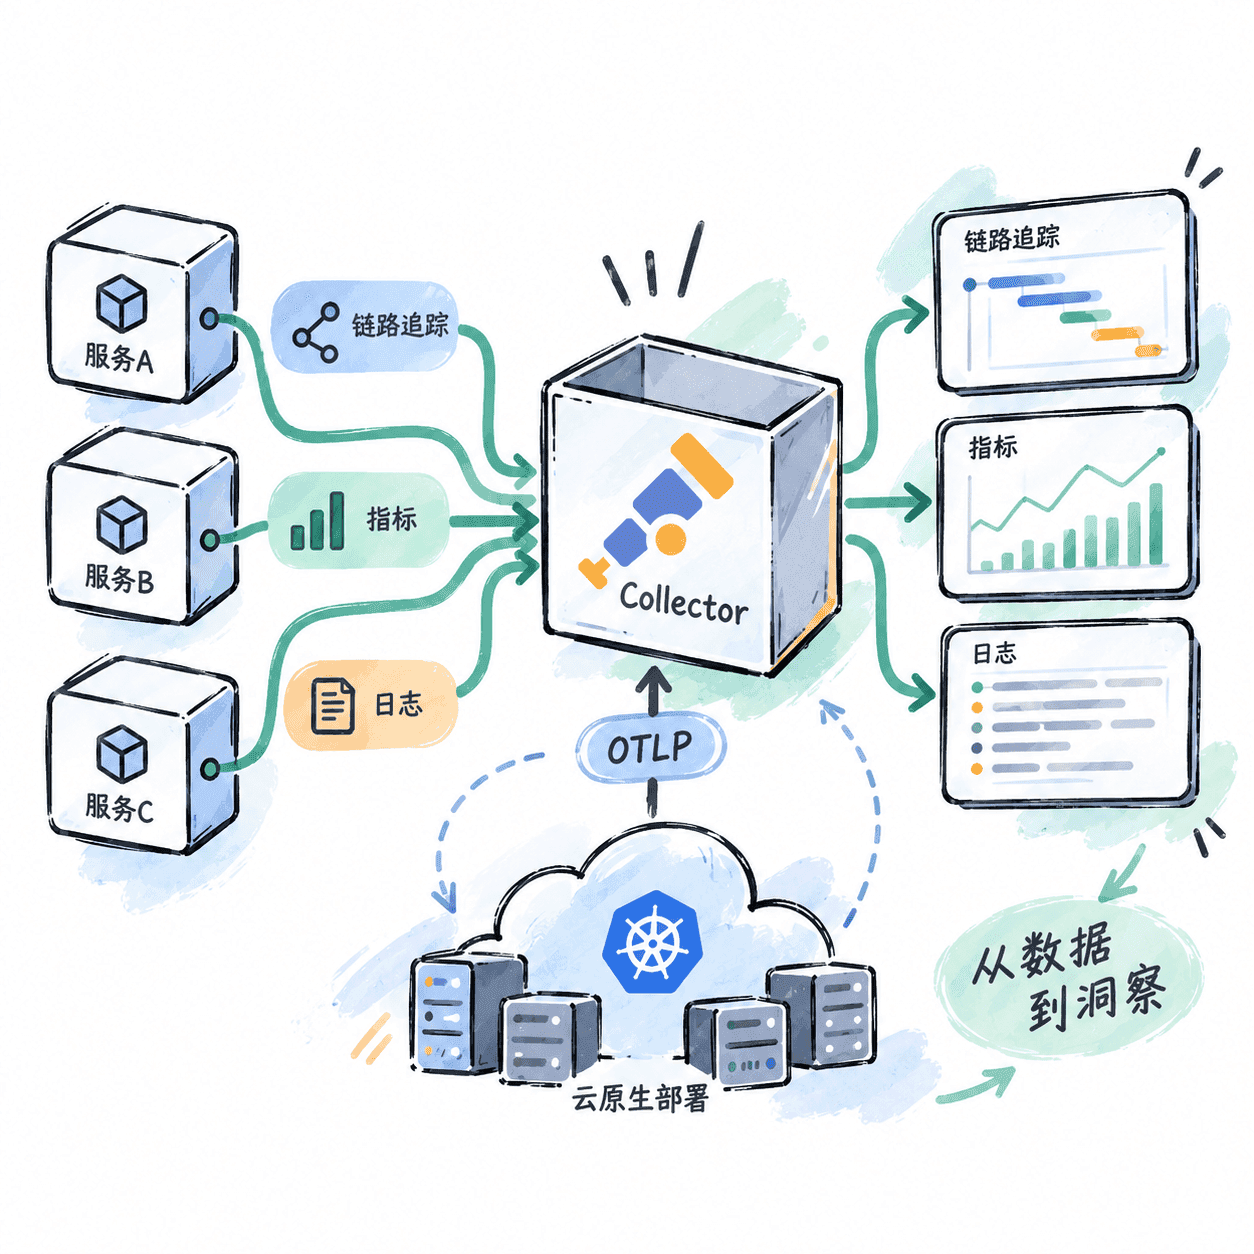
面向微服务与云原生工程实践,系统学习 OpenTelemetry 的遥测数据模型、SDK 埋点、上下文传播、OTLP、Collector 数据管道、指标与日志关联、采样与语义治理,以及 Kubernetes 中的部署、扩缩容和安全运行,最终建立可验证、可演进、可排障的统一遥测链路。
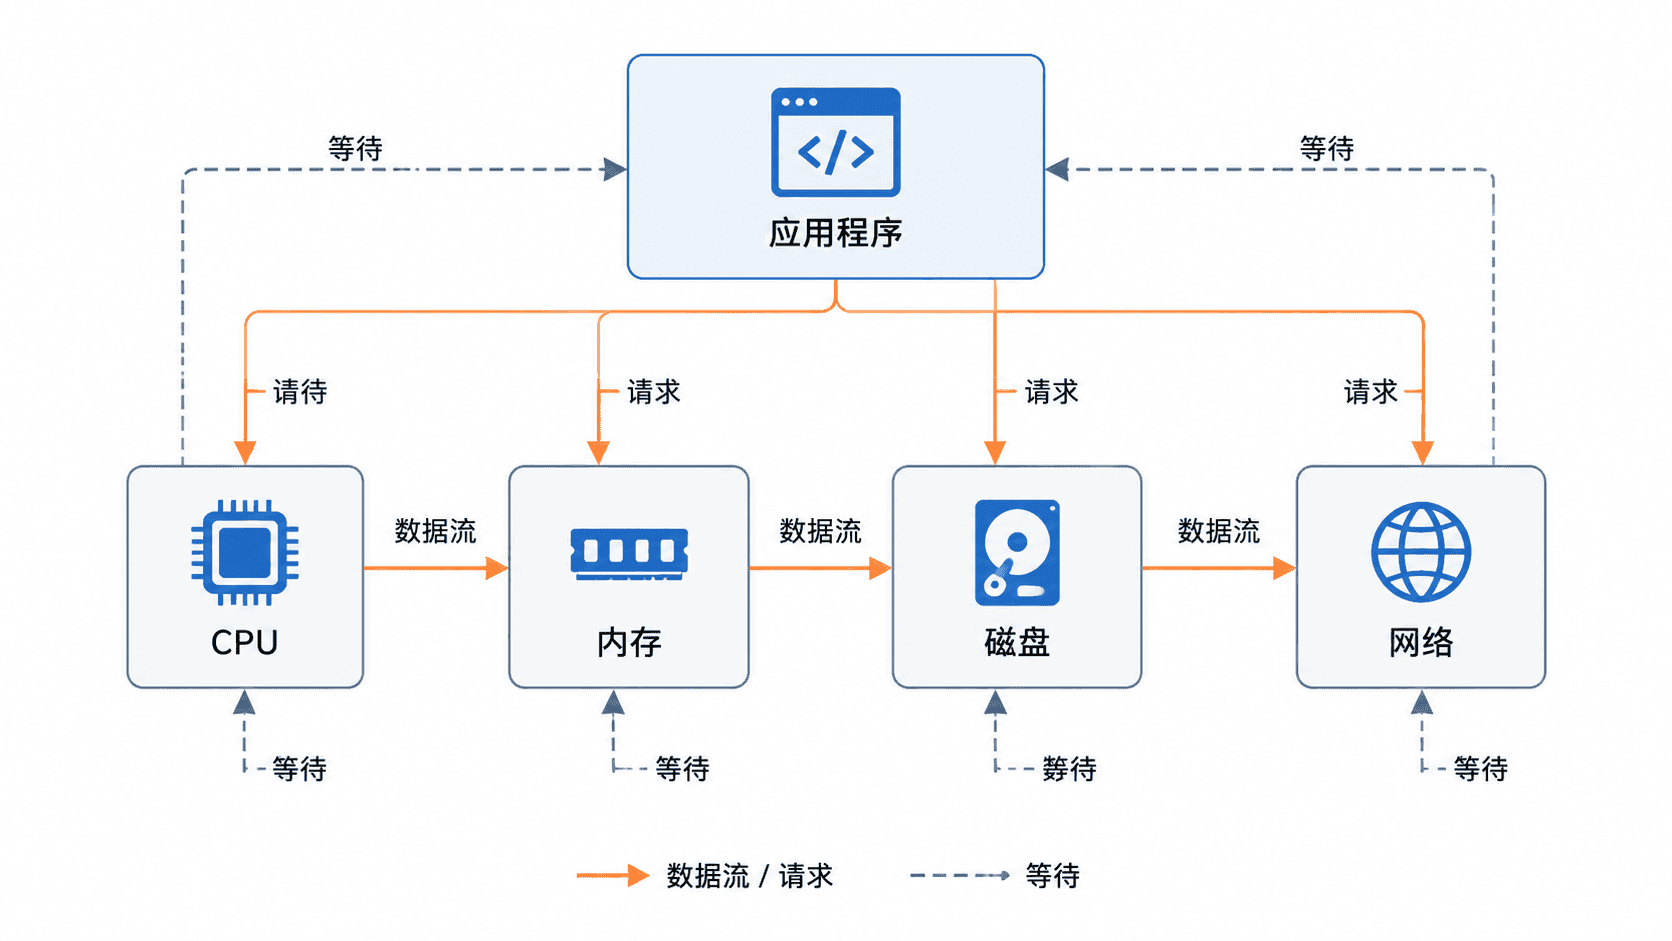
本课程面向需要处理线上性能问题的运维工程师和后端开发者,系统学习 Linux 性能分析方法、核心资源指标、诊断工具和优化策略。从 CPU、内存、磁盘、网络等基础资源入手,结合 perf、top、vmstat、iostat、sar 等工具,建立从发现问题到定位根因再到实施优化的完整能力。