
可观测性与稳定性 / 知识点
Prometheus 告警规则速查
基础告警
用布尔条件直接触发告警,适合 CPU、内存、磁盘等已有明确阈值的指标;先确认指标语义、单位和标签粒度,避免阈值写对但业务含义错误。
创建基础阈值告警
当某个 Prometheus 指标已经有明确阈值时,可以直接用 PromQL 表达式定义告警。完成后应能通过规则检查,并在指标越过阈值时看到告警进入活动状态。
前置条件
- Prometheus 已正常抓取目标指标,并能在查询页面执行对应 PromQL。
- 已确认指标的单位、标签和聚合粒度,避免把比例与百分比、单实例与集群聚合混用。
- 修改规则文件前保留当前可用版本;生产环境应先执行规则检查再加载。
定义规则
下面以实例 CPU 使用率持续高于 80% 的阈值表达式为例。instance:cpu_usage:ratio 表示一个已存在且取值范围为 0~1 的记录规则;实际环境应替换为已经验证过的指标或表达式。
groups:
  - name: host-alerts
    rules:
      - alert: HighCpuUsage
        expr: instance:cpu_usage:ratio > 0.8
        labels:
          severity: warning
        annotations:
          summary: "CPU usage is high on {{ $labels.instance }}"
该配置是规则文件片段,需放入 Prometheus 已通过 rule_files 加载的规则文件中。保存后先检查语法,不要直接依赖服务重载发现错误。
promtool check rules <PATH>预期输出:规则合法时检查成功;具体文件名随 <PATH> 不同而变化。
SUCCESS: <PATH> found 1 rules加载并验证
检查成功后按当前部署方式重新加载 Prometheus,再查看规则与告警状态。若启用了生命周期重载,可向 /-/reload 发送请求;否则应使用部署环境规定的重启或配置发布方式。
验证时确认 HighCpuUsage 已被加载,并检查表达式当前返回的时间序列。条件成立时,没有 for 的规则通常会在后续规则评估中进入 firing;实际出现时间受规则评估周期影响。
失败处理
如果规则未出现,先检查规则文件是否包含在 rule_files 中,再检查重载是否成功。如果规则存在但始终不触发,应直接执行 expr 中的 PromQL,确认指标名称、单位、标签和阈值,而不是先降低阈值。
回滚
新规则造成误报或加载失败时,恢复修改前的规则文件,再执行 promtool check rules <PATH> 并重新加载 Prometheus。确认旧规则恢复后,再离线修正表达式和标签粒度。
让条件连续成立一段时间后才进入告警状态,适合短时尖峰频繁出现的场景;持续时间应结合抓取间隔与业务恢复速度设置。
用 for 抑制瞬时抖动
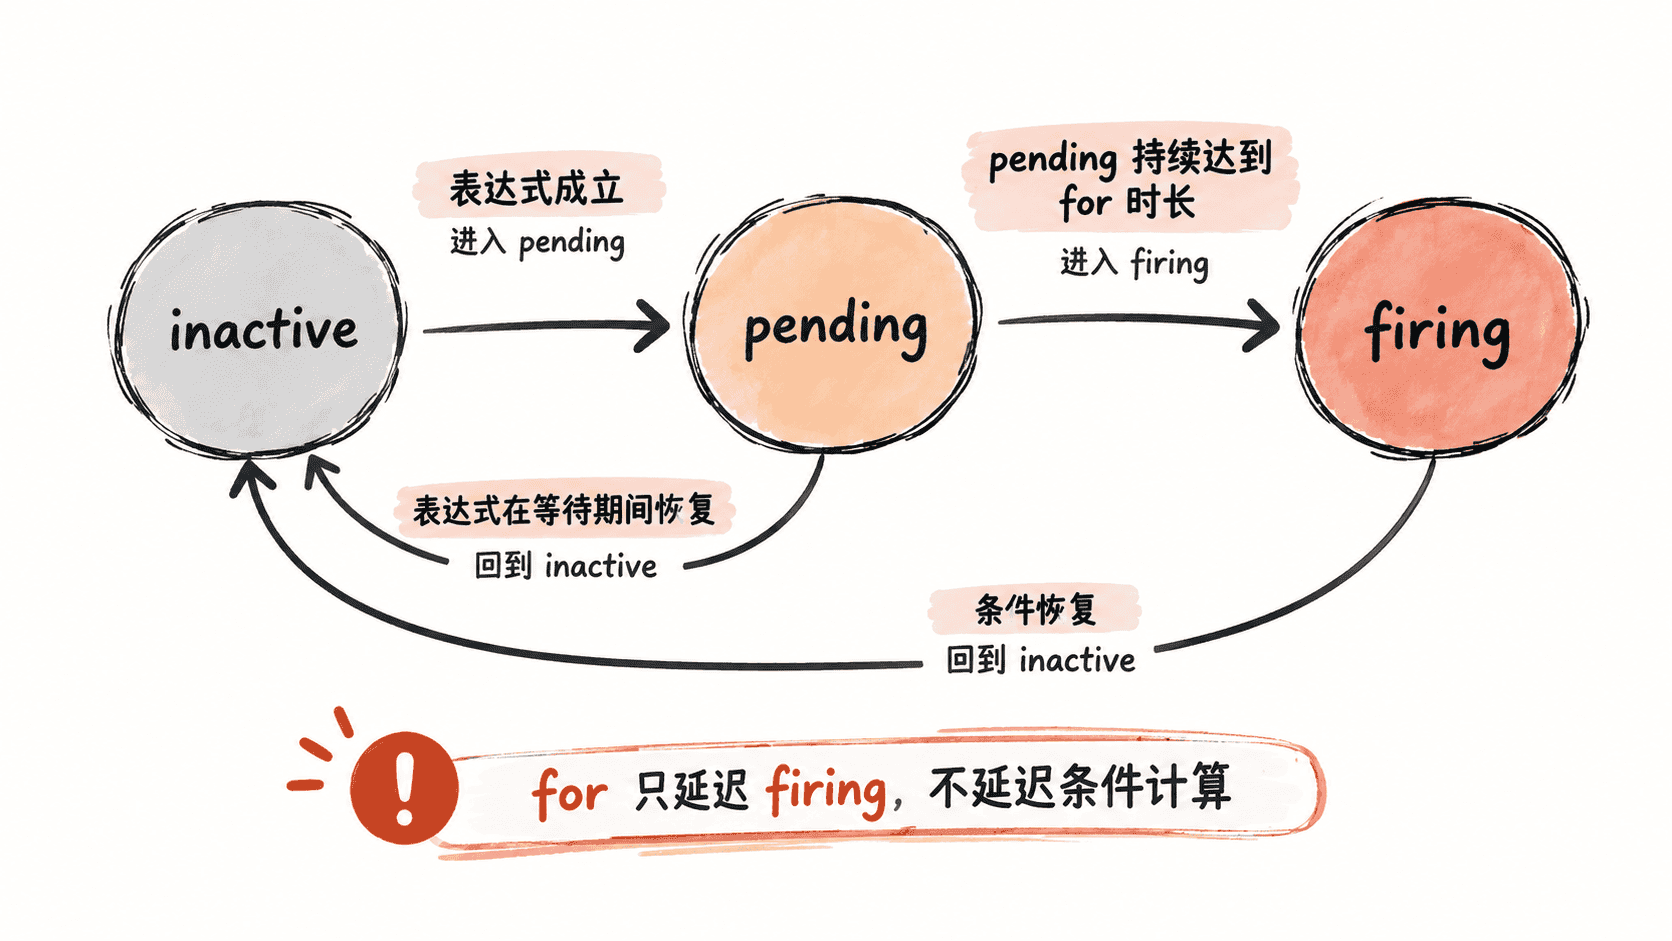
当阈值会被短时尖峰频繁越过时,在告警规则中增加 for,要求条件持续成立后才进入 firing。完成后应能观察到告警先处于 pending,持续达到指定时间后才触发。
前置条件
- 基础 PromQL 条件已经验证,能够稳定返回预期时间序列。
- 已了解当前抓取间隔和规则评估周期,并根据业务可容忍的异常持续时间选择
for。 - 修改生产规则前保留当前版本,并确保可以使用
promtool检查规则文件。
设置持续时间
下面让 CPU 使用率超过 80% 的条件连续成立 5 分钟后再触发告警。instance:cpu_usage:ratio 是示例中的既有记录规则,实际使用时应替换为已验证的指标或表达式。
groups:
  - name: host-alerts
    rules:
      - alert: HighCpuUsage
        expr: instance:cpu_usage:ratio > 0.8
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "CPU usage remains high on {{ $labels.instance }}"
该内容是规则文件片段。保存后先执行语法检查,再按当前部署方式重新加载 Prometheus。
promtool check rules <PATH>预期输出:规则合法时检查成功;实际文件名取决于 <PATH>。
SUCCESS: <PATH> found 1 rules验证状态变化
加载规则后观察对应告警。表达式首次持续成立后,告警应进入 pending;如果条件在 5 分钟内恢复为不成立,pending 会结束而不会进入 firing。只有条件持续满足 for: 5m,告警才会进入 firing。
失败处理
如果告警一直停留在 pending,检查表达式是否在等待期间反复变为不成立,并确认标签集合是否稳定;时间序列的标签变化可能形成新的告警实例。如果预期的短暂异常仍然触发 firing,应检查 for 是否真正加载以及持续时间是否过短。
回滚
如果新增 for 导致告警明显延迟,恢复修改前的规则或调整为已验证的持续时间,重新执行 promtool check rules <PATH> 并加载配置。随后用同一异常场景确认告警时序恢复到预期状态。
通过 labels 为告警附加 severity、team、service 等路由维度,便于 Alertmanager 分组与通知;避免把高变化业务数据写进稳定路由标签。
设置告警标签
需要让 Alertmanager 按严重级别、团队或服务稳定分组和路由时,在告警规则的 labels 中加入低变化、可预测的标签。完成后可直接从生成的告警中确认标签是否存在,再据此配置路由条件。
前置条件
- 已有可正常加载的 Prometheus 告警规则,并确认指标表达式本身有效。
- 先确定 Alertmanager 实际使用的分组和路由维度,例如
severity、team、service,避免规则与路由命名不一致。 - 标签值应保持稳定;请求 ID、时间戳、错误文本等高基数数据不适合作为固定路由标签。
配置步骤
- 为告警选择稳定的严重级别,例如
warning或critical。 - 添加负责处理告警的团队和服务标签,并保持同类规则的命名一致。
- 保存规则后执行规则检查;检查通过后再让 Prometheus 加载变更。
groups:
  - name: example-alerts
    rules:
      - alert: InstanceDown
        expr: up == 0
        for: 5m
        labels:
          severity: critical
          team: platform
          service: example
        annotations:
          summary: "Instance is unavailable"
该配置片段需要放入 Prometheus 规则文件,并由 Prometheus 的 rule_files 配置加载。生效后,满足 up == 0 且持续 5 分钟的告警会携带 severity="critical"、team="platform" 和 service="example"。
验证与失败处理
先用 promtool 检查规则文件,再通过 Prometheus 的 Alerts 页面或 API 查看实际生成的告警标签。
promtool check rules <PATH>预期输出:规则合法时检查成功;具体文件名和输出文本会随 <PATH> 与 Prometheus 版本不同。随后触发或观察该规则,确认告警包含预期的 severity、team 和 service 标签。
如果检查失败,停止加载变更并根据报错修正 YAML 或规则语法。如果规则已触发但通知路由错误,优先核对实际告警标签与 Alertmanager matcher 使用的标签名和值,不要通过不断增加新标签绕过命名不一致。
回滚
保留修改前的规则文件。新增标签导致分组或路由异常时,恢复上一版规则并重新检查、加载;随后确认新产生的告警恢复原有标签集合和通知路径。
把 summary、description、runbook_url 等诊断信息放进 annotations,供值班人员查看;不要用 annotations 承担告警分组或路由职责。
编写 annotations
需要让值班人员收到告警后立即知道发生了什么、影响对象是谁以及去哪里查看处置手册时,把这些诊断信息写入 annotations。完成后可从实际告警中检查渲染后的文本,而路由和分组仍由 labels 负责。
前置条件
- 已有可触发的 Prometheus 告警规则,并能识别规则表达式产生的标签。
- 明确哪些信息用于阅读,哪些用于路由;
summary、description、runbook_url适合作为说明信息,不应代替稳定的路由标签。 - 模板中引用标签前,确认该标签确实由查询结果或规则提供,避免通知中出现空值。
编写步骤
- 用
summary写简短、可扫描的问题描述。 - 用
description补充受影响对象和关键诊断信息;需要引用告警标签时使用模板变量。 - 有稳定的处置文档时添加
runbook_url,并确保链接长期可访问。 - 保存后先检查规则语法,再观察实际告警中的 annotation 渲染结果。
groups:
  - name: example-alerts
    rules:
      - alert: InstanceDown
        expr: up == 0
        for: 5m
        labels:
          severity: critical
        annotations:
          summary: "Instance {{ $labels.instance }} is unavailable"
          description: "Target {{ $labels.instance }} has reported up=0 for at least 5 minutes."
          runbook_url: "https://example.com/runbooks/instance-down"
这是规则文件片段;其中 URL 是示例地址,生产环境应替换为真实且可访问的处置文档。告警触发后,$labels.instance 会按该告警实例携带的 instance 标签进行渲染。
验证与失败处理
先检查规则文件是否有效,再从 Prometheus 的 Alerts 页面或 API 读取触发后的 annotations,确认模板变量已经替换为实际标签值。
promtool check rules <PATH>预期输出:规则合法时检查成功;具体文件名和输出文本取决于 <PATH> 与 Prometheus 版本。实际告警中应能看到渲染后的 summary、description 和配置的 runbook_url。
如果模板变量显示为空,先检查表达式结果是否包含对应标签;如果通知可以收到但无法按团队或严重级别正确路由,应把用于匹配的维度放入 labels,而不是继续增加 annotations。
回滚
修改造成通知文本错误或模板无法正确渲染时,恢复上一版规则文件,重新执行规则检查并加载配置。回滚后再次查看新产生的告警,确认 annotations 已恢复为上一版内容。
PromQL 告警表达式
使用聚合保留 instance 或其他必要标签,让同类指标按实例生成独立告警;聚合前先明确告警应该代表单机、服务还是整个集群。
按实例聚合告警
当告警需要精确指出哪个实例异常时,先把原始时间序列聚合到 instance 维度,并明确保留哪些用于定位的标签。完成后,每个异常实例应产生独立结果,而不是被服务级或集群级聚合掩盖。
前置条件
- 指标必须包含稳定的
instance标签;如果环境使用其他实例标识,应替换为实际标签。 - 先确认告警语义确实是“单实例异常”。服务整体容量、可用率等问题不应机械保留
instance。 - 在 Prometheus 表达式浏览器中先验证查询结果,再写入告警规则,避免标签聚合错误直接进入通知链路。
聚合并检查结果
以每个实例的 HTTP 5xx 请求速率为例,可先对原始计数器求速率,再按 instance 聚合:
sum by (instance) (
  rate(http_requests_total{status=~"5.."}[5m])
)
预期结果:查询结果中每条时间序列只代表一个 instance 的 5xx 请求速率;实际实例名称和数值取决于当前采集数据。
在确认实例维度正确后再加入阈值,例如:
sum by (instance) (
  rate(http_requests_total{status=~"5.."}[5m])
) > 1
预期结果:只有当前 5 分钟窗口内 5xx 平均速率超过每秒 1 次的实例保留在查询结果中;无匹配结果表示当前没有实例满足该条件。
写入规则并验证
片段示例:以下内容需要放入现有 Prometheus rule group 的 rules 列表中,阈值与持续时间应按业务基线调整。
- alert: InstanceHighHttp5xxRate
  expr: sum by (instance) (rate(http_requests_total{status=~"5.."}[5m])) > 1
  for: 5m
  labels:
    severity: warning
  annotations:
    summary: "Instance {{ $labels.instance }} has a high HTTP 5xx rate"
验证时查看 Prometheus 的规则状态,并确认告警实例保留了 instance 标签。表达式持续满足 for 指定的时间后才会进入 firing;未持续满足时不会触发该告警。
失败处理
如果多个实例被合成一条结果,检查聚合是否误写成不带分组标签的 sum(...)。如果同一实例仍出现多条结果,说明查询中还保留了其他标签维度,应根据告警语义决定是否继续聚合。
如果查询完全没有结果,先单独查询原始指标并核对指标名、status 与 instance 标签。不要为了得到结果直接删除过滤条件或提高聚合范围,否则可能改变告警语义。
回滚方式
新规则产生错误告警时,恢复上一版规则文件并重新加载 Prometheus 配置。回滚后再次检查规则状态和查询结果,确认旧表达式已生效,同时保留错误样本用于修正聚合标签。
先分别计算错误请求率与总请求率,再聚合到服务维度,适合 HTTP 5xx、RPC 错误等比例型告警;避免直接对未聚合的单实例比例求平均。
统计服务整体错误率
当告警要回答“整个服务有多少比例的请求失败”时,应先分别汇总服务的错误请求速率和总请求速率,再做除法。这样高流量实例会按实际请求量参与计算,不会因直接平均各实例错误率而失真。
前置条件
- 请求计数指标应是可用于
rate()的单调递增计数器,并具有可识别服务和错误类型的标签。 - 以下示例假定指标为
http_requests_total,服务标签为service,HTTP 状态标签为status;实际环境不同应使用真实标签。 - 写告警前先确认分母存在且服务确实有请求流量,并根据业务基线确定错误率阈值和观察窗口。
计算服务错误率
先分别对错误请求和全部请求求速率,再按 service 汇总并相除:
sum by (service) (
  rate(http_requests_total{status=~"5.."}[5m])
)
/
sum by (service) (
  rate(http_requests_total[5m])
)
预期结果:每个 service 返回一条比例值。例如结果为 0.02 表示该服务在当前计算窗口中的整体 5xx 请求率约为 2%;实际服务名和数值取决于采集数据。
不要先算每个实例的错误率再使用 avg 求服务平均值。一个每秒处理 1 个请求的实例和一个每秒处理 1000 个请求的实例不应获得相同权重。
加入告警条件
例如需要检测整体 5xx 比例超过 5% 的服务,可在比例表达式后加入阈值:
(
  sum by (service) (rate(http_requests_total{status=~"5.."}[5m]))
/
  sum by (service) (rate(http_requests_total[5m]))
) > 0.05
预期结果:只有整体 5xx 比例超过 0.05 的服务出现在查询结果中;没有结果表示当前没有服务满足该条件。生产规则是否应采用 5% 阈值需依据实际服务基线决定。
写入规则并验证
片段示例:以下规则需要加入现有 rule group;for、阈值和严重级别应结合实际流量与告警策略调整。
- alert: ServiceHighHttp5xxRatio
  expr: (sum by (service) (rate(http_requests_total{status=~"5.."}[5m])) / sum by (service) (rate(http_requests_total[5m]))) > 0.05
  for: 5m
  labels:
    severity: warning
  annotations:
    summary: "Service {{ $labels.service }} has a high HTTP 5xx ratio"
验证时先在表达式浏览器确认每个结果只保留目标 service 标签,再检查规则状态。条件必须连续满足 for 指定的时间才会进入 firing。
失败处理
结果异常偏高或偏低时,分别查询分子和分母,确认两边使用相同的服务维度和统计窗口。若分子、分母保留的标签集合不同,PromQL 向量匹配可能导致结果缺失或语义错误。
低流量服务可能因极少量错误请求产生很高比例。需要避免这类噪声时,应另外定义最小流量条件,而不是修改比例计算方式;具体门槛应来自业务流量基线。
回滚方式
如果新表达式产生大量误报,恢复上一版规则并重新加载 Prometheus 配置。确认旧规则恢复后,再使用保存的分子、分母和最终比例样本分析标签、窗口或阈值问题,避免直接在线反复修改计算口径。
对 counter 使用 rate 计算单位时间增长率,适合请求数、错误数等持续递增指标;需要先做 rate 再聚合,以便正确处理计数器重置。
用 rate 计算增长速率
当告警条件关注请求、错误等 Counter 每秒增长速度时,用 rate() 把窗口内的计数器变化转换为平均每秒速率。关键顺序是先对各时间序列计算 rate(),再按业务维度聚合,避免聚合后丢失单条序列的计数器重置信息。
前置条件
- 指标必须具有 Counter 语义,即正常情况下持续递增,但进程重启等情况允许重置。
- 范围窗口需要包含足够样本;实际窗口应结合抓取间隔和告警灵敏度选择。
- 聚合前确认需要保留的标签,例如
job、service或instance,避免告警范围被意外扩大。
编写表达式
先对每条 Counter 时间序列执行 rate(),再用 sum by (...) 聚合。例如统计每个 job 的 HTTP 请求平均每秒速率:
sum by (job) (rate(http_requests_total[5m]))预期结果:Prometheus 返回每个 job 对应的瞬时向量;样本值表示最近 5 分钟窗口估算出的平均每秒增长率。具体数值取决于实际采样数据。
如果要针对错误请求触发告警,可先通过标签筛选错误序列,再计算速率和聚合:
groups:
  - name: http-alerts
    rules:
      - alert: HttpErrorRateHigh
        expr: sum by (job) (rate(http_requests_total{status=~"5.."}[5m])) > 1
        for: 10m
        labels:
          severity: warning
生效行为:某个 job 的 5xx Counter 平均增长速率持续 10 分钟高于每秒 1 次时,该告警满足触发条件。阈值和窗口只是示例,生产环境应按业务基线确定。
验证检查点
在 Prometheus 表达式查询界面先单独执行 rate(http_requests_total[5m]),确认各原始序列能得到速率,再执行聚合表达式。若结果为空,检查指标名称、标签筛选条件以及窗口内是否存在足够样本。
失败处理与恢复
若告警在实例重启后出现异常尖峰,先检查表达式是否遵循 rate() 后聚合的顺序。若查询波动过大,可在不改变指标语义的前提下重新评估范围窗口;修改告警前保留原表达式,验证新表达式符合预期后再替换,异常时可恢复原规则。
用 increase 读取窗口内计数器增长量,适合直接表达某时间段发生多少次事件;结果会按选择器窗口进行外推,不应误当作瞬时值。
计算窗口内增加量
当告警条件需要表达“最近一段时间发生了多少次”时,用 increase() 计算 Counter 在指定范围窗口内的增长量。结果代表整个窗口的估算增加量,并会根据窗口边界进行外推,因此不要把它解释为某一瞬间的计数值。
前置条件
- 目标指标必须具有 Counter 语义;Gauge 不应使用
increase()表达普通增减量。 - 根据事件密度、抓取间隔和告警响应要求选择范围窗口。
- 明确是按单条序列判断还是按
job、service等标签聚合,避免把无关实例混在一起。
编写表达式
例如查询每个 job 最近 10 分钟累计增加的错误次数,可以先对各 Counter 序列计算 increase(),再进行聚合:
sum by (job) (increase(http_requests_total{status=~"5.."}[10m]))预期结果:Prometheus 返回每个 job 在最近 10 分钟内估算的 5xx 请求增加量。由于 increase() 会针对范围窗口边界进行外推,结果可能出现非整数,即使底层 Counter 只按整数递增。
用于告警规则时,可以直接对窗口增加量设置阈值:
groups:
  - name: http-alerts
    rules:
      - alert: TooManyHttpErrors
        expr: sum by (job) (increase(http_requests_total{status=~"5.."}[10m])) > 100
        labels:
          severity: warning
生效行为:某个 job 最近 10 分钟的 5xx Counter 估算增加量超过 100 时,表达式为真。示例没有配置 for,因此是否进入 firing 还取决于 Prometheus 的规则评估和告警状态转换;实际阈值应按业务基线设置。
验证检查点
先查询原始 Counter,确认窗口内确实存在增长,再执行 increase() 表达式。若结果与人工用窗口首尾样本直接相减不完全一致,不要立即判断计算错误,因为 increase() 会处理 Counter 重置并对窗口边界进行外推。
失败处理与恢复
结果为空时,检查标签过滤、指标是否存在以及窗口内样本是否充足;结果异常时检查指标是否确为 Counter,并确认是否发生进程重启或计数器重置。修改窗口或阈值前保留原规则,先通过查询界面验证新表达式,再更新告警;验证失败时恢复原表达式。
可用性与缺失检测
用 absent 或 absent_over_time 判断预期时间序列是否不存在,适合关键 exporter、实例或指标消失检测;需区分指标不存在与目标被整体下线。
检测目标是否消失
当某个关键实例或指标本应持续存在,却可能因 exporter 停止、采集配置变化或目标下线而完全没有时间序列时,可用 absent() 或 absent_over_time() 建立缺失告警。完成后应能验证:预期序列存在时表达式无结果,序列缺失达到观察窗口后返回可触发告警的结果。
前置条件
- 先确认被检测的指标在正常状态下持续存在,并选择能稳定标识目标的标签,例如
job或instance。 - 明确目标是否允许计划下线;如果实例会动态增删,仅凭“序列不存在”无法判断它是否仍属于期望目标集合。
- 修改生产规则前先使用 Prometheus 表达式浏览器或兼容的查询接口验证 PromQL,并确认告警规则文件可被当前 Prometheus 加载。
配置缺失检测
若要判断当前时刻是否完全没有匹配序列,可使用 absent();若希望容忍短暂缺样并确认一段时间内始终没有样本,可使用 absent_over_time()。下面的片段示例需放入现有 Prometheus rule group 的 rules 中:
- alert: ExpectedMetricMissing
  expr: absent_over_time(my_critical_metric{job="example"}[5m])
  labels:
    severity: warning
  annotations:
    summary: "Expected metric has disappeared"
该规则的生效行为是:只有查询窗口内不存在匹配的 my_critical_metric{job="example"} 时间序列时,表达式才产生结果。保存后应先执行规则校验,再重新加载 Prometheus;具体校验文件路径按部署环境替换 <PATH>。
promtool check rules <PATH>预期输出:规则语法正确时,promtool 报告检查成功;实际文件名和附加统计信息可能随路径及 Prometheus 版本不同。
SUCCESS: <PATH>验证检查点
在查询页面执行与规则相同的表达式。正常指标持续上报时应得到空结果;停止测试目标并等待完整的 5 分钟查询窗口后,表达式应返回一个结果。恢复指标后再次查询,结果应消失。
指标存在:空结果
连续 5 分钟无匹配样本:返回 1 个结果,样本值为 1
指标恢复:空结果
失败处理
如果预期缺失却始终没有结果,先检查标签选择器是否与真实序列一致,以及查询窗口内是否仍残留样本。如果规则频繁在正常维护期间触发,应把计划下线、服务发现状态或其他“目标是否仍被期望存在”的信息纳入告警设计,而不是单纯扩大缺失窗口。
恢复与回滚
规则导致误报时,先恢复上一版规则文件并重新加载 Prometheus,再确认对应告警不再产生新实例。保留原表达式、标签选择器和误报时间段,用实际序列回放验证后再重新上线。
基于 up 指标检测 Prometheus 是否成功抓取目标,适合快速发现 exporter、网络或服务端点异常;它反映抓取状态,不等同于应用业务健康。
检测实例抓取异常
当需要确认 Prometheus 能否成功抓取某个目标时,可基于自动生成的 up 指标建立告警。完成后应能验证:抓取正常时 up 为 1,抓取失败时为 0,持续失败达到设定时间后告警进入 firing 状态。
前置条件
- 目标已经由 Prometheus 服务发现或静态配置纳入抓取范围,并能在 Targets 页面看到。
- 先确认用于筛选的
job、instance等标签与实际目标一致,避免规则误匹配其他实例。 - 修改生产规则前保留上一版规则文件,并使用当前 Prometheus 配套的
promtool做语法检查。
配置抓取失败告警
下面的片段示例需加入现有 rule group 的 rules 中。for: 5m 用于过滤短暂网络抖动,具体持续时间应按抓取间隔和故障响应要求调整。
- alert: PrometheusTargetDown
  expr: up{job="example"} == 0
  for: 5m
  labels:
    severity: warning
  annotations:
    summary: "Prometheus target is down"
保存规则后先检查文件;将 <PATH> 替换为实际规则文件路径。
promtool check rules <PATH>预期输出:规则合法时检查成功;实际路径及附加统计信息可能因 Prometheus 版本而不同。
SUCCESS: <PATH>验证检查点
先查询 up{job="example"},正常目标的样本值应为 1。在受控测试环境中停止 exporter、阻断测试端点或使用其他可恢复方式制造抓取失败,等待下一次抓取后应看到对应序列变为 0;持续满足条件 5 分钟后,再从 Prometheus Alerts 页面确认告警状态。
抓取成功:up = 1
抓取失败:up = 0
持续失败不足 5 分钟:告警处于 pending
持续失败达到 5 分钟:告警进入 firing
失败处理
如果 up 为 0,先从 Targets 页面读取该目标的最近抓取错误,再按错误定位 exporter 进程、DNS、网络、TLS、认证或 HTTP 端点。如果查询不到预期的 up 序列,则应先检查服务发现和标签匹配,而不是把它直接解释为普通抓取失败。
恢复与回滚
测试后恢复 exporter、网络或端点配置,并确认后续抓取使 up 回到 1。如果新规则产生误报,恢复上一版规则文件并重新加载 Prometheus;随后根据实际抓取间隔、短暂故障持续时间和目标标签重新调整表达式或 for 时长。
使用 absent_over_time 检查一段窗口内完全没有样本,适合低频指标或关键业务指标停更场景;窗口应覆盖正常采集周期,否则容易误报。
检测指标持续无数据
当关键指标在预期采集窗口内完全没有样本时,可用 absent_over_time() 建立缺失告警。完成后应能确认告警只在整个窗口无样本时触发,并且窗口长度覆盖正常采集间隔和允许的短暂抖动。
前置条件
- 已确认目标指标名称、关键标签和正常采集周期,能够区分“指标缺失”与“指标值为 0”。
- Prometheus 能正常抓取对应目标;如果整个抓取目标不可达,还应结合
up等可用性指标定位原因。 - 窗口应明显长于正常采集周期。低频业务指标尤其不能直接照搬高频指标的窗口。
配置告警
先在 Prometheus 表达式浏览器中验证查询,再写入规则文件。以下示例假定 business_heartbeat 正常情况下至少每 5 分钟产生一次样本,因此检查最近 15 分钟是否完全无样本。
absent_over_time(business_heartbeat{job="order-service"}[15m])预期结果:最近 15 分钟至少存在一个匹配样本时查询结果为空;整个窗口完全没有匹配样本时返回一个值为 1 的结果。
确认表达式符合预期后,可将其用于告警规则。
groups:
  - name: availability
    rules:
      - alert: BusinessHeartbeatMissing
        expr: absent_over_time(business_heartbeat{job="order-service"}[15m])
        labels:
          severity: warning
        annotations:
          summary: "order-service heartbeat missing"
生效行为:当指定时间窗口内完全不存在匹配样本时,表达式成立并进入告警状态;规则评估周期由 Prometheus 配置决定。
验证检查点
加载规则后先检查规则是否被 Prometheus 接受,再观察表达式本身。正常采集时应无结果;测试环境停止对应指标产生或采集,并等待完整窗口后,应看到表达式返回 1。
promtool check rules <PATH>预期输出:规则文件有效时输出中包含 SUCCESS;<PATH> 替换为实际规则文件路径,具体文件名和检查统计可能不同。
失败处理
如果正常业务频繁触发,先检查窗口是否小于或过于接近实际采集间隔,再确认标签筛选是否稳定。标签值变化会让旧标签组合看起来像“持续无数据”。
如果指标缺失却没有触发,直接执行 absent_over_time() 表达式检查是否仍存在匹配序列;同时确认规则文件已经加载、告警规则处于活动规则集合中。
恢复方式
误报时先恢复原规则或扩大到已经验证过的窗口,再重新加载规则。若缺失是真实故障,应恢复指标生产或采集链路;新样本重新进入检查窗口后,表达式会恢复为空结果。
资源与容量告警
按可用字节或可用百分比建立阈值告警,适合节点和挂载点容量监控;应排除临时文件系统、只读特殊挂载及无需告警的设备类型。
监控磁盘空间不足
使用 node_exporter 的文件系统指标可以按挂载点计算剩余空间比例,并在容量低于阈值时告警。完成配置后,应能定位具体实例和挂载点,同时避免临时文件系统或无需监控的挂载造成噪声。
前置条件
- Prometheus 已成功采集 node_exporter,并能查询
node_filesystem_avail_bytes与node_filesystem_size_bytes。 - 已确认需要监控的文件系统和挂载点范围;排除规则必须根据实际环境验证,不能直接假定所有主机设备类型相同。
- 修改生产告警前保留现有规则,并先在表达式浏览器检查筛选后的时间序列。
确认容量指标
先计算每个文件系统的可用空间百分比。以下查询仅演示常见的临时文件系统排除方式,实际环境应先检查 fstype 标签再决定过滤条件。
100 * node_filesystem_avail_bytes{fstype!~"tmpfs|devtmpfs"} / node_filesystem_size_bytes{fstype!~"tmpfs|devtmpfs"}预期结果:每条结果代表一个匹配文件系统的可用空间百分比;例如结果值为 8 表示约 8% 可用。实际实例、设备、挂载点和数值取决于当前主机状态。
确认筛选范围后再建立阈值规则。下面以可用空间低于 10% 且持续 10 分钟为示例阈值,生产环境应根据容量增长速度和处置时间调整。
groups:
  - name: filesystem-capacity
    rules:
      - alert: FilesystemLowSpace
        expr: 100 * node_filesystem_avail_bytes{fstype!~"tmpfs|devtmpfs"} / node_filesystem_size_bytes{fstype!~"tmpfs|devtmpfs"} < 10
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "Filesystem available space is below 10%"
生效行为:匹配文件系统的可用空间比例连续 10 分钟低于 10% 时告警进入 firing;比例恢复到阈值以上后条件不再成立。
验证检查点
保存规则后先做语法检查,再加载到 Prometheus。随后在表达式浏览器执行与规则相同的 PromQL,确认返回的 instance、device、mountpoint 和 fstype 都属于预期监控范围。
promtool check rules <PATH>预期输出:有效规则的检查结果包含 SUCCESS;<PATH> 为实际规则文件路径,输出中的规则组和规则数量随文件内容变化。
失败处理
如果出现大量无意义挂载告警,先查询文件系统指标的 fstype、device 与 mountpoint 标签,再缩小过滤范围,不要仅凭设备名猜测。若某挂载点明明接近满盘却未告警,应检查它是否被过滤、对应指标是否存在,以及分母 node_filesystem_size_bytes 是否符合预期。
恢复方式
规则过滤或阈值配置错误时,恢复上一版已验证规则并重新加载。真实容量不足时应先释放可安全删除的数据或扩容文件系统,再执行同一 PromQL;确认剩余比例回到阈值以上且告警恢复后,再结束处置。
围绕可用内存或内存工作集设置阈值,适合节点级资源告警;不同 exporter 指标语义可能不同,计算前应确认 free、buffers、cache 与 available 的定义。
监控内存压力
当节点开始频繁回收内存、接近交换或 OOM 风险时,应基于可用内存而不是简单的 free 值告警。完成后应能识别持续内存压力,同时避免把可回收缓存误判为内存耗尽。
前置条件
- Prometheus 已成功抓取目标节点的内存指标。
- 使用 node_exporter 时,先在 Prometheus 中确认
node_memory_MemAvailable_bytes与node_memory_MemTotal_bytes实际存在。 - 先观察正常业务周期的基线,再确定阈值和持续时间;不要直接把示例阈值视为生产标准。
- 如果使用其他 exporter,必须先确认 available、free、cache 等指标的语义,不能直接替换指标名。
配置告警规则
下面以 node_exporter 常见指标为例,把可用内存低于总内存 10% 且持续 10 分钟作为示例阈值。规则文件可放入 Prometheus 已加载的规则目录,实际路径以部署配置为准。
groups:
  - name: node-memory
    rules:
      - alert: NodeMemoryPressure
        expr: node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes < 0.10
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "Node available memory is low"
          description: "Available memory has remained below 10% for 10 minutes."
预期结果:规则被 Prometheus 成功加载;只有表达式连续满足 10 分钟后,告警才从 pending 进入 firing。阈值与持续时间应根据节点用途和历史基线调整。
验证规则
先检查规则文件语法,再到 Prometheus 查询表达式本身,确认计算结果符合预期。
promtool check rules <PATH>预期输出:<PATH> 为实际规则文件路径;语法正确时会显示规则检查成功信息,具体文件名和统计信息随版本及规则内容不同。
在 Prometheus 表达式查询页面执行:
node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes预期结果:每个目标返回一个 0~1 范围内的比例值。例如查询结果为 0.08 时,表示当前可用内存约占总内存 8%;实际值取决于节点当前状态。
失败处理
规则没有数据时,先分别查询两个原始指标。若指标不存在,应检查 exporter 版本、采集器是否启用以及抓取目标是否正常,不要把无数据解释成内存正常。
如果告警频繁抖动,先检查阈值附近的历史曲线,再调整 for 持续时间或阈值。若节点已经出现 OOM、明显交换压力或业务延迟,不应仅通过放宽阈值消除告警。
回滚方式
新规则产生大量误报时,恢复上一版规则文件并重新加载 Prometheus,然后确认该规则已恢复到原配置。保留误报期间的内存曲线,用于重新确定阈值,而不是直接删除内存压力监控。
通过 CPU 时间的 rate 计算占用比例并设置持续阈值,适合发现长期高负载节点;多核环境应确认聚合方式,避免把累计时间直接当作百分比。
监控 CPU 持续过高
节点 CPU 长时间接近饱和时,应从 CPU 时间计数器的增长速率计算占用比例,并通过持续时间过滤短暂尖峰。完成后应能得到节点级 CPU 使用率告警,同时正确处理多核 CPU 的聚合。
前置条件
- Prometheus 已成功抓取目标节点的 CPU 指标。
- 使用 node_exporter 时,确认
node_cpu_seconds_total存在并带有instance、cpu、mode等标签。 - 先观察业务高峰和低峰的正常 CPU 基线,再确定阈值与持续时间。
- 告警前确认目标是监控节点总体利用率,而不是某个单独 CPU 核心。
配置告警规则
node_cpu_seconds_total 是累计 CPU 时间,不能直接作为百分比。下面先计算每个实例 idle 时间的速率并对所有 CPU 核心取平均,再用 1 - idle 得到节点总体使用比例。80% 持续 10 分钟仅作为示例阈值。
groups:
  - name: node-cpu
    rules:
      - alert: NodeHighCPUUsage
        expr: 1 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m])) > 0.80
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "Node CPU usage is high"
          description: "CPU usage has remained above 80% for 10 minutes."
预期结果:Prometheus 成功加载规则;表达式持续高于 0.80 达到 10 分钟后告警进入 firing。短于持续时间的 CPU 峰值不会直接触发 firing。
验证计算结果
先检查规则语法,再单独执行 PromQL,确认多核聚合后的比例符合节点实际负载。
promtool check rules <PATH>预期输出:<PATH> 替换为实际规则文件路径;规则合法时会显示检查成功信息,具体输出文本可能随 Prometheus 版本和文件内容变化。
在 Prometheus 表达式查询页面执行:
1 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]))预期结果:每个 instance 得到一个通常位于 0~1 范围内的 CPU 使用比例。例如结果 0.85 表示该计算窗口内总体 CPU 使用率约为 85%;实际结果随负载变化。
失败处理
查询无数据时,先查询 node_cpu_seconds_total,检查 exporter、抓取目标以及标签是否与表达式匹配。若原始指标存在而结果异常,再检查是否误删了 mode="idle" 条件或改变了聚合维度。
如果多核节点得到明显超过预期的数值,应检查是否使用了 sum 累加各核心利用率却仍把结果当成 0~100% 的节点百分比。节点总体利用率与“已使用多少个 CPU 核心”是不同口径,应先确定告警目标再选择聚合方式。
回滚方式
新规则出现明显误报时,恢复上一版规则文件并重新加载 Prometheus,确认错误规则不再生效。保留对应时段的 CPU 曲线和业务指标,重新校准阈值、查询窗口及 for 持续时间后再发布。
用 predict_linear 根据历史 gauge 趋势估计未来值,适合容量持续增长场景;它假设近期开趋势可延续,不适合作为唯一容量保护机制。
预测磁盘即将耗尽
当磁盘剩余空间持续下降,希望在真正写满前获得预警时,可用 predict_linear 根据近期 gauge 样本拟合线性趋势并预测未来剩余字节数。完成后应同时检查当前剩余比例与预测结果,避免仅凭趋势外推触发容量告警。
前置条件
- Prometheus 已采集
node_filesystem_avail_bytes与node_filesystem_size_bytes;指标名适用于常见的 node_exporter 文件系统指标。 - 目标时间序列在观察窗口内有连续样本,并且剩余空间变化大致具有可外推趋势。
- 先排除不需要监控的临时、只读或伪文件系统,并根据实际环境调整标签过滤条件。
- 容量告警应保留直接的低剩余空间保护规则,不能让趋势预测成为唯一防线。
配置预测规则
下面示例使用过去 6 小时的剩余空间趋势预测 24 小时后是否小于 0,同时要求当前可用空间低于 10%,减少短期波动造成的无意义预测。配置文件属于片段示例,需要放入现有 Prometheus rule group 中。
- alert: FilesystemWillFillIn24Hours
  expr: |
    node_filesystem_avail_bytes{fstype!=""} / node_filesystem_size_bytes{fstype!=""} < 0.10
    and
    predict_linear(node_filesystem_avail_bytes{fstype!=""}[6h], 24 * 60 * 60) < 0
  for: 15m
  labels:
    severity: warning
  annotations:
    summary: "Filesystem is predicted to fill within 24 hours"
预期结果:对持续消耗空间、当前可用比例已低于 10%,且按最近 6 小时线性趋势推算 24 小时后可用字节数小于 0 的时间序列,条件持续 15 分钟后进入告警状态。实际实例、设备和挂载点标签取决于采集目标。
验证检查点
在 Prometheus 表达式浏览器中先单独执行预测表达式,确认目标文件系统确实得到预测值,再验证完整条件。也可使用 promtool 检查规则文件语法。
promtool check rules <PATH>预期输出:规则文件合法时会显示检查成功信息;具体文件名和输出路径随 <PATH> 实际值变化。若检查失败,应先修复 YAML 或 PromQL 错误,不要加载规则。
失败处理
如果容量基本稳定却频繁告警,检查 6 小时窗口内是否发生过批量删除、临时文件暴增或其他突变;线性回归会把这些变化纳入趋势。如果磁盘增长具有明显周期性或突发性,应扩大观察窗口、增加 for 持续时间,或改用更符合业务规律的容量规则。
回退方式
新规则噪声过大时,先停用该预测告警并恢复原有的固定剩余空间阈值规则;确认历史窗口和过滤条件合理后再重新启用。不要在验证预测规则时删除原有容量兜底告警。
延迟与饱和度告警
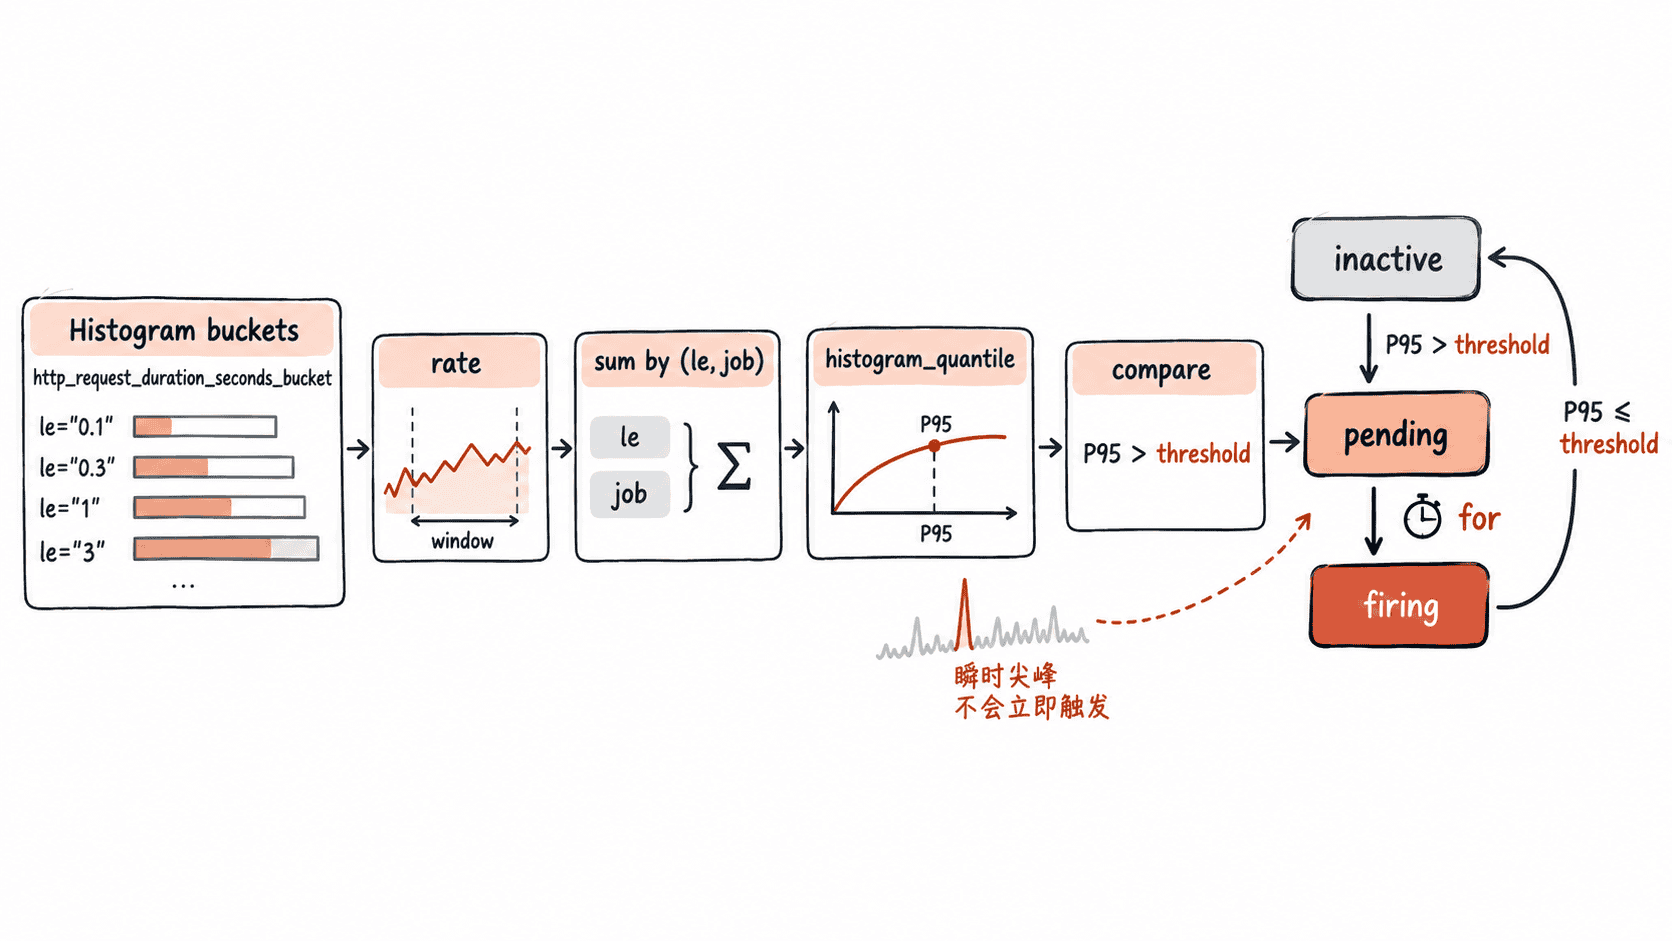
用 histogram_quantile 从直方图桶计算 P95、P99 等分位延迟,适合接口体验告警;经典直方图聚合时需保留 le 标签并先对桶执行 rate。
计算请求延迟分位数
当服务暴露经典 Prometheus Histogram,希望按最近一段时间的请求分布对 P95、P99 延迟告警时,可对 _bucket 计数器先计算 rate,再按 le 和需要保留的业务维度聚合,最后交给 histogram_quantile 估算分位数。
前置条件
- 应用已暴露经典 Histogram,并能查询到形如
<METRIC>_bucket的桶时间序列。 - 明确指标的时间单位;如果 Histogram 记录秒,则阈值也必须使用秒。
- 告警聚合维度已经确定,例如按
job、service或route分组;维度过细可能产生大量告警实例。 - 修改生产规则前保留当前规则,并先在 Prometheus 表达式浏览器验证查询结果。
配置 P95 告警
以下片段假设 http_request_duration_seconds 是经典 Histogram,以最近 5 分钟请求速率估算各 job 的 P95;le 必须保留到 histogram_quantile 的输入中。
- alert: HighRequestP95Latency
  expr: |
    histogram_quantile(
      0.95,
      sum by (job, le) (
        rate(http_request_duration_seconds_bucket[5m])
      )
    ) > 0.5
  for: 10m
  labels:
    severity: warning
  annotations:
    summary: "P95 request latency is above 500 ms"
预期结果:若某个 job 根据最近 5 分钟桶速率估算出的 P95 持续 10 分钟高于 0.5 秒,该告警进入 firing 状态。实际结果取决于 Histogram 的桶边界和请求分布,分位数是基于桶数据的估算值。
验证查询
先执行不带阈值比较的表达式,确认每个目标维度都能得到合理的分位延迟;随后用 promtool 检查规则文件。
promtool check rules <PATH>预期输出:规则文件语法和 PromQL 可被检查时会显示成功信息;若报告解析错误,应停止加载并按错误位置修正规则。<PATH> 替换为实际规则文件路径。
失败处理
查询为空时,先确认 _bucket 指标存在并在 [5m] 窗口内有样本。结果异常时检查 sum by 是否遗漏 le;经典 Histogram 在跨实例聚合后仍需保留该标签,才能让 histogram_quantile 识别桶上界。
如果 P95 在桶边界附近跳动明显,应检查 Histogram 桶设计。桶过稀会降低估算精度,而单纯缩短 rate 窗口可能进一步放大低流量服务的波动。
回退方式
新分位数告警出现大量噪声时,先恢复原有延迟规则并保留 Histogram 数据采集,再离线调整聚合维度、观察窗口、分位数或阈值。确认查询稳定后再重新启用规则,避免为了消除噪声直接停止延迟监控。
把延迟分位数与业务阈值组合,并配合 for 避免瞬时尖峰触发;阈值应结合接口等级与真实 SLO,而不是沿用通用固定数值。
检测高延迟持续发生
当接口延迟分位数持续超过业务允许范围时,用直方图计算 P95 或 P99,并通过 for 要求异常持续一段时间再触发。完成后应能区分短暂尖峰与持续延迟恶化,并从告警标签定位受影响的服务或路由。
前置条件
- 请求耗时必须以 Prometheus Histogram 暴露,例如
http_request_duration_seconds_bucket,且包含可用于聚合的服务、路由等标签。 - 阈值和持续时间应来自当前接口的 SLO、历史基线或容量测试,不应直接复制示例数值。
- 分位数依赖桶边界;如果目标阈值附近的桶过于稀疏,应先调整指标设计,否则估算精度可能不足。
配置规则
下面是片段示例,需放入 Prometheus 已加载的规则文件;0.5、5m 和标签集合仅用于展示结构,实际值应按业务确定。
groups:
  - name: latency-rules
    rules:
      - alert: HighRequestLatencyP95
        expr: |
          histogram_quantile(
            0.95,
            sum by (le, job) (
              rate(http_request_duration_seconds_bucket[5m])
            )
          ) > 0.5
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "P95 request latency is above the configured threshold"
生效行为:只有表达式连续满足 for: 5m 后告警才进入 firing;在此之前处于 pending。若规则表达式恢复为 false,持续时间会重新计算。
验证检查点
先用 promtool 检查规则文件语法,再让 Prometheus 重新加载规则;<PATH> 替换为实际规则文件路径。
promtool check rules <PATH>预期输出:规则合法时会显示检查成功;具体文件名和规则组数量随文件内容不同。
SUCCESS: <PATH>随后在 Prometheus 的规则或告警页面确认规则已加载,并直接执行 expr 中的 PromQL,检查结果单位是否为秒、聚合标签是否符合预期。测试期间可制造持续超过阈值的延迟,观察状态是否按 inactive → pending → firing 演进。
失败处理与恢复
如果 promtool 报错,应停止加载并先修正规则语法。若查询始终无数据,检查指标名、_bucket 时间序列以及 le 标签是否存在;若分位数异常,确认没有在调用 histogram_quantile 前错误丢弃 le。
告警过于敏感时,不要只盲目延长 for。先确认阈值是否符合当前 SLO、查询窗口是否合适,以及低流量接口的样本量是否足够。需要撤销本次规则时,恢复上一份已验证的规则文件并重新加载 Prometheus,再确认该告警规则已恢复到原配置。
直接监控活动请求、线程、队列或连接数等饱和度指标,适合发现容量接近上限的阶段性风险;应同时观察吞吐和错误率判断影响范围。
检测并发或队列堆积
当活动请求、线程、连接或队列持续接近容量边界时,可直接对饱和度指标设置告警,在延迟和错误率全面恶化前发现资源压力。完成后应能确认堆积是否持续,并结合吞吐与错误率判断它是正常流量增长还是处理能力不足。
前置条件
- 应用必须暴露能表示当前占用量的 Gauge 或等价指标,例如活动请求数、队列深度或已用连接数。
- 如果要按容量比例告警,还必须有可信的容量上限指标;上限来自动态配置时,应确保监控值与运行配置同步。
- 阈值必须根据服务容量、正常峰值和扩缩容策略确定,不能把示例阈值直接用于生产环境。
配置规则
下面以队列深度为例。片段需放入 Prometheus 已加载的规则文件,1000 和 10m 仅演示结构;真实环境应替换成经过验证的容量边界。
groups:
  - name: saturation-rules
    rules:
      - alert: QueueBacklogHigh
        expr: job_queue_depth > 1000
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "Queue backlog remains above the configured threshold"
生效行为:队列深度只有连续超过阈值达到 for 指定时长才会 firing。若系统只是短时吸收突发流量并迅速清空队列,不会形成持续告警。
验证检查点
先验证规则语法;<PATH> 替换为实际规则文件路径。
promtool check rules <PATH>预期输出:规则合法时检查成功,实际文件名随环境变化。
SUCCESS: <PATH>规则加载后,在 Prometheus 中查询 job_queue_depth,确认标签维度能够区分需要独立处置的服务或队列。测试告警时,应观察队列值持续超过阈值后从 pending 转为 firing,并同步查看请求吞吐、消费速率、错误率和延迟。
判断是否真正饱和
单看队列深度不能解释根因。队列持续增长且消费吞吐已经到达稳定上限,通常表示处理能力跟不上输入;队列增长同时错误率或延迟上升,则说明用户影响已经出现。若队列很高但正在稳定下降,应结合允许的排空时间判断是否仍需告警。
如果存在明确且可监控的容量上限,优先使用占用比例表达容量风险,例如“当前连接数 / 最大连接数”,这样比跨不同规格实例使用同一个绝对阈值更容易保持语义一致。
失败处理与恢复
查询无数据时先检查指标是否实际暴露、Prometheus 是否抓取成功以及标签筛选是否过严。告警频繁抖动时,应检查业务是否天然存在周期性积压,再决定调整阈值、查询窗口或 for,不要通过任意提高阈值隐藏真实饱和。
若新规则产生明显误报,恢复上一份已验证的规则文件并重新加载 Prometheus。恢复后确认规则配置已回退,同时继续保留原始饱和度指标,以便根据真实峰值重新制定阈值。
标签与告警粒度
使用聚合器按 service、job 等业务维度归并时间序列,让告警粒度贴近值班对象;不要在聚合时无意删除后续路由所需的实例或集群标签。
按服务标签聚合告警
当同一服务的多个实例会同时触发相同问题时,可先按 service、job 或集群等稳定维度聚合,再让告警规则判断聚合结果。完成后应得到与值班对象一致的告警实例,同时保留 Alertmanager 路由和定位故障所需的标签。
前置条件
- 指标中确实存在准备聚合的稳定标签,例如
service。 - 已确认哪些标签用于 Alertmanager 路由、静默或抑制,不能在聚合时误删。
- 已明确告警需要服务级还是实例级粒度;需要定位单实例故障时不要先聚合掉
instance。
配置步骤
先在 Prometheus 查询界面验证聚合表达式。下面以 HTTP 5xx 请求速率为例,按 service 汇总所有实例;指标名和标签需替换为实际环境中的定义。
sum by (service) (
  rate(http_requests_total{status=~"5.."}[5m])
)
预期结果:每个 service 只返回一条聚合后的时间序列;原有 instance 等未列入 by 的标签不会保留。具体数值取决于实际请求流量。
确认聚合粒度正确后,再把同一表达式用于告警规则,并设置业务阈值。以下为片段示例,需要放入现有 Prometheus rule group 中;阈值 1 仅用于展示结构,应按业务基线确定。
- alert: ServiceHigh5xxRate
  expr: sum by (service) (rate(http_requests_total{status=~"5.."}[5m])) > 1
  for: 5m
  labels:
    severity: warning
  annotations:
    summary: "Service {{ $labels.service }} has a high 5xx rate"
生效行为:条件持续满足 5 分钟后,每个匹配的 service 形成独立告警实例。保存规则前应使用 Prometheus 自带的规则检查工具验证配置文件。
promtool check rules <PATH>预期输出:规则合法时输出中包含 SUCCESS;<PATH> 为实际规则文件路径,具体附加信息可能随 Prometheus 版本不同。
验证检查点
加载规则后,在 Prometheus 的 Alerts 页面确认告警标签仍包含 service 以及路由真正依赖的静态标签。若原本期望按集群分别通知,却发现不同集群被合并为一条,应停止使用当前表达式并把 cluster 等必要维度加入聚合键。
失败处理与恢复
如果聚合后无法定位具体实例,可先用原始指标按 service 过滤,再查看 instance 维度,而不是立即扩大告警标签。如果 Alertmanager 路由因标签丢失而改变,应恢复上一版规则并重新设计聚合键;不要通过随意复制动态标签来补偿聚合造成的信息丢失。
限制 alerting rule 中由表达式产生的动态标签数量,避免用户 ID、请求 ID 等高基数值扩大告警实例数量;稳定维度应优先放在可控标签中。
避免高基数告警标签
当一条规则可能按用户 ID、请求 ID、URL 等大量动态值产生告警实例时,应先收敛标签维度,再启用告警。完成后应让一个真实故障对应有限、稳定的告警实例,避免通知、静默和 Alertmanager 聚合被大量唯一标签拆散。
前置条件
- 已明确值班人员实际需要按服务、集群、区域还是实例处理故障。
- 能在 Prometheus 中检查表达式返回的标签集合与序列数量。
- 修改生产规则前保留当前规则版本,以便新规则导致告警粒度异常时快速恢复。
检查动态维度
先运行告警条件使用的 PromQL,观察结果中是否携带 user_id、request_id 等几乎每次请求都可能变化的标签。下面用按服务统计错误请求速率的表达式展示收敛方式;指标名需与实际环境一致。
sum by (service) (
  rate(http_requests_total{status=~"5.."}[5m])
)
预期结果:结果仅按 service 区分时间序列,不会因为原始指标中的用户或请求级标签分别生成聚合结果;具体序列数量取决于实际存在的服务数量。
确认表达式维度后,再配置告警。不要把高基数动态值通过规则标签重新复制到最终告警中。
- alert: ServiceHighErrorRate
  expr: sum by (service) (rate(http_requests_total{status=~"5.."}[5m])) > 1
  for: 5m
  labels:
    severity: warning
  annotations:
    summary: "Service {{ $labels.service }} has a high error rate"
生效行为:条件持续满足 5 分钟后,告警实例主要随 service 变化,而不是随单次请求或用户变化。阈值 1 仅为结构示例,应使用实际业务基线。
验证检查点
保存前检查规则语法,并在加载后核对告警实例数量和标签集合。
promtool check rules <PATH>预期输出:规则文件合法时输出中包含 SUCCESS;<PATH> 替换为实际规则文件路径,附加输出可能因 Prometheus 版本不同而变化。
如果一个服务仍出现大量仅动态标签不同的告警,应停止继续扩大通知范围,回到 PromQL 检查分组键和最终告警标签。需要排查单个请求时,应通过日志、trace 或其他诊断数据关联,而不是让请求 ID 成为长期告警维度。
失败处理与回滚
若收敛标签后不同责任域被错误合并,应加入真正影响处置路径的稳定维度,例如 cluster 或 region,而不是恢复所有原始标签。如果新规则导致告警实例异常增加,先恢复上一版规则,再检查表达式输出标签和 Alertmanager 分组配置。