
消息队列 / 知识点
RabbitMQ 开发与排障手册
手册条目
配置客户端拓扑恢复和重连退避,避免断线后重复声明冲突。
启用连接自动恢复
用于 Java 客户端在已建立的连接因网络、节点重启或心跳超时而意外断开后,自动重连并恢复通道、交换机、队列、绑定和消费者。生产环境建议显式开启连接恢复与拓扑恢复,并配置有上限的退避,避免大量实例同时快速重连。RabbitMQ Java 客户端现代版本默认启用两项恢复,但显式配置更便于审计。:contentReference[oaicite:0]{index=0}
基本配置
下面示例只验证恢复开关和退避序列,不连接 Broker;项目需已引入 com.rabbitmq:amqp-client。真正创建连接时,同一个 ConnectionFactory 的配置会应用到 newConnection() 返回的连接。
import com.rabbitmq.client.ConnectionFactory;
import com.rabbitmq.client.RecoveryDelayHandler;

public class RecoveryConfigDemo {
    public static void main(String[] args) {
        ConnectionFactory factory = new ConnectionFactory();

        factory.setAutomaticRecoveryEnabled(true);
        factory.setTopologyRecoveryEnabled(true);

        // 有上限的退避:失败次数继续增加时保持 30 秒,避免重连风暴。
        RecoveryDelayHandler backoff = attempts -> {
            long[] delays = {2_000L, 5_000L, 10_000L, 30_000L};
            return delays[Math.min(attempts, delays.length - 1)];
        };
        factory.setRecoveryDelayHandler(backoff);

        System.out.printf(
            "automatic=%s topology=%s%n",
            factory.isAutomaticRecoveryEnabled(),
            factory.isTopologyRecoveryEnabled()
        );
        for (int attempts = 0; attempts < 5; attempts++) {
            System.out.printf(
                "attempts=%d delayMs=%d%n",
                attempts,
                backoff.getDelay(attempts)
            );
        }
    }
}
预期输出:
automatic=true topology=true
attempts=0 delayMs=2000
attempts=1 delayMs=5000
attempts=2 delayMs=10000
attempts=3 delayMs=30000
attempts=4 delayMs=30000
实际连接应在所有拓扑声明之前创建,并复用该连接及其通道;多节点环境可把地址列表或 AddressResolver 交给 newConnection,恢复时会重新选择可达节点。
恢复顺序
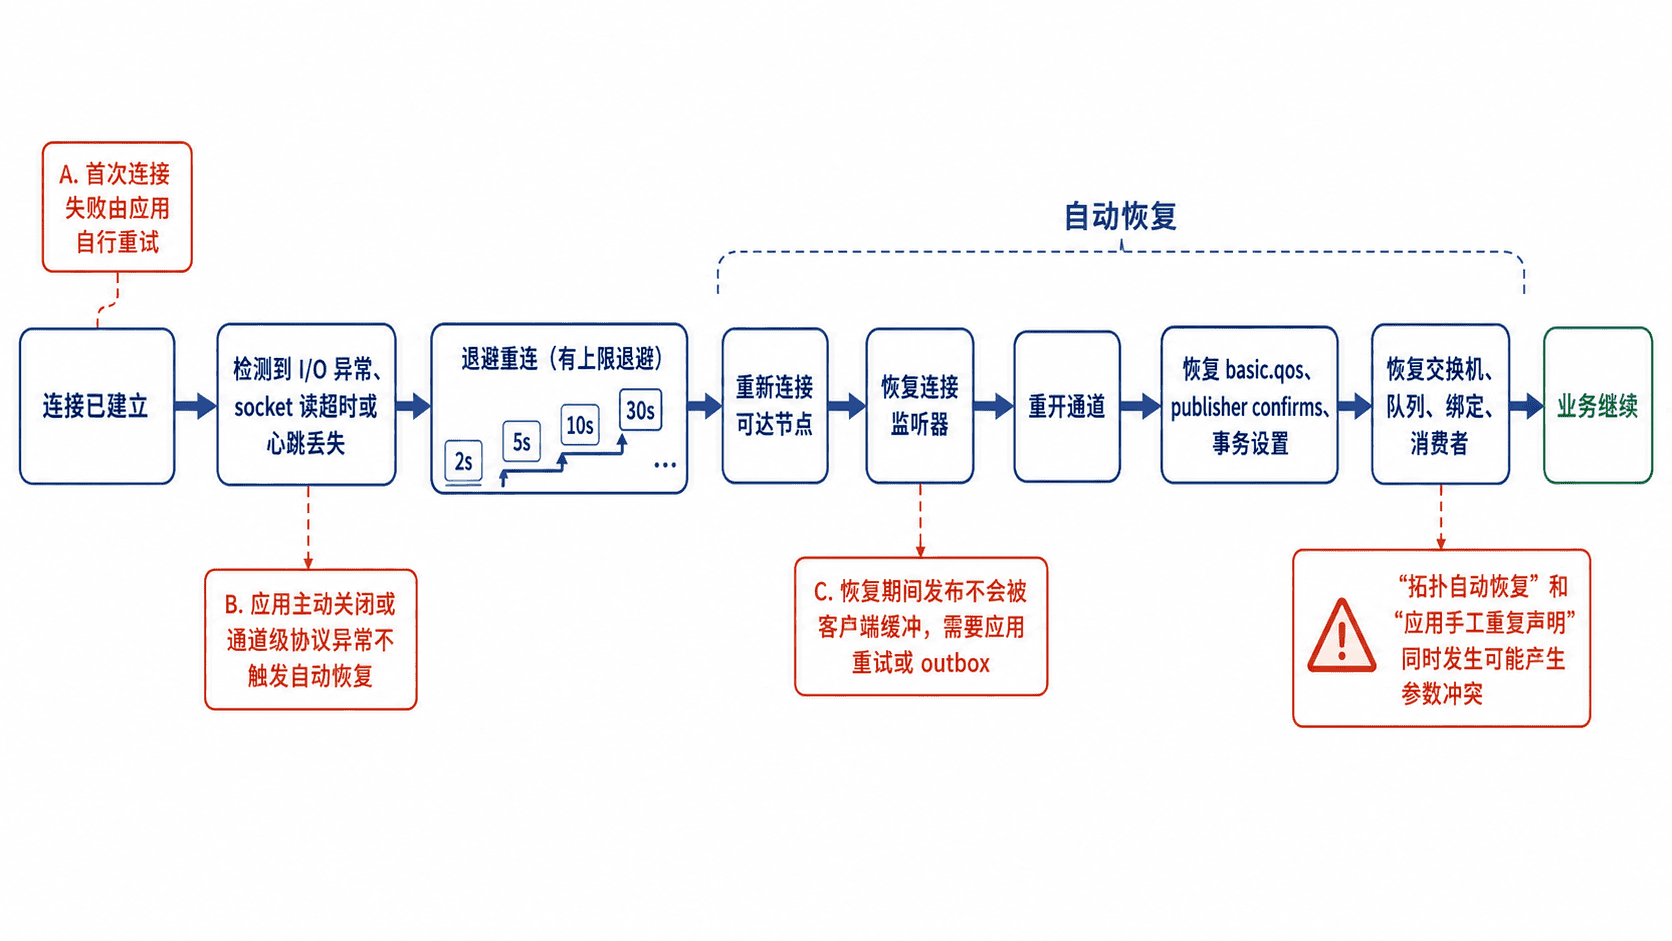
恢复通常按“重连、恢复监听器、重开通道、恢复通道设置、恢复拓扑和消费者”执行。检测到故障后默认延迟约 5 秒再尝试;也可通过 RecoveryDelayHandler 动态计算延迟,官方建议不要使用低于约 2 秒的重试间隔。:contentReference[oaicite:1]{index=1}
避免重复声明冲突
开启拓扑恢复后,不要再在恢复监听器中无条件重复声明同一批交换机、队列和绑定。若两条路径使用了不同的 durable、exclusive、autoDelete 或参数,Broker 会关闭通道并返回 PRECONDITION_FAILED,而通道级异常不会触发连接自动恢复。
安全方案二选一:让客户端拓扑恢复成为唯一恢复路径,所有声明参数保持稳定;或关闭 setTopologyRecoveryEnabled(false),由应用以单一入口、固定参数完整重建拓扑。声明过恢复对象的通道不应提前关闭,否则该通道关联的拓扑无法恢复。:contentReference[oaicite:2]{index=2}
风险与边界
自动恢复只处理“已成功建立后发生的意外断线”。首次连接失败、应用主动 close()、权限错误、队列参数不一致等语义或通道级错误,必须由应用修复或自行重试。
连接处于恢复状态时,客户端不会缓存待发布消息,发布可能抛出异常或在故障检测窗口内无法确认。不能接受丢消息时,应结合 publisher confirms、幂等消息 ID、有限重试或事务型 outbox;消费者必须允许消息重新投递。:contentReference[oaicite:3]{index=3}
排障清单
- 日志只有首次连接失败:检查启动阶段重试逻辑,自动恢复不会接管首次建连。
- 反复出现
PRECONDITION_FAILED:核对声明参数,并确认没有“拓扑恢复 + 手工恢复”双重声明。 - 重连后消费者未恢复:确认拓扑恢复已开启、声明通道未被关闭、消费者标签没有冲突。
- 断线期间消息缺失:检查 publisher confirms、未确认消息表和重发策略,不能依赖客户端自动缓存。
- 大量实例同时重连:把固定短间隔改为有上限退避,并在不同实例间加入少量随机抖动。
设置合理 heartbeat 以发现半开连接并避免网络设备误断。
配置心跳
心跳用于尽快发现半开连接、无响应节点和被中间网络设备视为“空闲”的长连接。Java 客户端通过 setRequestedHeartbeat 请求超时秒数;它是“判定对端失联的超时”,不是心跳包发送间隔。多数环境可从 10~20 秒开始验证,再结合网络抖动、JVM 停顿和代理空闲超时调整。:contentReference[oaicite:4]{index=4}
基本配置
下面示例把客户端请求值设为 15 秒,并显式开启自动恢复。心跳负责发现故障,自动恢复负责在连接关闭后重新建立连接,两者职责不同。
import com.rabbitmq.client.ConnectionFactory;

public class HeartbeatConfigDemo {
    public static void main(String[] args) {
        ConnectionFactory factory = new ConnectionFactory();

        factory.setRequestedHeartbeat(15);
        factory.setAutomaticRecoveryEnabled(true);

        System.out.printf(
            "requestedHeartbeat=%ds automaticRecovery=%s%n",
            factory.getRequestedHeartbeat(),
            factory.isAutomaticRecoveryEnabled()
        );
    }
}
预期输出:
requestedHeartbeat=15s automaticRecovery=true该值必须在 newConnection() 之前设置。实际生效值由客户端与服务端在建连时协商,不一定等于客户端请求值。
协商与检测
官方 Java 客户端的协商规则是:双方都非零时取较小值;任一方为零时取较大值,因此只有双方都为零才会关闭心跳。RabbitMQ 服务端通常建议 60 秒,客户端请求 15 秒时,协商结果为 15 秒。:contentReference[oaicite:5]{index=5}
| 服务端建议值 | 客户端请求值 | 协商结果 | 读取 |
|---|---|---|---|
| 60 | 15 | 15 | 客户端主动降低超时 |
| 10 | 30 | 10 | 客户端不能抬高非零服务端值 |
| 60 | 0 | 60 | 单边设 0 不会关闭心跳 |
| 0 | 0 | 0 | 心跳关闭,不推荐 |
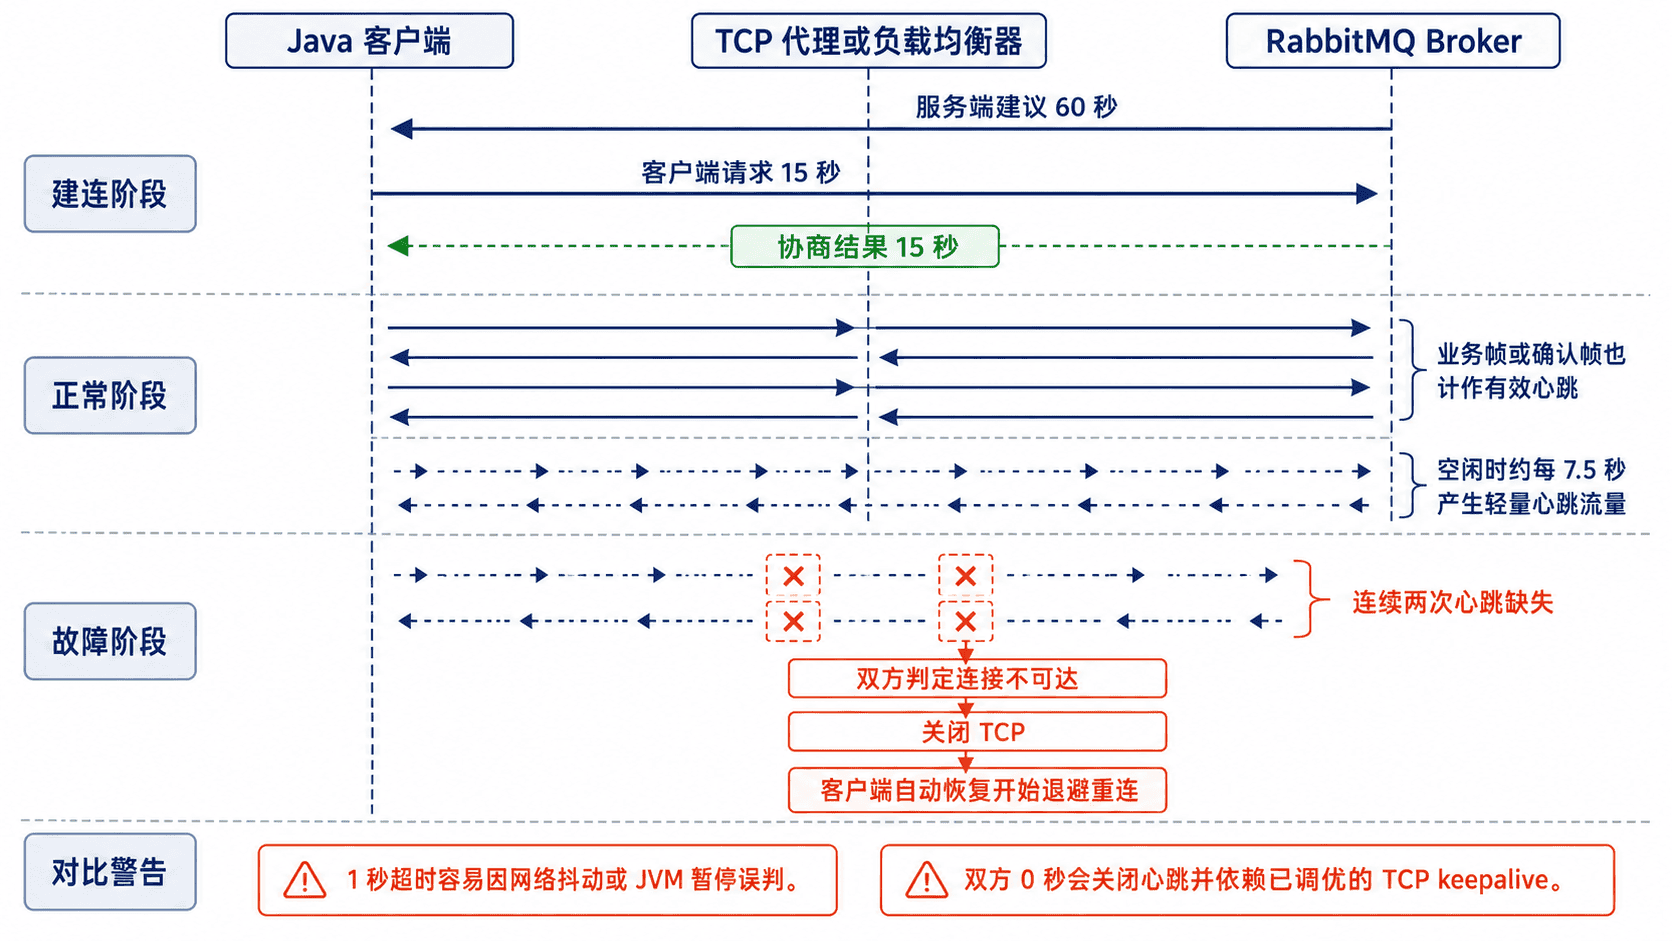
心跳帧大约每“协商超时的一半”发送一次;连续错过两次后通常判定对端不可达并关闭连接。发布、确认和其他协议流量同样可计作有效心跳,因此繁忙连接不一定持续发送独立心跳帧。:contentReference[oaicite:6]{index=6}
验证生效值
在客户端连接已经建立后,从 Broker 查看协商后的 timeout。timeout 字段表示连接的协商心跳秒数,state 正常应为 running。
rabbitmqctl -q list_connections name peer_host timeout state预期输出:
name	peer_host	timeout	state
<CONNECTION_NAME>	<CLIENT_IP>	15	running
连接名称、客户端 IP 和排列可能不同;重点读取 timeout=15 与 state=running。若请求 15 秒却看到更小值,通常是服务端配置更低;若看到 60 秒,检查客户端设置是否在创建连接前执行。:contentReference[oaicite:7]{index=7}
风险与边界
把超时设得过低会在短时拥塞、Broker 流控、JVM Stop-The-World 或网络抖动时误判断线,导致重连风暴和消费者抖动。官方经验值认为低于 5 秒容易出现误报,5~20 秒通常更稳妥;安全替代是先从 10~20 秒压测,并观察 missed heartbeat 日志。
双方都设为 0 会关闭心跳,半开连接可能长期不被发现,发布者尤其容易在故障窗口内误以为消息已发送。只有当客户端和 Broker 所在主机都启用了经过验证的低超时 TCP keepalive 时才考虑关闭心跳;通常保留心跳并把 TCP keepalive 作为第二道防线。:contentReference[oaicite:8]{index=8}
超时过高也可能让代理或负载均衡器先按空闲策略切断连接。应保证心跳产生的周期流量明显短于中间设备的 idle timeout,例如协商超时 30 秒时通常约每 15 秒有一次活动。
排障清单
- Broker 与客户端日志出现 missed heartbeats:检查网络丢包、CPU 饱和、JVM 长暂停和 Broker 流控,不要只增大超时掩盖根因。
- 连接固定在代理空闲阈值附近断开:缩短心跳超时,或调整代理 idle timeout。
timeout与配置不一致:确认读取的是协商值,并核对服务端与客户端的非零最小值规则。- 半开连接迟迟不释放:确认心跳没有被双方同时设为 0,并检查 TCP keepalive 是否真正生效。
- 心跳触发断线后没有重连:检查客户端自动恢复是否开启;心跳只负责检测,不负责重连。
根据分区能力、处理耗时和顺序要求确定消费者实例与线程数。
设置消费者并发
用于在不压垮下游的前提下,提高 RabbitMQ 消费吞吐。先按处理槽位确定消费者总数,再用 prefetch 限制每个消费者尚未确认的消息数;不要把线程数直接等同于吞吐量。
并发模型
消费者总并发通常等于“实例数 × 每实例消费者数”。对单个普通队列增加竞争消费者可以并行处理,但同一条消息只会交给其中一个消费者;RabbitMQ 的 prefetch_count 默认按每个新消费者分别生效。:contentReference[oaicite:0]{index=0}
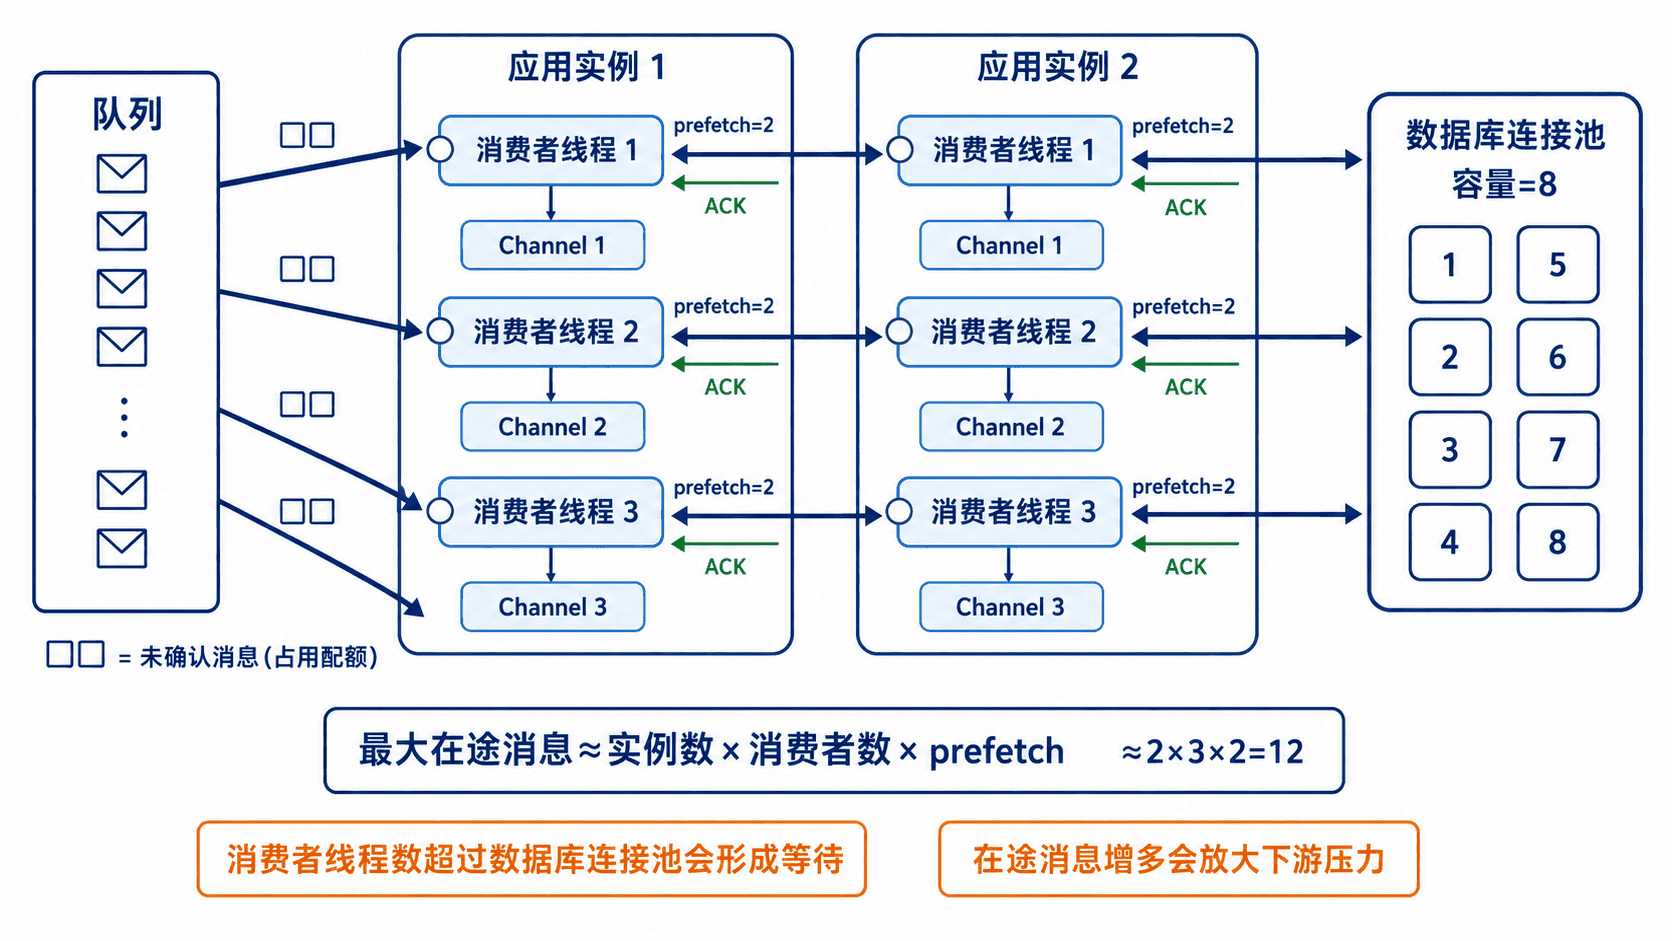
估算起点可用“峰值到达率 × P95 单条处理耗时”计算所需处理槽位,再结合 CPU 核数、数据库连接池、外部接口限流和顺序要求取较小值。I/O 等待型任务可逐步增加并发;CPU 密集型任务应优先增加进程或实例,而不是无限加线程。
可运行示例
下面创建 3 个消费者线程。每个线程在自身线程中建立独立连接和 Channel,并设置 prefetch=1;这避免跨线程共享 Channel。RabbitMQ Java 客户端和 Pika 文档都建议不要在多个线程间并发操作同一个 Channel 或 BlockingConnection。:contentReference[oaicite:1]{index=1}
import os
import threading
import time

import pika

AMQP_URL = os.getenv("AMQP_URL", "amqp://guest:guest@localhost:5672/%2F")
QUEUE = "demo.concurrent"
WORKERS = int(os.getenv("WORKERS", "3"))
PREFETCH = int(os.getenv("PREFETCH", "1"))
TOTAL = 6

ready = threading.Barrier(WORKERS + 1)
done = threading.Event()
lock = threading.Lock()
processed = 0
connections = []

def worker(worker_id: int) -> None:
    global processed
    connection = pika.BlockingConnection(pika.URLParameters(AMQP_URL))
    channel = connection.channel()
    channel.queue_declare(queue=QUEUE, durable=False, auto_delete=False)
    channel.basic_qos(prefetch_count=PREFETCH)

    def on_message(ch, method, properties, body) -> None:
        global processed
        time.sleep(0.2)  # 模拟 I/O 处理;成功后再确认
        print(f"worker-{worker_id} handled {body.decode()}", flush=True)
        ch.basic_ack(delivery_tag=method.delivery_tag)
        with lock:
            processed += 1
            if processed == TOTAL:
                done.set()

    channel.basic_consume(queue=QUEUE, on_message_callback=on_message)
    with lock:
        connections.append((connection, channel))
    ready.wait()
    channel.start_consuming()
    connection.close()

threads = [
    threading.Thread(target=worker, args=(i,), daemon=True)
    for i in range(1, WORKERS + 1)
]
for thread in threads:
    thread.start()

ready.wait()
publisher = pika.BlockingConnection(pika.URLParameters(AMQP_URL))
channel = publisher.channel()
channel.queue_declare(queue=QUEUE, durable=False, auto_delete=False)
channel.queue_purge(queue=QUEUE)
for index in range(1, TOTAL + 1):
    channel.basic_publish(exchange="", routing_key=QUEUE, body=f"task-{index}")
publisher.close()

done.wait(timeout=10)
with lock:
    for connection, channel in connections:
        connection.add_callback_threadsafe(channel.stop_consuming)
for thread in threads:
    thread.join(timeout=5)
运行:
WORKERS=3 PREFETCH=1 python consumer_concurrency.py预期输出示例:
worker-1 handled task-1
worker-2 handled task-2
worker-3 handled task-3
worker-1 handled task-4
worker-2 handled task-5
worker-3 handled task-6
消费者编号和行序可能不同;应读取为 6 条任务各处理一次,且多个 worker 同时工作。
调参顺序
- 先固定
prefetch=1,逐步增加消费者数,观察吞吐、处理延迟和下游资源占用。 - 消费者已能持续忙碌且下游有余量时,再小步提高
prefetch,避免网络往返成为瓶颈。 - 当数据库连接池等待、HTTP 429、CPU 饱和或
messages_unacknowledged持续上升时停止扩容并回退。 - 严格顺序队列不要增加竞争消费者;改用按业务键分片后,每个分片单消费者。
验证与排障
rabbitmqctl list_queues name consumers messages_ready messages_unacknowledged预期输出示例:
name             consumers  messages_ready  messages_unacknowledged
demo.concurrent  0          0               0
示例程序退出后 consumers 为 0;实际服务运行期间应接近期望并发。messages_ready 持续增长表示消费能力不足;messages_unacknowledged 长期高位通常表示处理慢、确认未执行或 prefetch 过大。手动确认配合有界预取可限制正在处理的交付数量。:contentReference[oaicite:2]{index=2}
风险与边界
并发超过数据库连接池或外部接口限额时,会把队列等待转移为应用内阻塞、超时和重试风暴;安全替代是让消费者总数不超过可用下游槽位,并通过压测逐级放量。prefetch 过大时,单个消费者会占有大量未确认消息,故障后可能集中重投;安全替代是从 1 或小批量开始,根据单条耗时和内存上限调整。跨线程共享 Channel 可能造成帧交错、重复确认等协议问题;安全替代是每线程独立 Channel,或把确认操作调度回连接所属线程。:contentReference[oaicite:3]{index=3}
明确单队列、多消费者、重试和重新入队对顺序的影响。
保证消息顺序
用于判断 RabbitMQ 的“队列 FIFO”能否转化为业务看到的严格顺序。严格顺序不仅取决于入队顺序,还取决于消费者数量、预取、处理方式、确认时机和失败重试路径。
顺序边界
普通队列通常按入队顺序交付,但竞争消费者、预取、优先级、拒绝后重新入队和重新投递都会改变单个消费者观察到的顺序或业务完成顺序。多消费者同优先级时通常轮询分发;消息重新入队时会尽量回到原位置,无法做到时可能靠近队头。:contentReference[oaicite:4]{index=4}
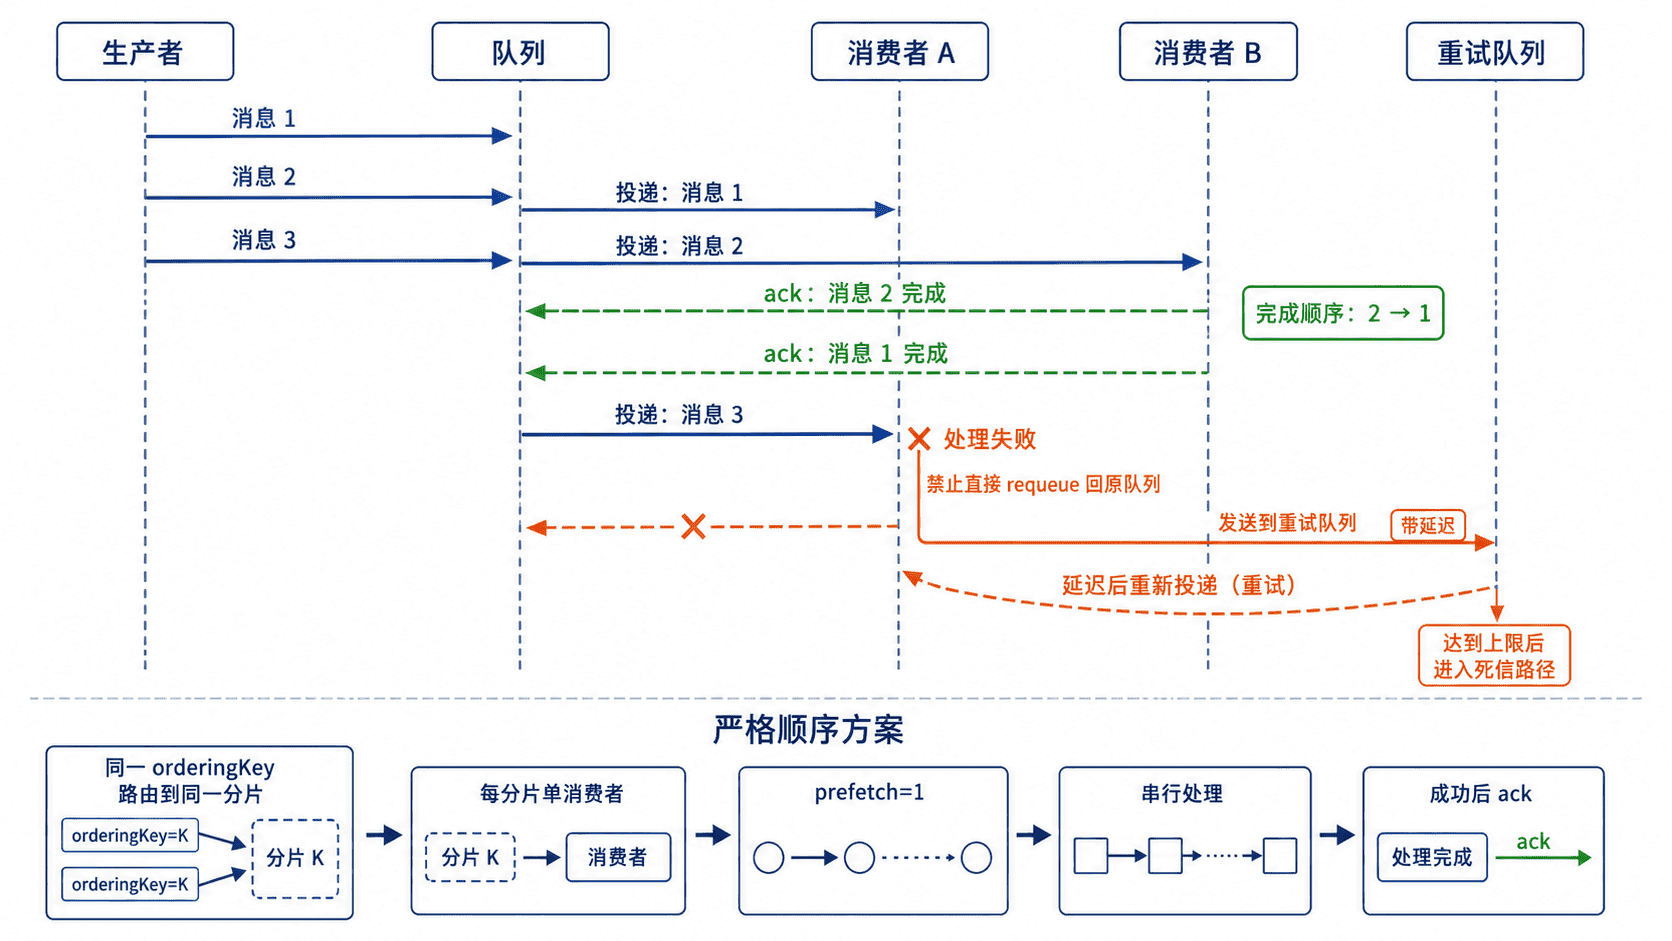
需要全局严格顺序时,使用单队列、单活跃消费者、prefetch=1、串行处理,并在业务成功后再确认。需要吞吐且只要求同一业务键有序时,把相同 orderingKey 稳定路由到同一队列或分区,每个分片保持单消费者;不同键之间允许并行。
可运行示例
下面在临时队列中依次发布 3 条消息,再用单消费者、prefetch=1 和手动确认串行消费。该示例验证的是单发布通道、单队列、无重试条件下的交付顺序,不代表多发布者或失败重投时仍然全局有序。
import os

import pika

AMQP_URL = os.getenv("AMQP_URL", "amqp://guest:guest@localhost:5672/%2F")
connection = pika.BlockingConnection(pika.URLParameters(AMQP_URL))
channel = connection.channel()

result = channel.queue_declare(queue="", exclusive=True, auto_delete=True)
queue_name = result.method.queue
channel.basic_qos(prefetch_count=1)

for sequence in (1, 2, 3):
    channel.basic_publish(
        exchange="",
        routing_key=queue_name,
        body=f"order-42#{sequence}",
    )

received = 0

def on_message(ch, method, properties, body) -> None:
    global received
    print(body.decode(), flush=True)
    ch.basic_ack(delivery_tag=method.delivery_tag)  # 业务成功后确认
    received += 1
    if received == 3:
        ch.stop_consuming()

channel.basic_consume(
    queue=queue_name,
    on_message_callback=on_message,
    auto_ack=False,
)
channel.start_consuming()
connection.close()
运行:
python ordered_consumer.py预期输出:
order-42#1
order-42#2
order-42#3
若增加第二个消费者、在回调内把消息提交到线程池并提前确认,或失败后直接 nack(requeue=true),业务完成顺序就可能与此输出不同。RabbitMQ 的单消费者模型最容易保持 FIFO;重新投递和其他订阅者会削弱消费者观察到的顺序。:contentReference[oaicite:5]{index=5}
可靠的有序方案
- 生产者为每条消息写入
orderingKey、单调递增的sequence和业务幂等键。 - 使用一致的哈希规则把同一
orderingKey路由到固定队列或流分区,扩缩容时避免随意改变分片数。 - 每个分片只允许一个实际处理槽位,设置
prefetch=1,完成事务后再ack。 - 消费端保存最后成功序号;发现重复则幂等返回,发现跳号则暂停该键并告警,不要继续提交后续状态。
- 失败消息进入独立重试队列或延迟链路,达到上限后进入死信队列;不要在原队列无限重新入队。
常见破坏点
多消费者会让消息按交付顺序分散到不同处理器,处理耗时差异会造成完成顺序倒置。prefetch>1 本身不一定改变交付顺序,但应用若并行处理同一消费者拿到的多条消息,仍会乱序。优先级队列会按优先级而非纯 FIFO 交付;多个发布连接或 Channel 同时写入时,也不应假设存在跨通道的全局先后关系。:contentReference[oaicite:6]{index=6}
风险与边界
单消费者和 prefetch=1 会限制单分片吞吐,消息处理变慢时整个分片都会阻塞;安全替代是按业务键分片,而不是给同一键增加竞争消费者。处理完成但确认前连接中断时,消息可能重新投递,顺序方案仍必须配合幂等;安全替代是业务事务记录幂等键与序号,再执行确认。直接重新入队可能形成紧密重投循环并挤占正常消息;安全替代是有限次数、带退避的独立重试队列,最终转入死信队列。:contentReference[oaicite:7]{index=7}
使用业务唯一键、去重表或状态机处理重复投递。
实现幂等消费
用于处理 RabbitMQ 重复投递:同一业务事件无论被消费一次还是多次,都只产生一次业务结果。关键不是“禁止重投”,而是用稳定业务唯一键去重,并把去重记录与业务更新放进同一个数据库事务,事务提交后再发送 ACK。
核心规则
不要使用 delivery_tag 作为幂等键,它只在当前 Channel 内有效,重投后可能变化。优先使用生产者生成的 message_id、事件 ID 或订单号,并保证同一业务事件重试时该值不变。
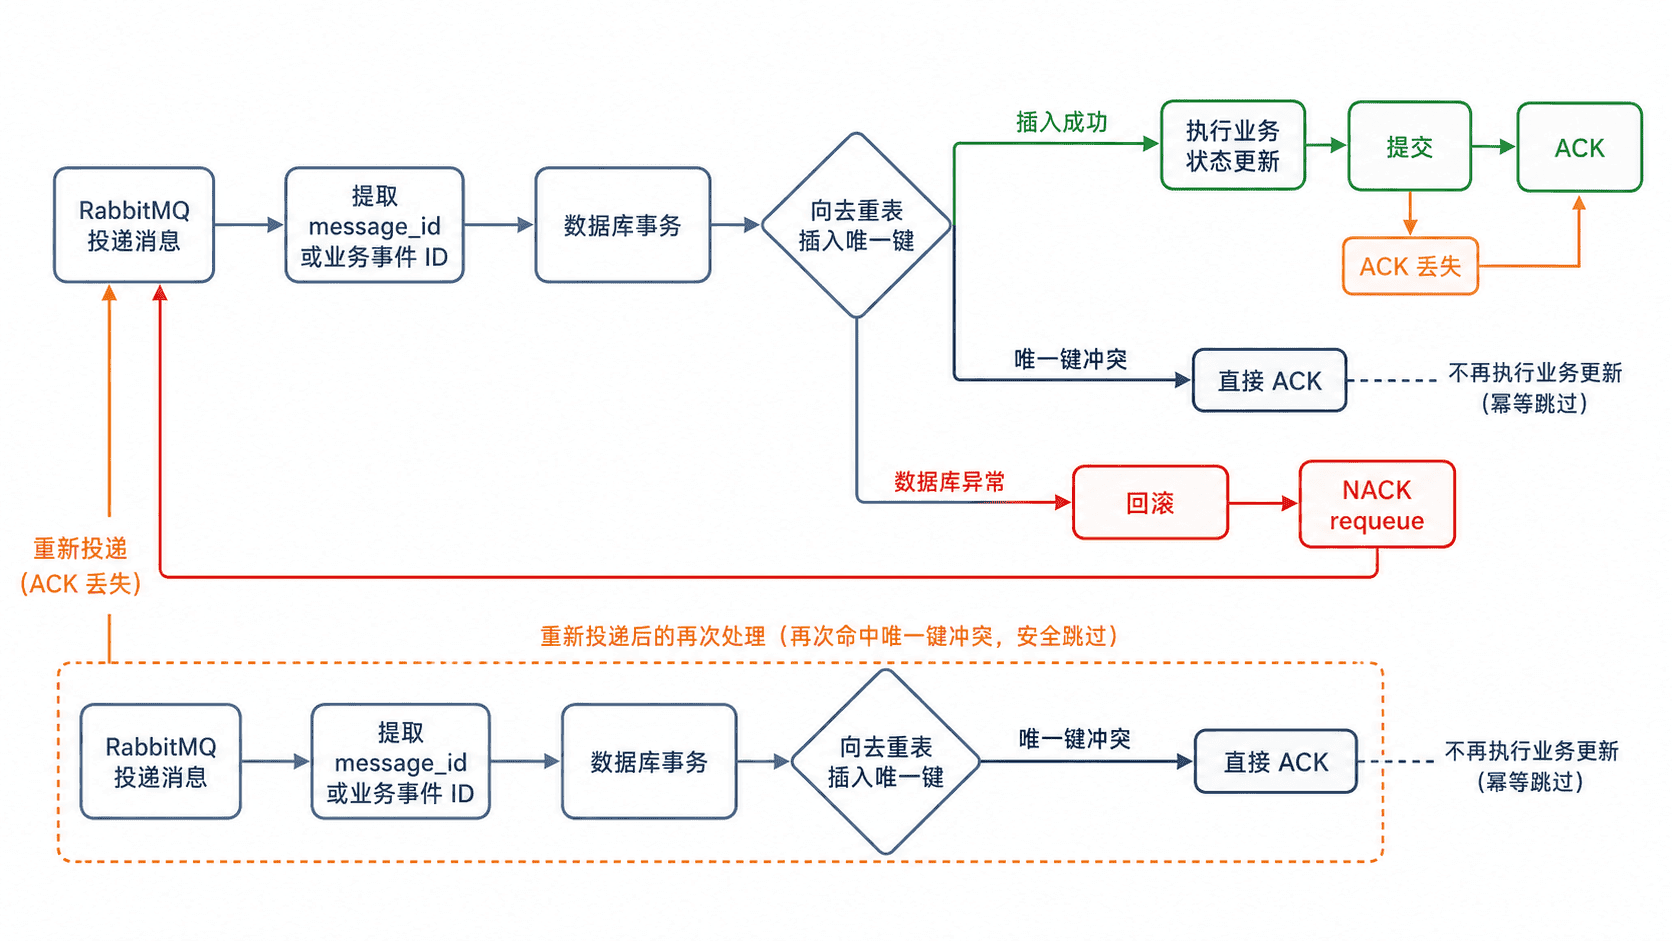
可运行示例
下面的 Python 程序同时提供 consume 和 publish 两种模式。SQLite 中 consumed_event.event_id 是唯一键;插入成功后才更新订单投影,提交完成后才 ACK。示例依赖可访问的 RabbitMQ 和已安装的 pika。
import argparse
import json
import os
import sqlite3

import pika

QUEUE = "orders.idempotent"
DB_PATH = "consumer.db"

def connect() -> pika.BlockingConnection:
    credentials = pika.PlainCredentials(
        os.getenv("RABBITMQ_USER", "guest"),
        os.getenv("RABBITMQ_PASSWORD", "guest"),
    )
    return pika.BlockingConnection(
        pika.ConnectionParameters(
            host=os.getenv("RABBITMQ_HOST", "localhost"),
            port=int(os.getenv("RABBITMQ_PORT", "5672")),
            virtual_host=os.getenv("RABBITMQ_VHOST", "/"),
            credentials=credentials,
        )
    )

def init_db() -> None:
    with sqlite3.connect(DB_PATH) as db:
        db.execute(
            "CREATE TABLE IF NOT EXISTS consumed_event ("
            "event_id TEXT PRIMARY KEY, consumed_at TEXT DEFAULT CURRENT_TIMESTAMP)"
        )
        db.execute(
            "CREATE TABLE IF NOT EXISTS order_projection ("
            "order_id TEXT PRIMARY KEY, status TEXT NOT NULL)"
        )

def publish_duplicate() -> None:
    event = {"event_id": "evt-1001", "order_id": "order-42", "status": "PAID"}
    connection = connect()
    channel = connection.channel()
    channel.queue_declare(queue=QUEUE, durable=True)

    # 两次发布使用同一个事件 ID,模拟生产者重试或 ACK 丢失后的重复投递。
    for _ in range(2):
        channel.basic_publish(
            exchange="",
            routing_key=QUEUE,
            body=json.dumps(event).encode(),
            properties=pika.BasicProperties(
                message_id=event["event_id"],
                delivery_mode=2,
                content_type="application/json",
            ),
        )
    connection.close()
    print("published event_id=evt-1001 count=2")

def consume() -> None:
    connection = connect()
    channel = connection.channel()
    channel.queue_declare(queue=QUEUE, durable=True)
    channel.basic_qos(prefetch_count=20)

    def on_message(ch, method, properties, body) -> None:
        try:
            payload = json.loads(body)
            event_id = properties.message_id or payload["event_id"]
            order_id = payload["order_id"]
            status = payload["status"]
        except (json.JSONDecodeError, KeyError, UnicodeDecodeError):
            ch.basic_reject(method.delivery_tag, requeue=False)
            print("rejected invalid message")
            return

        db = sqlite3.connect(DB_PATH)
        try:
            db.execute("BEGIN IMMEDIATE")
            inserted = db.execute(
                "INSERT OR IGNORE INTO consumed_event(event_id) VALUES (?)",
                (event_id,),
            ).rowcount

            if inserted == 0:
                db.rollback()
                ch.basic_ack(method.delivery_tag)
                print(f"duplicate skipped event_id={event_id}")
                return

            # 去重记录与业务状态更新必须位于同一事务,避免只写入其中一项。
            db.execute(
                "INSERT INTO order_projection(order_id, status) VALUES (?, ?) "
                "ON CONFLICT(order_id) DO UPDATE SET status=excluded.status",
                (order_id, status),
            )
            db.commit()
        except sqlite3.Error as exc:
            db.rollback()
            ch.basic_nack(method.delivery_tag, requeue=True)
            print(f"retry database_error={exc}")
            return
        finally:
            db.close()

        ch.basic_ack(method.delivery_tag)
        print(f"processed event_id={event_id} order_id={order_id}")

    channel.basic_consume(queue=QUEUE, on_message_callback=on_message, auto_ack=False)
    print("waiting for messages")
    channel.start_consuming()

if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("mode", choices=["consume", "publish"])
    args = parser.parse_args()

    init_db()
    consume() if args.mode == "consume" else publish_duplicate()
先在终端 A 启动消费者,再在终端 B 发布两次相同事件:
python idempotent_consumer.py consume
# 另一个终端执行
python idempotent_consumer.py publish
预期输出
# 终端 A
waiting for messages
processed event_id=evt-1001 order_id=order-42
duplicate skipped event_id=evt-1001

# 终端 B
published event_id=evt-1001 count=2读取方法:processed 只出现一次,第二条相同事件显示 duplicate skipped。进程重启后去重表仍保留,因此重复事件仍不会再次修改业务状态。
风险与边界
当去重记录与业务更新不在同一事务时,进程可能在两次写入之间崩溃,造成“已去重但业务未完成”或“业务已完成但未去重”。安全替代是同库事务;跨库或外部接口场景使用事务消息、Outbox、状态机或可重复查询的业务接口。
如果业务事务已提交但 ACK 发送失败,RabbitMQ 会再次投递;这是幂等方案必须覆盖的正常路径。不要在事务提交前 ACK,否则消费者崩溃会导致消息丢失。无效消息使用 requeue=False 前,应先配置死信交换机,否则消息会被直接丢弃。
幂等键粒度必须对应“一个不可重复的业务动作”。直接用订单号会阻止同一订单的不同事件;更安全的键通常是 event_id,或由“业务对象 ID + 事件类型 + 版本”组成的稳定键。
排障清单
- 重复仍生效:确认重试消息是否保留同一
message_id,以及数据库唯一约束是否真正存在。 - 消息反复重投:检查数据库异常、事务锁等待和 ACK 是否在提交之后执行。
- 合法后续事件被跳过:检查幂等键是否过粗,是否把多个不同业务动作映射成同一个键。
- 去重表持续膨胀:按业务最长重投窗口归档历史记录,但不要在消息仍可能重投时提前删除。
为单条消息或队列统一设置过期时间。
设置消息 TTL
用于让消息在指定时间后失效。单条消息 TTL 适合不同消息拥有不同截止时间;队列 TTL 适合同一队列统一过期。两者同时存在时,实际有效期取更小值,单位都是毫秒。
选择方式
| 方式 | 配置位置 | 适用场景 | 关键限制 |
|---|---|---|---|
| 单条消息 TTL | AMQP 属性 expiration |
每条消息截止时间不同 | 值必须是十进制毫秒字符串 |
| 队列消息 TTL | 队列参数 x-message-ttl |
队列内消息统一过期 | 已存在队列不能用不同参数直接重声明 |
| 策略 TTL | Policy 的 message-ttl |
需要在线调整一批队列 | 需要管理权限并确认匹配范围 |
x-expires 控制的是“队列多久未使用后被删除”,不是消息 TTL,不能互相替代。
可运行示例
示例创建一个独占临时队列,队列 TTL 为 5000 毫秒;第一条消息另设 2000 毫秒 TTL,因此 3 秒后不可获取。第二条消息没有单条 TTL,3 秒后仍处于队列 TTL 范围内,可以正常读取。
import os
import time

import pika

credentials = pika.PlainCredentials(
    os.getenv("RABBITMQ_USER", "guest"),
    os.getenv("RABBITMQ_PASSWORD", "guest"),
)
connection = pika.BlockingConnection(
    pika.ConnectionParameters(
        host=os.getenv("RABBITMQ_HOST", "localhost"),
        port=int(os.getenv("RABBITMQ_PORT", "5672")),
        virtual_host=os.getenv("RABBITMQ_VHOST", "/"),
        credentials=credentials,
    )
)
channel = connection.channel()

result = channel.queue_declare(
    queue="",
    exclusive=True,
    arguments={"x-message-ttl": 5000},
)
queue_name = result.method.queue

# 单条 TTL 只能使用毫秒字符串;实际 TTL 为 min(5000, 2000)。
channel.basic_publish(
    exchange="",
    routing_key=queue_name,
    body=b"per-message-expires-first",
    properties=pika.BasicProperties(expiration="2000"),
)
time.sleep(3)
method, _, body = channel.basic_get(queue=queue_name, auto_ack=True)
print("effective_ttl_test=expired" if method is None else body.decode())

# 未设置 expiration 时只受队列 TTL 控制,3 秒仍小于 5 秒。
channel.basic_publish(
    exchange="",
    routing_key=queue_name,
    body=b"queue-ttl-still-valid",
)
time.sleep(3)
method, _, body = channel.basic_get(queue=queue_name, auto_ack=True)
print(
    f"queue_ttl_test=available body={body.decode()}"
    if method is not None
    else "queue_ttl_test=expired"
)

connection.close()
运行命令
python ttl_demo.py预期输出
effective_ttl_test=expired
queue_ttl_test=available body=queue-ttl-still-valid
读取方法:第一行证明单条 TTL 比队列 TTL 更短时优先生效;第二行证明未设置单条 TTL 的消息仍按队列 TTL 计算。实际队列名由 RabbitMQ 动态生成,不影响结果。
生效与验证
消息过期后不会再投递给消费者。配置死信交换机时,过期消息会进入死信路由,并在 x-death 头中出现 reason=expired;未配置死信交换机时,过期消息会被丢弃。
生产队列可通过队列参数固定 TTL,也可通过 Policy 设置 message-ttl。需要调整已有队列时优先使用 Policy;硬编码 x-message-ttl 的队列若以不同值重新声明,会触发 PRECONDITION_FAILED 并关闭当前 Channel。
风险与边界
TTL 只约束仍在队列中的消息。消息已经投递给消费者并处于未确认状态时,TTL 不会中止处理;需要额外校验业务截止时间,并为消费者设置超时或取消机制。
把 60 误当成 60 秒会导致消息仅保留 60 毫秒。安全做法是统一使用明确的毫秒常量,例如 60_000,并在发布前记录最终 TTL。单条消息的 expiration 必须传字符串,传整数可能被客户端拒绝或编码错误。
TTL 不等于精确定时调度。积压、队列类型和服务器扫描时机会影响物理删除与磁盘回收时间;需要“某时刻准时执行”时,应使用专门的延迟队列、调度服务或带截止时间校验的消费者。
排障清单
- 消息立即消失:检查是否把秒当成毫秒,或 Policy 与单条 TTL 中存在更小值。
- 消息未进入死信队列:确认源队列配置了死信交换机、路由键和目标绑定。
- 重声明队列报
PRECONDITION_FAILED:现有队列参数与代码不一致,改用 Policy 或在确认无数据后重建队列。 - 消费者仍处理“过期业务”:消息可能在过期前已投递,消费代码必须再次校验业务截止时间。
让长期无消费者或无使用的临时队列自动删除。
设置队列过期
队列过期用于清理长期无人消费、无人轮询且不再声明的临时队列。它删除的是整个队列,不是单条消息;生产环境优先用策略配置,便于按名称批量生效和在线调整。
命令定位
expires 表示队列连续“未使用”的毫秒数,必须是正整数。策略只作用于指定 vhost,正则应锚定稳定前缀或完整队列名,避免误匹配业务持久队列。
基本语法
下面让 app-vhost 中以 tmp. 开头的队列连续 30 分钟未使用后自动删除,并检查策略是否命中。
rabbitmqctl set_policy -p app-vhost \
  --apply-to queues \
  queue-expiry '^tmp\.' \
  '{"expires":1800000}'

rabbitmqctl list_queues -p app-vhost \
  name type policy consumers messages_ready \
  --silent
预期输出(队列名和计数会随环境变化):
name            type     policy        consumers  messages_ready
tmp.session.42  classic  queue-expiry  0          0
policy 为 queue-expiry 只表示策略已命中,不代表队列已开始等待删除。
未使用判定
计时期间必须同时没有在线消费者、没有执行 basic.get,并且客户端没有重新声明该队列。重新声明或 basic.get 会续期,因此仅看到 consumers=0,不能断定队列会按时删除。
Broker 保证队列至少未使用满指定时长后才会删除,但不保证在到期毫秒立即完成。验证时应留出清理调度余量,再执行 rabbitmqctl list_queues -p app-vhost name policy consumers 检查队列是否消失。
高频用法
精确匹配单个队列使用 ^tmp\.session\.42$;批量匹配临时回复队列使用稳定前缀,如 ^reply\.。不要直接在生产 vhost 使用 .*,除非所有队列都允许自动删除。
应用也可在声明时设置 x-expires,但该值固化在声明参数中,修改通常需要协调应用和队列重建。需要运维在线调整时使用策略;连接专属临时队列可结合 exclusive 或 auto-delete。
风险与边界
队列到期时,尚未消费的消息会随队列一起删除,而且队列整体过期不会把这些消息送入 DLX。需要保留或补偿消息时,应改用消息 TTL 配合 DLX,或先停止发布、排空并核对积压后再启用队列过期。
过宽正则或过短 TTL 会误删仍有价值的队列。先导出候选名称,在测试 vhost 验证正则,再从较长时长灰度;流队列不支持队列过期,该功能更常用于临时 classic 队列。
排障清单
- 队列一直不删:检查消费者、轮询式
basic.get、健康检查和应用重连是否持续续期。 - 策略未命中:核对 vhost、队列名正则、策略优先级以及
policy、effective_policy_definition。 - 客户端报
PRECONDITION_FAILED:检查同名队列是否被不同x-expires参数重新声明。 - 删除晚于预期:确认已完整空闲超过 TTL,并把它视为后台清理机制,而不是精确定时器。
使用 max-length 或 max-length-bytes 控制积压上限和溢出行为。
限制队列长度
队列长度限制用于给积压设置硬上限,避免单个队列无限占用资源。可按就绪消息数、消息体总字节数或两者同时限制;两种限制并存时,先达到的上限立即触发溢出行为。
基本语法
下面把 orders.retry 限制为最多 100000 条就绪消息或 1 GiB 消息体,达到任一上限后拒绝新发布。策略便于在线调整,比声明时写死 x-arguments 更适合运维控制。
rabbitmqctl set_policy -p app-vhost \
  --apply-to queues \
  queue-backlog-limit '^orders\.retry$' \
  '{"max-length":100000,"max-length-bytes":1073741824,"overflow":"reject-publish"}'

rabbitmqctl list_policies -p app-vhost --silent
rabbitmqctl list_queues -p app-vhost \
  name policy messages_ready message_bytes_ready \
  --silent
预期输出(省略设置成功提示,计数为动态值):
vhost      name                 pattern          apply-to  definition                                                                      priority
app-vhost  queue-backlog-limit  ^orders\.retry$  queues    {"max-length":100000,"max-length-bytes":1073741824,"overflow":"reject-publish"}  0

name          policy               messages_ready  message_bytes_ready
orders.retry  queue-backlog-limit  <COUNT>         <BYTES>
messages_ready 和 message_bytes_ready 应低于对应上限;已投递但未确认的消息不计入长度限制。
常用参数
| 参数 | 作用 | 边界 |
|---|---|---|
max-length |
限制就绪消息条数 | 非负整数,不含 unacked |
max-length-bytes |
限制就绪消息体总字节数 | 不含属性、头部和 Broker 开销 |
overflow |
定义达到上限后的动作 | 默认 drop-head;也可用 reject-publish 或受队列类型限制的 reject-publish-dlx |
策略与队列声明参数同时设置同类上限时,较小值生效;operator policy 也可能进一步收紧限制。排查时应同时查看 arguments、policy 和 effective_policy_definition。
溢出行为
drop-head 会丢弃队头最旧消息,为新消息腾出空间;若配置 DLX,被长度限制淘汰的消息可进入死信。它适合只关心最新状态的缓存型队列,不适合订单、账务或审计消息。
reject-publish 拒绝最新发布。发布者启用 publisher confirms 后会收到 basic.nack,应用必须执行有界重试、退避和幂等处理。消息同时路由到多个队列时,一个满队列可能导致 nack,但其他队列仍可能已经入队。
reject-publish-dlx 会尝试死信被拒绝的新消息,但 quorum queue 不支持该模式。quorum queue 使用 reject-publish,由应用根据 nack 重试、降级或改投补偿交换机。
风险与边界
对已有大积压突然下调上限,会立即淘汰超出部分;默认 drop-head 可能批量丢失最旧消息。安全做法是先记录积压和入出速率,暂停或限流发布,验证 DLX,再分阶段降低上限。
长度限制只统计 ready,无法约束大量 unacked。若消费者长期不确认,仍会占用资源并在连接恢复时集中回流;应配合合理的 prefetch、处理超时和消费者故障恢复策略。
没有 publisher confirms 时,reject-publish 无法形成可靠的应用级失败确认。生产者应开启 confirms,并统一处理 nack、超时和连接中断。
排障清单
- 上限看似无效:确认观察的是
messages_ready,不是总消息数或 unacked。 - 实际上限偏小:检查
x-max-length、x-max-length-bytes和 operator policy。 - 发布端持续 nack:检查消费者吞吐、预取值、下游依赖和重试风暴。
- 老消息消失:检查是否仍使用默认
drop-head,以及 DLX、绑定和死信消费者是否正常。 - 字节数提前触顶:该值只统计消息体,容量规划仍需预留属性、索引、复制和磁盘段开销。
将拒绝、过期、超长或达到投递限制的消息路由到死信队列。
配置死信交换机
用于把主队列中被拒绝且不再入队、TTL 过期、超过队列长度限制,或 quorum queue 超过投递限制的消息转移到独立队列,便于隔离、审计和人工重放。推荐先声明死信交换机与死信队列,再通过 policy 或队列参数把主队列指向它。
路由关系
主队列只负责正常消费;触发死信条件后,RabbitMQ 以原交换机和路由键信息为基础重新发布到 DLX,再由 DLX 的绑定规则送入死信队列。显式设置 x-dead-letter-routing-key 可避免原路由键不匹配导致无队列接收。
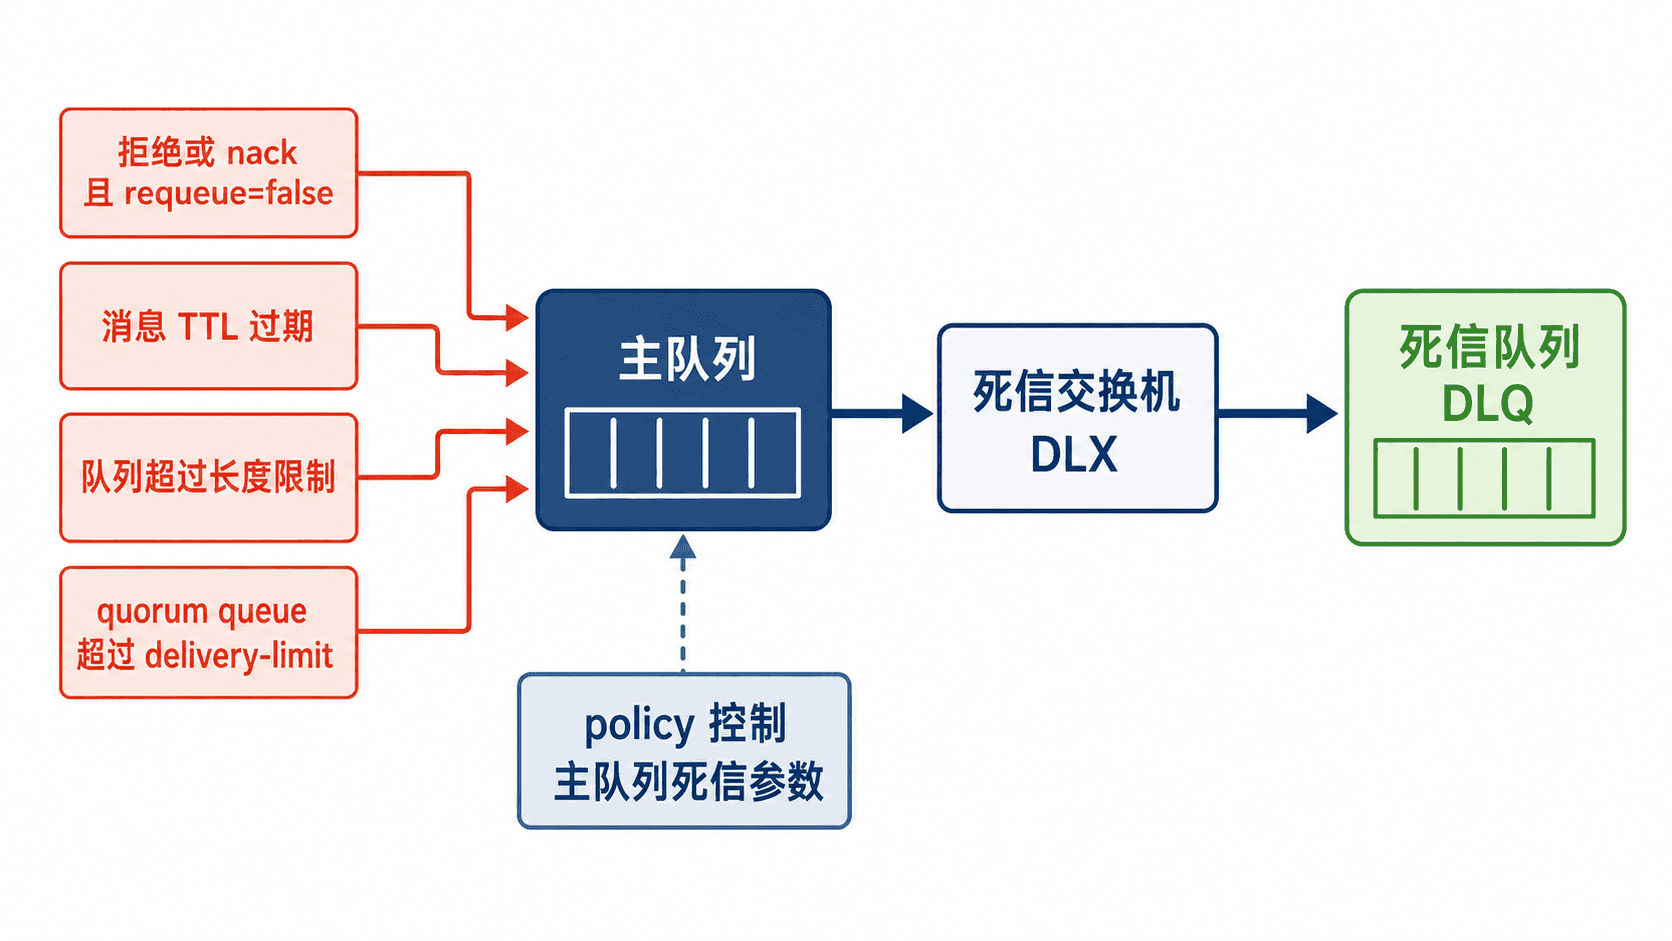
可运行示例
示例使用 pika 声明一组演示拓扑,发布消息后以 requeue=False 拒绝,再从死信队列读取。运行前确保本机 RabbitMQ 可连接且已安装 pika;脚本会清空 demo.work 与 demo.dead,不要替换成生产队列名。
import os
import time
import pika

url = os.getenv("AMQP_URL", "amqp://guest:guest@localhost:5672/%2F")
connection = pika.BlockingConnection(pika.URLParameters(url))
channel = connection.channel()

channel.exchange_declare("demo.dlx", "direct", durable=True)
channel.queue_declare("demo.dead", durable=True)
channel.queue_bind("demo.dead", "demo.dlx", "demo.dead")

# 队列参数在声明时固定;同名队列已有不同参数会报 PRECONDITION_FAILED。
channel.queue_declare(
    "demo.work",
    durable=True,
    arguments={
        "x-dead-letter-exchange": "demo.dlx",
        "x-dead-letter-routing-key": "demo.dead",
    },
)
channel.queue_purge("demo.work")
channel.queue_purge("demo.dead")

channel.basic_publish(
    exchange="",
    routing_key="demo.work",
    body=b"order-1001",
    properties=pika.BasicProperties(delivery_mode=2),
)
method, _, _ = channel.basic_get("demo.work", auto_ack=False)
if method is None:
    raise RuntimeError("demo.work 中没有消息")
channel.basic_reject(method.delivery_tag, requeue=False)

# 等待 broker 完成死信转发,避免本机负载高时立即读取为空。
deadline = time.monotonic() + 5
body = None
while body is None and time.monotonic() < deadline:
    _, _, body = channel.basic_get("demo.dead", auto_ack=True)
    if body is None:
        time.sleep(0.05)
if body is None:
    raise RuntimeError("5 秒内未收到死信")
print("dead-lettered:", body.decode())
connection.close()
预期输出
dead-lettered: order-1001生产配置
生产环境优先用 policy 注入死信参数,便于在线修改,避免应用因硬编码参数变化而重新声明队列。DLX 与 DLQ 仍需提前存在并完成绑定。
rabbitmqctl set_policy -p / --apply-to queues --priority 10 DLX '^orders\.work$' '{"dead-letter-exchange":"orders.dlx","dead-letter-routing-key":"orders.dead"}' >/dev/null && printf 'policy configured\n'预期输出
policy configuredpolicy 定义里的键不带 x-;客户端声明队列参数时才使用 x-dead-letter-exchange 和 x-dead-letter-routing-key。
高频用法
- 消费失败且确认不可立即恢复:执行
basic.reject或basic.nack,并设置requeue=false。 - 业务超时:给主队列配置消息 TTL,使过期消息进入超时 DLQ。
- 防止积压失控:配置队列长度限制,把被淘汰消息转入 DLQ。
- quorum queue 毒消息隔离:配置有限
delivery-limit,超限后死信。
输出字段说明
死信消息通常带有 x-death 数组,可读取 queue、reason、count、exchange、routing-keys 和 time。同一队列与同一原因的重复死亡会合并计数;排障时同时记录业务 message_id 或 correlation_id,不要只依赖消息体定位。
风险与边界
- DLX 不存在或绑定键不匹配时,死信可能没有目标队列。上线前先发送一条测试消息并确认 DLQ 数量增加。
requeue=true不会进入 DLX,持续失败时可能形成高 CPU、高网络流量的热循环。改为有限重试队列或最终拒绝。- 修改硬编码
x-arguments后直接重声明同名队列会触发PRECONDITION_FAILED。优先使用 policy;确需改声明参数时先迁移消息并重建队列。 - 死信转发不等于端到端恰好一次。严格场景应启用发布确认、使用持久化消息,并让下游按业务幂等键去重。
兼容性
delivery-limit 属于 quorum queue 能力;classic queue 可使用拒绝、TTL 和长度限制触发死信。不同客户端对 x-death 的时间和表结构映射略有差异,读取时按客户端实际类型解析。
使用 TTL 与死信交换机构建有限次数、可观测的延迟重试。
设计重试队列
使用“工作队列失败后重新发布到固定 TTL 重试队列,TTL 到期再通过 DLX 回到工作队列”的链路实现延迟重试。应用维护重试次数,超过预算后进入失败队列;这样不会原地热循环,也能分别观察短延迟、长延迟和最终失败积压。
推荐链路
消费者失败后先判断重试次数:未超限则发布到对应延迟队列,等待 TTL 到期后由 DLX 返回工作交换机;达到上限则进入失败队列。只有重试消息发布确认成功后,才确认原消息。
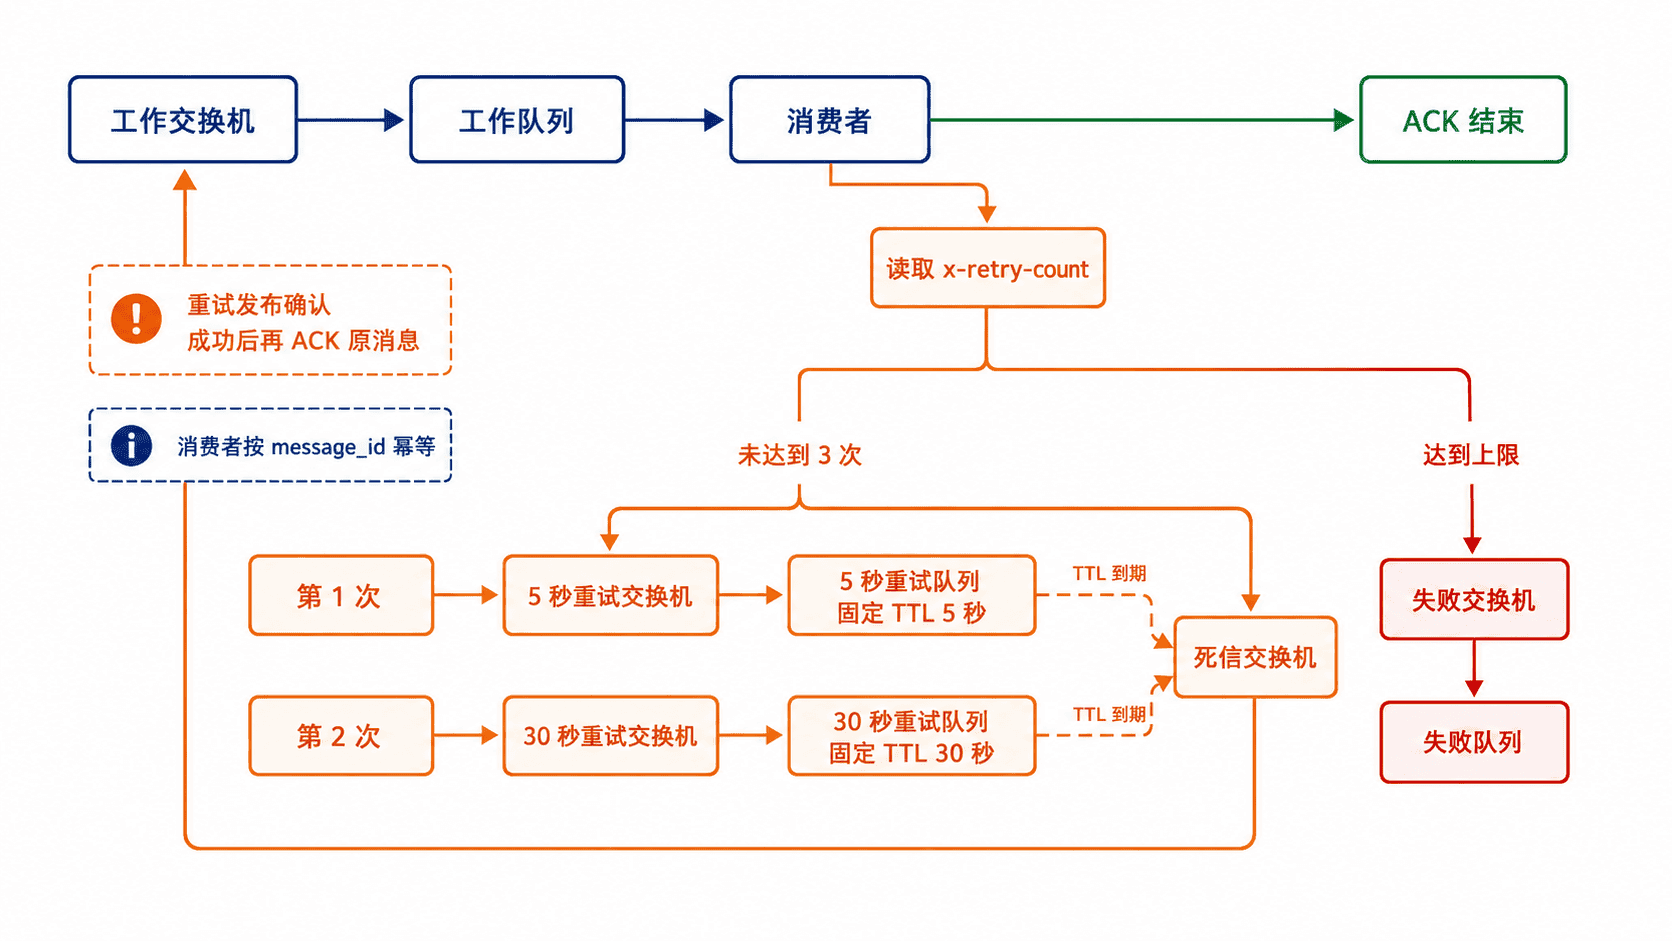
声明重试拓扑
下面脚本声明 5 秒、30 秒两个固定延迟队列。TTL 必须配置在重试队列上,其 DLX 指回工作交换机;重试队列不部署消费者。
import os
import pika

url = os.getenv("AMQP_URL", "amqp://guest:guest@localhost:5672/%2F")
connection = pika.BlockingConnection(pika.URLParameters(url))
channel = connection.channel()

channel.exchange_declare("demo.work.x", "direct", durable=True)
channel.exchange_declare("demo.retry.x", "direct", durable=True)
channel.exchange_declare("demo.failed.x", "direct", durable=True)

channel.queue_declare("demo.work", durable=True)
channel.queue_bind("demo.work", "demo.work.x", "demo.work")

for queue_name, routing_key, ttl_ms in [
    ("demo.retry.5s", "retry.5s", 5_000),
    ("demo.retry.30s", "retry.30s", 30_000),
]:
    channel.queue_declare(
        queue_name,
        durable=True,
        arguments={
            "x-message-ttl": ttl_ms,
            "x-dead-letter-exchange": "demo.work.x",
            "x-dead-letter-routing-key": "demo.work",
        },
    )
    channel.queue_bind(queue_name, "demo.retry.x", routing_key)

channel.queue_declare("demo.failed", durable=True)
channel.queue_bind("demo.failed", "demo.failed.x", "failed")

print("retry topology ready")
connection.close()
预期输出
retry topology ready消费者重试核心
片段示例:放入已有 pika 消费者回调,依赖当前的 channel、method、properties 和 body。连接建立后先调用 channel.confirm_delivery(),确保重试发布得到 broker 确认。
import pika

# 初始化阶段调用一次;NACK 或无路由会抛出异常,原消息因此不会被 ACK。
channel.confirm_delivery()
MAX_RETRIES = 3

def retry_or_park(channel, method, properties, body, error):
    headers = dict(properties.headers or {})
    retry_count = int(headers.get("x-retry-count", 0))

    if retry_count < MAX_RETRIES:
        headers["x-retry-count"] = retry_count + 1
        headers.setdefault("x-first-failure", str(error)[:200])
        exchange = "demo.retry.x"
        routing_key = "retry.5s" if retry_count == 0 else "retry.30s"
    else:
        exchange = "demo.failed.x"
        routing_key = "failed"

    # mandatory 与发布确认共同防止“无绑定但误认为已进入重试队列”。
    channel.basic_publish(
        exchange=exchange,
        routing_key=routing_key,
        body=body,
        mandatory=True,
        properties=pika.BasicProperties(
            delivery_mode=2,
            content_type=properties.content_type,
            message_id=properties.message_id,
            correlation_id=properties.correlation_id,
            headers=headers,
        ),
    )
    channel.basic_ack(method.delivery_tag)
生效行为:首次失败进入 5 秒队列,后续失败进入 30 秒队列;完成 3 次重试后,下一次失败进入 demo.failed。发布失败时应让异常向外抛出,不确认原消息。
重试预算与可观测性
应用头 x-retry-count 负责明确预算,broker 添加的 x-death 用于证明消息在哪个延迟队列因 TTL 过期。监控至少覆盖工作队列、各延迟队列和失败队列的消息数、最老消息年龄、入队速率与消费者异常率,并把 message_id、重试次数和失败原因写入结构化日志。
固定延迟队列通常按少量档位设计,例如 5 秒、30 秒、5 分钟。不要为每个请求动态创建队列;队列数量和绑定会增加节点元数据、监控与恢复成本。
风险与边界
- 先确认原消息、后发布重试消息:发布失败时会永久丢失。安全顺序是“发布并确认成功,再 ACK 原消息”。
- 重试发布成功后进程崩溃、原消息尚未 ACK:同一业务可能同时存在原消息和重试消息。消费者必须按订单号、请求号等业务幂等键去重。
- 使用
basic.nack(requeue=true)代替延迟队列:消息会立即再次投递,故障持续时形成热循环。改用固定 TTL 重试队列并设置最大次数。 - 在同一队列混用大量不同的逐消息 TTL:短延迟消息可能被前方长延迟消息阻塞。使用每个延迟档位一个固定 TTL 队列。
- 只依赖
x-death决定业务预算:手工重发、跨队列或拓扑调整会让计数语义难以统一。由应用头控制次数,x-death只做审计和排障。
兼容性
TTL 加 DLX 是 RabbitMQ 内置能力,不依赖延迟消息插件。若改用插件提供的延迟交换机,需要单独安装、升级和验证插件;有限次数、发布确认、幂等与失败队列仍然必须由应用设计。
在延迟插件与 TTL 死信方案之间选择并验证延迟精度。
实现延迟投递
用于在 RabbitMQ 中按指定时间后再路由消息,并用实测偏差判断方案是否满足精度要求。新部署优先考虑 TTL+DLX、外部调度器或产品自带的延迟队列;旧版 rabbitmq_delayed_message_exchange 仅适合已验证兼容、延迟量有限的存量系统。
方案选择
| 条件 | 建议方案 | 主要取舍 |
|---|---|---|
| 固定为几档延迟,如 5 秒、30 秒、5 分钟 | TTL 等待队列 + DLX | 核心功能、队列可观察;每档需要独立队列或策略 |
| 存量 RabbitMQ 版本已匹配插件,且需要逐消息毫秒值 | 延迟交换机插件 | 发布简单;插件已停止维护,节点丢失和大堆积风险较高 |
| 延迟按天、需要取消/改期、百万级待调度消息 | 外部调度器或专用延迟队列 | 状态更可控,但需要额外组件 |
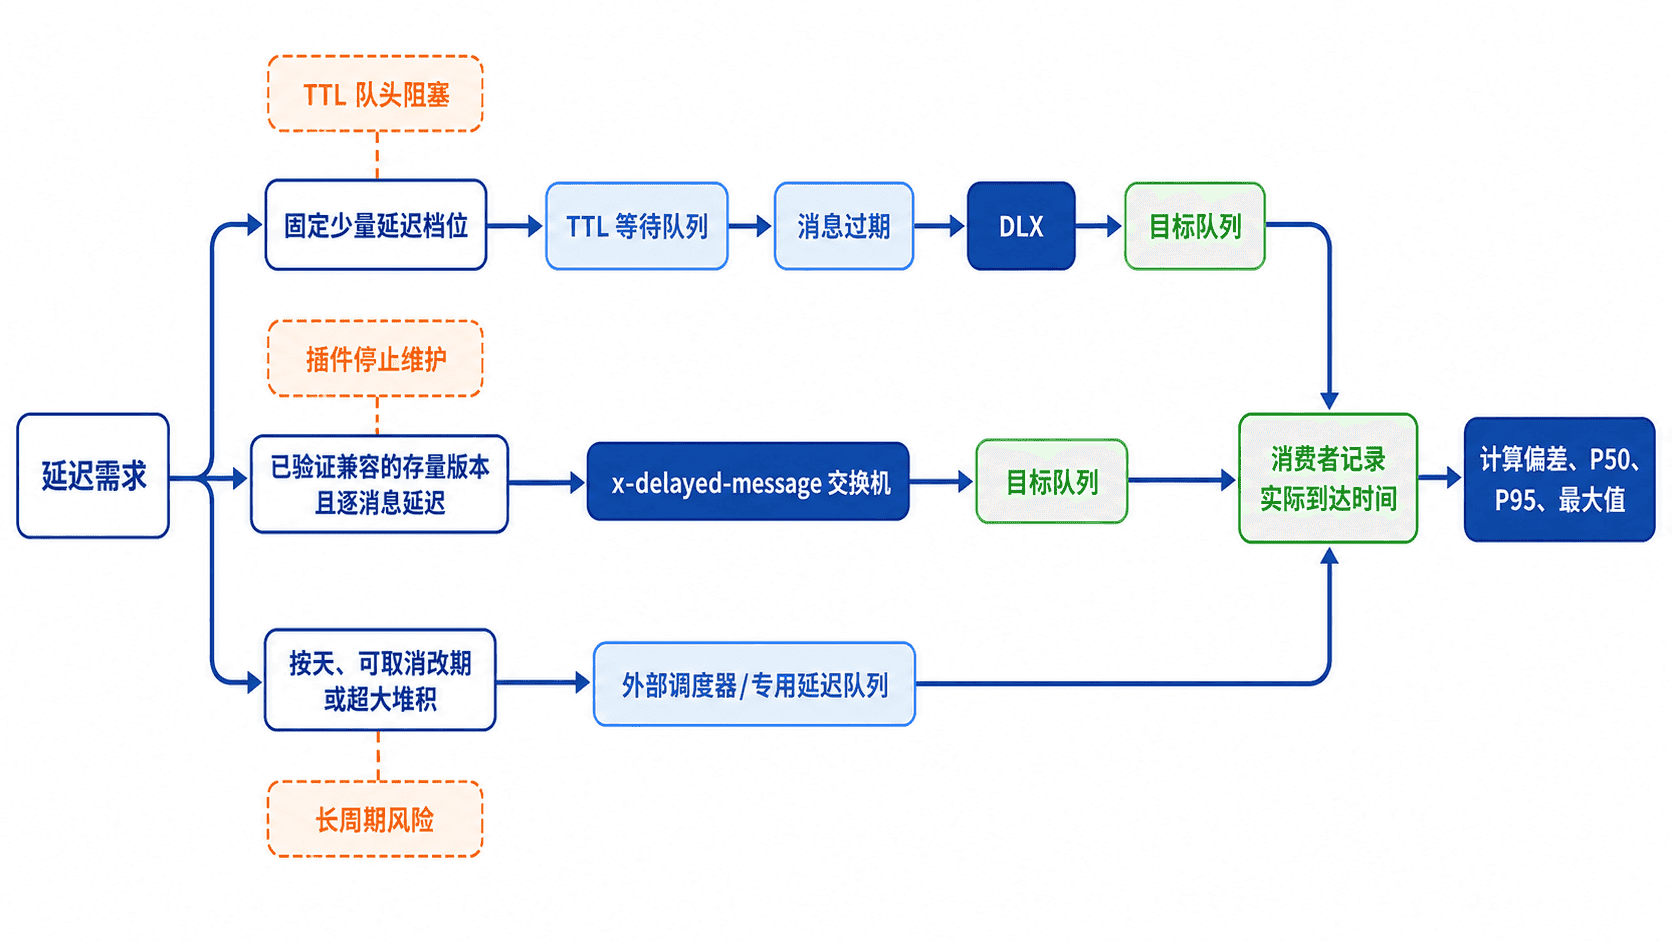
基本语法
延迟插件声明 x-delayed-message 交换机,并通过 x-delayed-type 指定实际路由类型;发布时在消息头设置毫秒值 x-delay。TTL 方案把消息先发到等待队列,通过消息属性 expiration 或队列参数 x-message-ttl 设置毫秒 TTL,再由 x-dead-letter-exchange 和 x-dead-letter-routing-key 转发。
以下探针分别建立临时拓扑,连续发送同一延迟值的消息并统计偏差。运行前保证本机 RabbitMQ 可用,并安装 Pika:python -m pip install pika。插件模式还要求节点已安装并启用匹配版本的延迟插件。
#!/usr/bin/env python3
import argparse
import json
import math
import statistics
import time
import uuid

import pika

def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("--mode", choices=("ttl", "plugin"), required=True)
    parser.add_argument("--delay-ms", type=int, default=3000)
    parser.add_argument("--samples", type=int, default=3)
    args = parser.parse_args()

    if args.delay_ms < 0 or args.samples < 1:
        raise SystemExit("delay-ms must be >= 0 and samples must be >= 1")

    suffix = uuid.uuid4().hex[:8]
    routing_key = "probe"
    target_queue = f"delay.target.{suffix}"

    connection = pika.BlockingConnection(pika.ConnectionParameters("localhost"))
    channel = connection.channel()
    channel.queue_declare(
        queue=target_queue,
        durable=False,
        exclusive=True,
        auto_delete=True,
    )

    if args.mode == "plugin":
        publish_exchange = f"delay.plugin.{suffix}"
        publish_routing_key = routing_key
        channel.exchange_declare(
            exchange=publish_exchange,
            exchange_type="x-delayed-message",
            durable=False,
            auto_delete=True,
            arguments={"x-delayed-type": "direct"},
        )
        channel.queue_bind(target_queue, publish_exchange, routing_key)
    else:
        target_exchange = f"delay.target.ex.{suffix}"
        wait_queue = f"delay.wait.{suffix}"
        channel.exchange_declare(
            exchange=target_exchange,
            exchange_type="direct",
            durable=False,
            auto_delete=True,
        )
        channel.queue_bind(target_queue, target_exchange, routing_key)
        channel.queue_declare(
            queue=wait_queue,
            durable=False,
            exclusive=True,
            auto_delete=True,
            arguments={
                "x-dead-letter-exchange": target_exchange,
                "x-dead-letter-routing-key": routing_key,
            },
        )
        publish_exchange = ""
        publish_routing_key = wait_queue

    for sample in range(1, args.samples + 1):
        sent_ns = time.monotonic_ns()
        body = json.dumps({"sample": sample, "sent_ns": sent_ns}).encode()
        properties = pika.BasicProperties(
            content_type="application/json",
            headers={"x-delay": args.delay_ms} if args.mode == "plugin" else None,
            expiration=str(args.delay_ms) if args.mode == "ttl" else None,
        )
        channel.basic_publish(
            exchange=publish_exchange,
            routing_key=publish_routing_key,
            body=body,
            properties=properties,
        )

    observed = []
    deadline = time.monotonic() + args.delay_ms / 1000 + 30
    while len(observed) < args.samples and time.monotonic() < deadline:
        method, _, body = channel.basic_get(target_queue, auto_ack=True)
        if method is None:
            time.sleep(0.01)
            continue

        payload = json.loads(body)
        actual_ms = (time.monotonic_ns() - payload["sent_ns"]) / 1_000_000
        observed.append(actual_ms)
        error_ms = actual_ms - args.delay_ms
        print(
            f"sample={payload['sample']} actual={actual_ms:.0f}ms "
            f"error={error_ms:+.0f}ms"
        )

    if len(observed) != args.samples:
        raise SystemExit(f"timeout: received {len(observed)}/{args.samples}")

    ordered = sorted(observed)
    p95 = ordered[math.ceil(len(ordered) * 0.95) - 1]
    print(
        f"summary mode={args.mode} target={args.delay_ms}ms "
        f"p50={statistics.median(observed):.0f}ms "
        f"p95={p95:.0f}ms max={max(observed):.0f}ms"
    )
    connection.close()

if __name__ == "__main__":
    main()
分别执行两种模式;插件不可用时只运行 TTL 模式。
python delay_probe.py --mode ttl --delay-ms 3000 --samples 3
python delay_probe.py --mode plugin --delay-ms 3000 --samples 3预期输出如下,<...> 为随负载、轮询间隔和主机调度变化的实测值。
sample=1 actual=<ACTUAL_MS>ms error=<SIGNED_ERROR_MS>ms
sample=2 actual=<ACTUAL_MS>ms error=<SIGNED_ERROR_MS>ms
sample=3 actual=<ACTUAL_MS>ms error=<SIGNED_ERROR_MS>ms
summary mode=ttl target=3000ms p50=<P50_MS>ms p95=<P95_MS>ms max=<MAX_MS>ms
sample=1 actual=<ACTUAL_MS>ms error=<SIGNED_ERROR_MS>ms
sample=2 actual=<ACTUAL_MS>ms error=<SIGNED_ERROR_MS>ms
sample=3 actual=<ACTUAL_MS>ms error=<SIGNED_ERROR_MS>ms
summary mode=plugin target=3000ms p50=<P50_MS>ms p95=<P95_MS>ms max=<MAX_MS>ms
读取时关注 error、p95 和 max,不要只看平均值。该探针包含约 10 毫秒轮询误差,因此验收阈值应高于探针自身分辨率,并在真实消息大小、持久化、镜像/仲裁队列和峰值负载下重复测试。
风险与边界
TTL 方案在同一等待队列混用不同的逐消息 TTL 时,短延迟消息可能排在长延迟消息之后,只有到达队头才会被清理和死信,结果是延迟超时且过期消息继续占用资源。安全替代是按固定延迟档位拆分等待队列,或把可变、可取消的计划交给外部调度器。
插件模式在大量待延迟消息、节点故障、禁用插件或升级到不兼容版本时,可能出现吞吐下降或未投递消息丢失。不要把它当作长期计划任务存储;启用前固定 RabbitMQ、Erlang 与插件版本,并验证节点重启、故障转移、积压清理和升级回滚。
TTL 到期或计时器触发只表示消息变为可路由/可投递,不等于消费者完成处理。磁盘告警、流控、队列积压、消费者预取和 GC 都会增加实际到达时间;业务幂等键、发布确认、消费确认和死信兜底仍需独立配置。
排障清单
- 延迟插件声明报
unknown exchange type 'x-delayed-message':检查插件文件、版本匹配、启用状态和节点重启。 - TTL 到期后目标队列为空:核对等待队列的 DLX 名称、路由键、目标绑定和发布权限。
- 实际延迟只增不减:检查是否在同一等待队列混用了不同 TTL,以及队头是否有更长 TTL 消息。
- 偏差只在高峰放大:同时观察磁盘告警、内存告警、连接流控、队列深度、消费者未确认数和节点调度延迟。
兼容性
RabbitMQ 延迟消息插件已停止维护,其设计依赖已在 RabbitMQ 4.3 开发周期移除的 Mnesia,因此新系统和 4.3 及以上升级路径不要继续依赖旧插件。TTL 与 DLX 是核心能力,适合固定延迟档位;需要长期、大规模、可查询和可取消调度时使用外部调度器或受支持的专用延迟队列。
设置有限优先级范围并评估内存、吞吐和饥饿风险。
使用优先级队列
用于让高优先级消息在队列中等待时先于低优先级消息投递。优先级只影响尚未投递的消息;已经进入消费者预取窗口或正在处理的低优先级消息不会被后来消息抢占。
队列声明与取值
经典队列通过声明参数 x-max-priority 启用优先级,建议只设 2~4 个等级。发布者在消息属性 priority 中写入整数;未设置时按 0 处理,超过最大值时按最大值处理。该参数不能通过策略动态修改,也不能在原队列上直接变更。
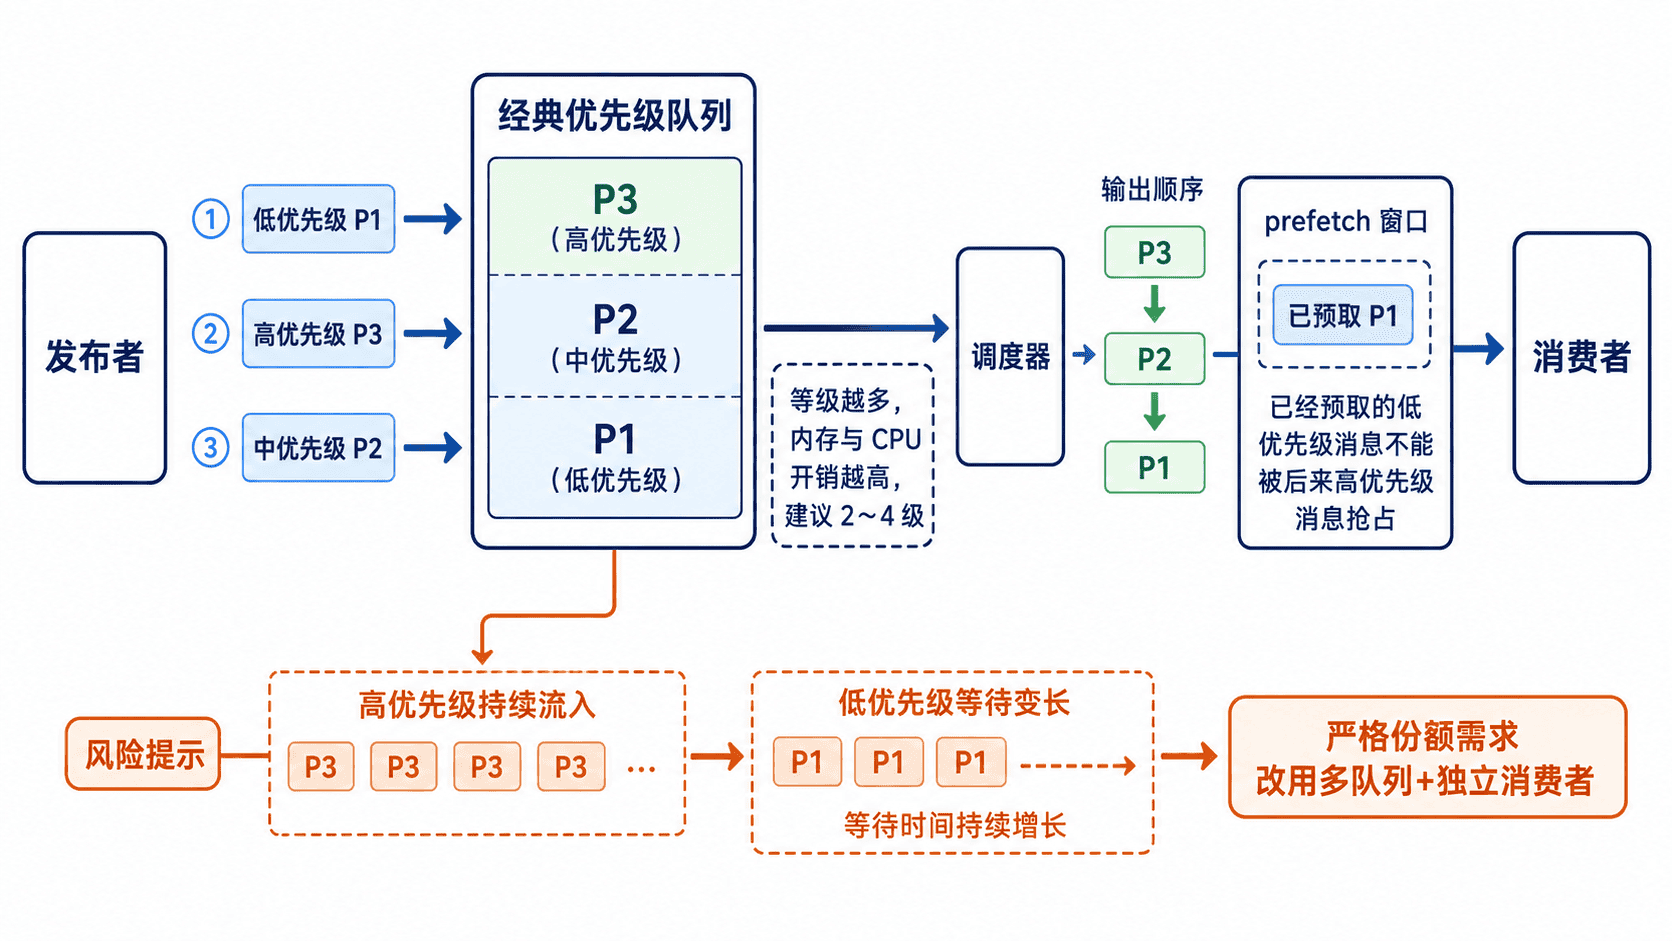
下面的可运行示例在消费者启动前先把三条消息写入经典优先级队列,因此输出顺序稳定。运行前保证本机 RabbitMQ 可用,并安装 Pika:python -m pip install pika。
#!/usr/bin/env python3
import uuid

import pika

def main() -> None:
    queue_name = f"priority.demo.{uuid.uuid4().hex[:8]}"
    connection = pika.BlockingConnection(pika.ConnectionParameters("localhost"))
    channel = connection.channel()

    # 经典队列会为配置范围内的优先级维护额外内部结构。
    channel.queue_declare(
        queue=queue_name,
        durable=False,
        exclusive=True,
        auto_delete=True,
        arguments={
            "x-queue-type": "classic",
            "x-max-priority": 3,
        },
    )

    messages = [
        ("low", 1),
        ("high", 3),
        ("medium", 2),
    ]
    for body, priority in messages:
        channel.basic_publish(
            exchange="",
            routing_key=queue_name,
            body=body.encode(),
            properties=pika.BasicProperties(priority=priority),
        )

    # 全部入队后再拉取,避免消息直接进入消费者预取窗口。
    for _ in messages:
        method, properties, body = channel.basic_get(
            queue=queue_name,
            auto_ack=True,
        )
        if method is None:
            raise SystemExit("queue unexpectedly empty")
        print(f"{body.decode()} priority={properties.priority}")

    connection.close()

if __name__ == "__main__":
    main()
执行脚本。
python priority_demo.py预期输出:
high priority=3
medium priority=2
low priority=1
读取方法是先看消息是否真的在队列中等待,再判断投递顺序。若消费者已经在线且预取值很大,低优先级消息可能先被推送到客户端,此时即使队列支持优先级,业务处理顺序也不会像示例一样整齐。
消费端设置
使用手动确认,并把 basic.qos 的预取值控制在“单个消费者实际并发处理数”的小范围内,让更多消息留在队列中参与排序。预取过大时,触发条件是消费者一次拿走大量低优先级消息;后果是高优先级消息只能等待这些在途消息完成;安全替代是降低预取、增加消费者,或按高/中/低拆成独立队列。
优先级队列不保证跨多个消费者的全局完成顺序。处理耗时、网络抖动、重投递和消费者故障都可能让低优先级任务先完成;需要严格串行时使用单活消费者或单消费者,并接受吞吐下降。
风险与边界
经典队列的优先级等级越多,内部子队列、Erlang 进程、内存和消费 CPU 开销越高,队列数量大时会明显压低吞吐。不要直接使用 255 个等级;先用 2~4 级压测,再通过管理指标观察消息速率、内存、进程数和消费者利用率。
重新声明已有队列时,如果 x-max-priority 与原值不同,节点会关闭信道并返回 PRECONDITION_FAILED inequivalent arg。安全变更方式是创建新队列、绑定相同路由、灰度切换生产者和消费者,确认旧队列清空后再删除。
持续高优先级流量会增加低优先级延迟。经典队列会在优先级层之间轮转,通常不会永久饿死低等级,但无法提供固定份额;RabbitMQ 4.3 及以上仲裁队列采用严格优先级,低等级可能无限等待。需要明确配额时使用多队列和独立消费者,并在应用层做加权调度。
排障清单
- 输出仍像 FIFO:确认队列实际带有
x-max-priority,发布属性使用priority,并让消息在队列中等待后再观察。 - 高优先级仍很慢:检查消费者预取、未确认消息数、处理并发和是否已有大量低优先级消息在途。
- 声明时报参数不等价:不要原地改等级,创建新队列迁移。
- 内存或 CPU 随队列数上升:减少优先级等级,合并无意义的细粒度优先级,或拆成少量业务队列。
- 低优先级延迟失控:为不同等级设置独立队列、消费者并发和限流,不依赖单队列提供配额。
兼容性
经典队列支持 x-max-priority,范围为 1~255,但推荐低个位数。RabbitMQ 4.3 起仲裁队列提供 0~31 的严格优先级且始终启用,x-max-priority 对仲裁队列无效;升级或混用队列类型时必须分别验证声明参数、默认优先级、TTL 和重投递行为。
为需要复制与数据安全的工作负载声明并使用 quorum queue。
使用 Quorum 队列
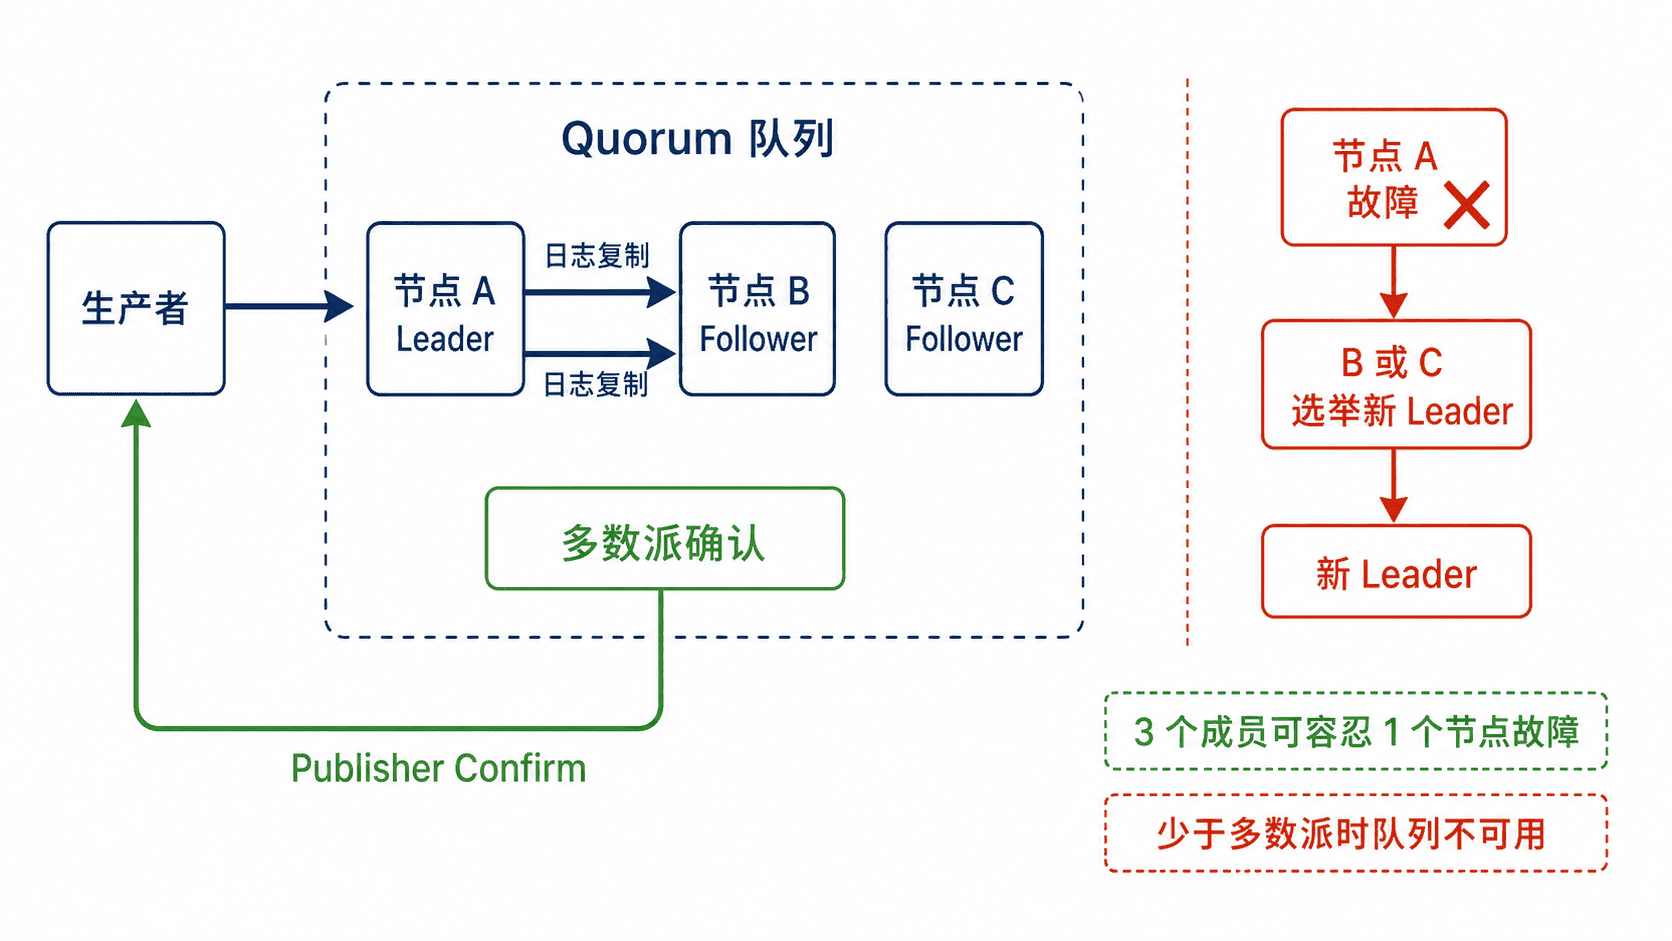
Quorum 队列用于订单、支付、任务等不能接受单节点丢失的持久消息。它把同一队列复制到多个 RabbitMQ 节点,并在多数副本在线时继续提供服务;生产环境通常使用 3 个成员。
适用条件
优先用于需要复制、稳定主节点选举和发布确认的数据安全型工作负载。临时队列、连接独占队列、高频创建删除队列、超长积压或只追求最低延迟的场景不适合,后两类可分别评估 classic queue 或 stream。
声明与验证
以下示例使用已配置连接信息的 rabbitmqadmin v2,并在默认虚拟主机 / 创建队列。队列类型只能在首次声明时确定,durable 必须为 true。
rabbitmqadmin --vhost "/" queues declare \
  --name "orders.quorum" \
  --type "quorum" \
  --durable true >/dev/null

rabbitmqctl list_queues -p / name type durable state --no-table-headers \
  | grep '^orders\.quorum[[:space:]]'
预期输出
orders.quorum quorum true running列间空白可能是制表符。读取时确认 type 为 quorum、durable 为 true、state 为 running;仅创建成功但类型为 classic 不算完成。
关键语义
默认成员数最多为 3,每个成员位于不同节点;3 成员队列可容忍 1 个成员失效。发布端仍应启用 Publisher Confirms,只有收到确认的消息才具备预期的数据安全保证。消费端使用手动确认,并采用按消费者设置的 prefetch,不要启用全局 QoS。
x-quorum-initial-group-size 可在首次声明时调整初始成员数,建议使用不小于 3 的奇数。集群新增节点后,已有队列不会仅因节点加入就自动增加副本,需要显式执行成员扩容,或启用持续成员协调。
风险与边界
- 对已有 classic 队列用同名再次声明 quorum,会触发属性不一致并关闭 AMQP channel。安全做法是创建新队列、迁移生产者和消费者、排空旧队列后再删除。
- 多数副本同时离线时,队列为保证一致性会停止服务。维护前先确认节点不是 quorum critical,并始终一次只下线一个承载成员的节点。
- Quorum 队列会复制日志并持续使用磁盘。大消息、长积压或大量队列会放大磁盘与 I/O 压力,应设置长度限制、磁盘告警并做容量压测。
- 非持久、exclusive 或高频创建删除会违背其设计边界。此类工作负载使用 classic queue,海量顺序日志和超长保留使用 stream。
排障清单
先用 rabbitmqctl cluster_status 确认预期节点均在线,再检查队列 state 是否为 running。若队列不可用,核对是否仍有多数成员在线;若新节点没有副本,使用 rabbitmq-queues add_member、grow 或持续成员协调补齐。发布成功但消息仍丢失时,优先检查生产者是否真正等待了 Publisher Confirm。
兼容性
RabbitMQ 4.x 已移除 classic queue mirroring,复制队列应使用 quorum queue 或 stream。rabbitmqadmin v2 使用 queues declare --type quorum;旧版 v1 参数格式不同,自动化脚本升级前应单独验证。
使用 delivery-limit 防止毒消息在 Quorum 队列中无限重投。
限制 Quorum 重投
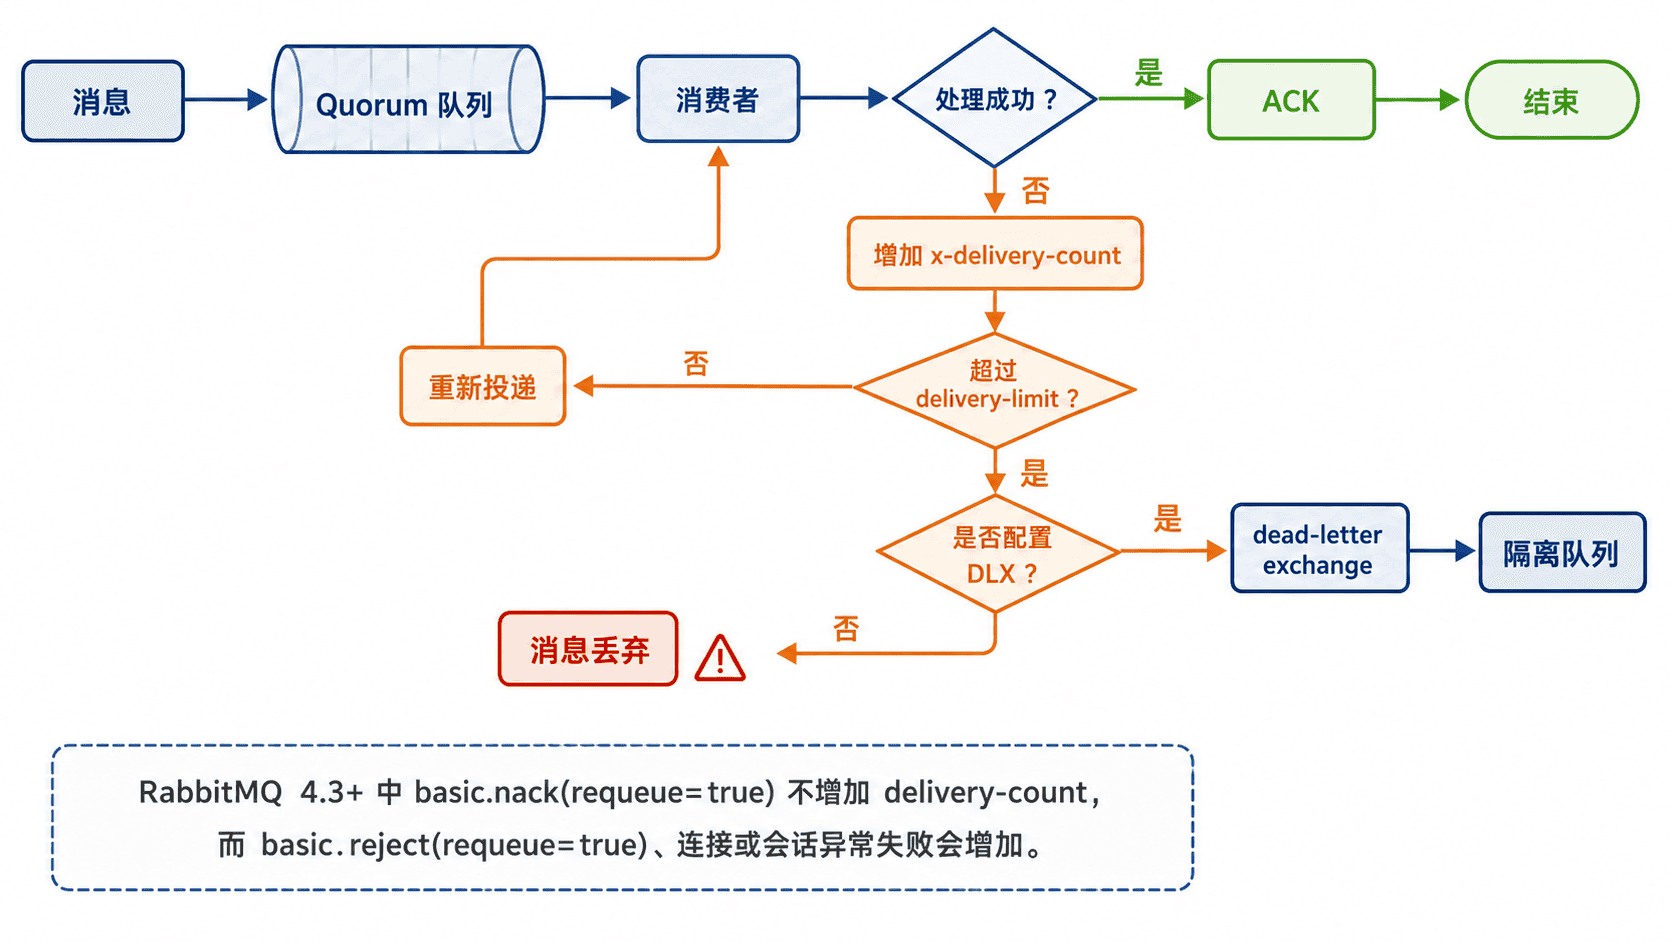
delivery-limit 用于限制 Quorum 队列中同一消息的失败投递次数。消息计数超过阈值后,RabbitMQ 将其丢弃,或在配置 DLX 时转入隔离队列,避免毒消息持续占用消费者和集群资源。
处理链路
建议同时配置有限阈值、死信交换机和隔离队列。消费者成功处理后 ack;确定消息本身不可处理但仍需有限次重试时,应使用会计入失败次数的拒绝方式;超过阈值后由 Broker 自动死信,而不是由业务代码无限循环回队。
配置与验证
以下示例为 orders.quorum 设置最多 5 次失败投递,并把超限消息路由到 orders.poison。命令假设 rabbitmqadmin v2 已配置连接信息,且源队列已经是 Quorum 队列。
rabbitmqadmin --vhost "/" exchanges declare \
  --name "orders.retry.dlx" \
  --type "direct" \
  --durable true >/dev/null

rabbitmqadmin --vhost "/" queues declare \
  --name "orders.poison" \
  --type "quorum" \
  --durable true >/dev/null

rabbitmqadmin --vhost "/" bindings declare \
  --source "orders.retry.dlx" \
  --destination-type "queue" \
  --destination "orders.poison" \
  --routing-key "poison" >/dev/null

rabbitmqctl set_policy -p / qq-delivery-limit '^orders\.quorum$' \
  '{"delivery-limit":5,"dead-letter-exchange":"orders.retry.dlx","dead-letter-routing-key":"poison"}' \
  --priority 100 \
  --apply-to quorum_queues >/dev/null

rabbitmqctl list_policies -p / | grep 'qq-delivery-limit'
预期输出
/ qq-delivery-limit ^orders\.quorum$ quorum_queues {"delivery-limit":5,"dead-letter-exchange":"orders.retry.dlx","dead-letter-routing-key":"poison"} 100实际列间距和定义字段顺序可能不同。确认策略作用域为 quorum_queues、正则只匹配目标队列,并同时看到 delivery-limit 与死信配置。
计数读取
Quorum 队列会在重投消息头中提供 x-delivery-count,用于表示失败投递次数。消费者日志应记录消息 ID、队列名和该头值;值持续接近阈值时,应定位具体异常,而不是简单提高限制。
RabbitMQ 4.0 起默认限制为 20;3.x 默认没有限制。显式设置策略可避免升级后依赖默认值,也便于按业务队列选择 3、5 或 10 等阈值。
4.3 之后的确认语义
RabbitMQ 4.3 起,delivery-limit 只依据失败投递计数。AMQP 0-9-1 的 basic.reject(requeue=true)、连接或会话在存在未确认消息时异常终止会增加计数;basic.nack(requeue=true) 属于显式返回,不增加 x-delivery-count,因此可能绕过限制并形成无限回队。
若应用当前统一使用 nack 重试,安全替代方案是改为能标记失败的拒绝语义,或配置 delayed retry 对所有返回消息施加退避;不要只依赖 delivery-limit 阻止快速循环。
风险与边界
- 超限时未配置 DLX,消息会被直接移除。触发条件是失败投递次数超过阈值,后果是业务数据不可恢复;安全方案是先创建并验证 DLX、绑定和隔离队列,再启用限制。
- 将
delivery-limit设为-1会关闭保护。毒消息可能持续重投、放大 CPU、网络和 Raft 日志压力;仅在短期兼容旧行为时使用,并配套限时回滚。 - 策略正则过宽会同时改变多条 Quorum 队列。上线前使用锚定表达式,检查
list_policies和队列有效策略,避免误把正常长任务过早送入死信。 - 阈值过低会把瞬时故障当成毒消息,阈值过高则延长故障风暴。根据单次处理耗时、外部依赖恢复时间和告警响应能力设值,并优先加入退避而非高频立即重试。
排障清单
消息仍无限回队时,先确认 RabbitMQ 版本和消费者究竟调用 reject 还是 nack,再检查消息头中的 x-delivery-count 是否增长。超限消息没有进入隔离队列时,检查 DLX 是否存在、routing key 是否有绑定、策略是否匹配源队列。隔离队列持续增长时,应暂停自动重放,按异常类型分组修复后再受控回灌。
为高吞吐、可重复读取和保留型消息场景使用 RabbitMQ Streams。
使用 Stream 队列
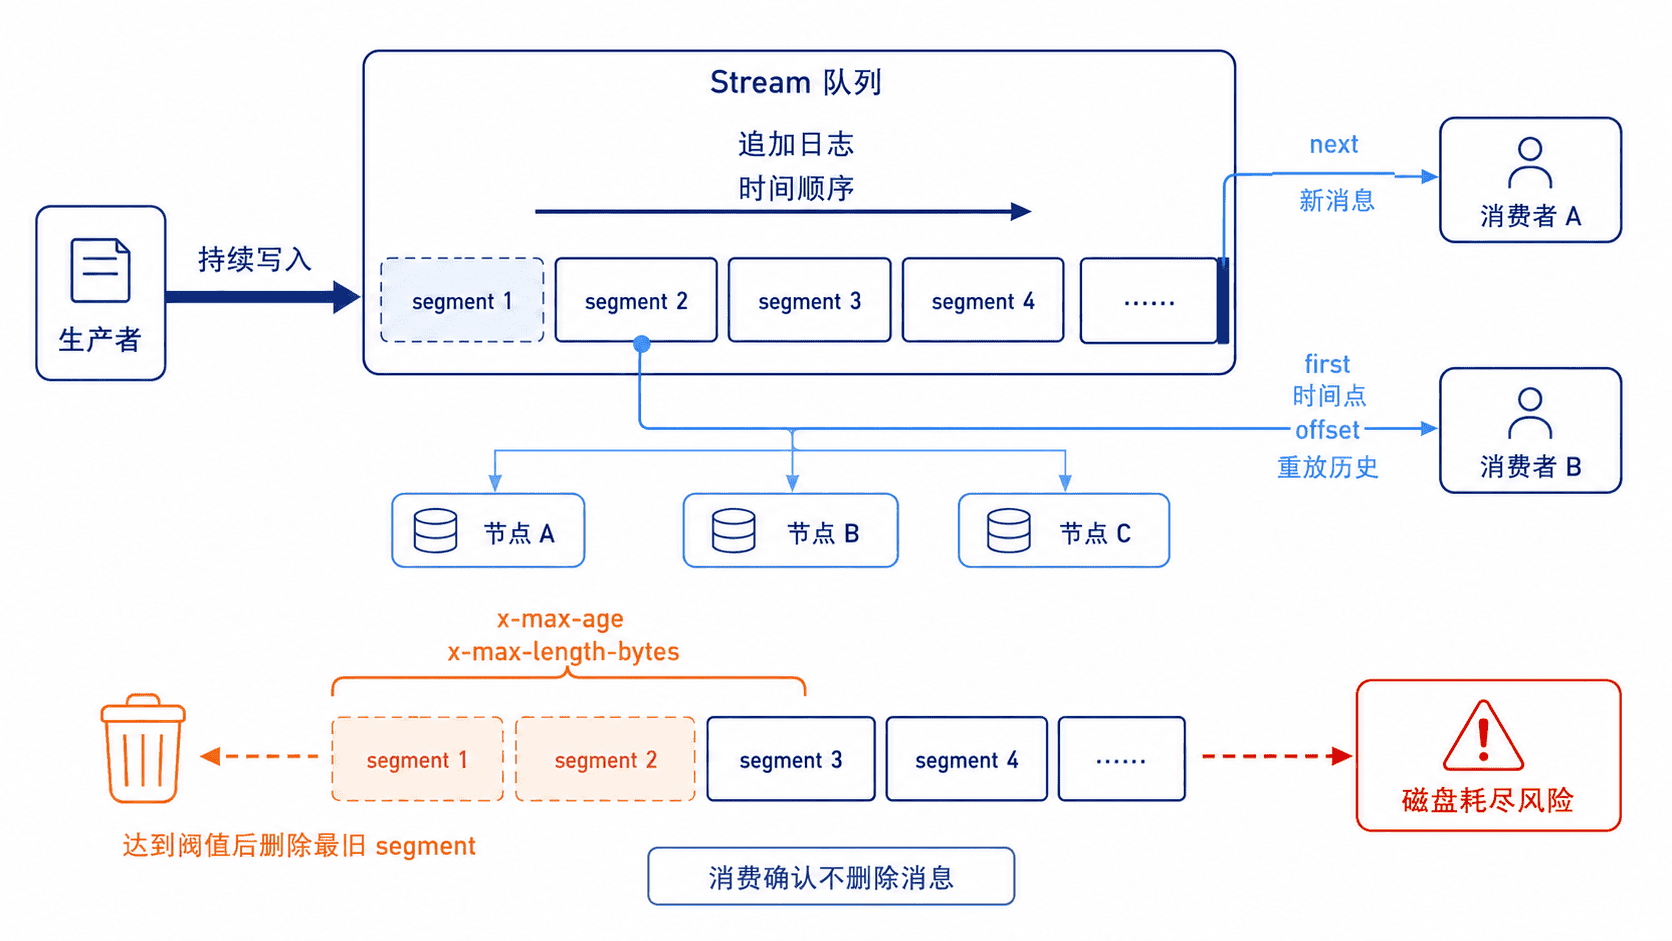
当业务需要高吞吐顺序写入、多个消费组独立读取,或按偏移量和时间重放历史消息时使用 Stream。它是持久化、复制的追加日志;消费确认不会删除消息,磁盘占用必须通过保留策略控制。
适用场景
- 事件审计、埋点、日志和行情等持续追加且允许保留一段时间的数据。
- 同一份消息需要被多个消费组以不同速度读取,或故障后从历史位置重新处理。
- 不适合“处理成功即删除”、低延迟单任务派发、优先级队列或每条消息单独 TTL 的场景;这些需求通常使用 quorum queue。
声明并验证
下面通过 Management HTTP API 在默认 vhost 创建 orders.stream。示例使用本机默认账号,仅适合本地开发;生产环境应改用最小权限账号并启用 TLS。
set -euo pipefail

API='http://127.0.0.1:15672'
AUTH='guest:guest'
VHOST='%2F'
STREAM='orders.stream'

curl -fsS -u "$AUTH" -X PUT \
  "$API/api/queues/$VHOST/$STREAM" \
  -H 'content-type: application/json' \
  --data-binary '{
    "durable": true,
    "auto_delete": false,
    "arguments": {
      "x-queue-type": "stream",
      "x-max-age": "7D",
      "x-max-length-bytes": 10737418240,
      "x-stream-max-segment-size-bytes": 100000000
    }
  }'

curl -fsS -u "$AUTH" "$API/api/queues/$VHOST/$STREAM" |
jq '{
  name,
  durable,
  type,
  retention: {
    max_age: .arguments["x-max-age"],
    max_length_bytes: .arguments["x-max-length-bytes"],
    segment_size_bytes: .arguments["x-stream-max-segment-size-bytes"]
  }
}'
预期输出:
{
  "name": "orders.stream",
  "durable": true,
  "type": "stream",
  "retention": {
    "max_age": "7D",
    "max_length_bytes": 10737418240,
    "segment_size_bytes": 100000000
  }
}
x-max-age 和 x-max-length-bytes 可以同时设置,先触发者生效;删除按 segment 执行,不保证单条消息到点立即消失,并且至少会保留一个仍含消息的 segment。
读取位置
AMQP 0-9-1 消费者通过 x-stream-offset 选择起点:first 从最早可用消息读取,last 从最后一个 chunk 开始,next 只接收订阅后的新消息;也可以传数字 offset、POSIX 秒级时间戳或类似 10m、7D 的相对时间。消费者必须设置 QoS、使用手动确认,并把业务处理做成幂等。
风险与边界
- 未设置保留上限时,持续写入会扩大磁盘占用,最终触发磁盘告警并阻塞发布。安全做法是同时设置时间和字节上限,并监控磁盘剩余量、segment 增长速度与最旧消息年龄。
- 已存在队列的
x-queue-type不能原地改成stream,参数不一致会导致PRECONDITION_FAILED并关闭 channel。应新建 Stream、切换生产者和消费者,再清理旧队列。 - segment 过大时过期回收不够精细,过小时文件数量和元数据开销上升。先按吞吐与保留窗口压测,再调整
x-stream-max-segment-size-bytes。 - Stream 依赖多数副本维持可用性。维护节点时若丢失 quorum,读写会中断;应滚动操作并确认副本同步状态,禁止同时下线多数节点。
排障清单
先确认返回的 type 为 stream,再检查节点磁盘告警、Stream leader 与副本状态。原生 Stream 客户端连接失败时,额外核对 rabbitmq_stream 插件、5552/TLS 监听器及 advertised_host、advertised_port 是否能被客户端解析和访问。
兼容性
Management API 需要启用管理插件。AMQP 0-9-1 客户端可以把 Stream 当作特殊队列访问;使用原生 Stream 协议时需启用 Stream 插件,并注意其独立的连接、监听和 frame 大小配置。
通过对象存储引用、压缩和大小限制避免大消息拖垮 Broker。
处理大消息
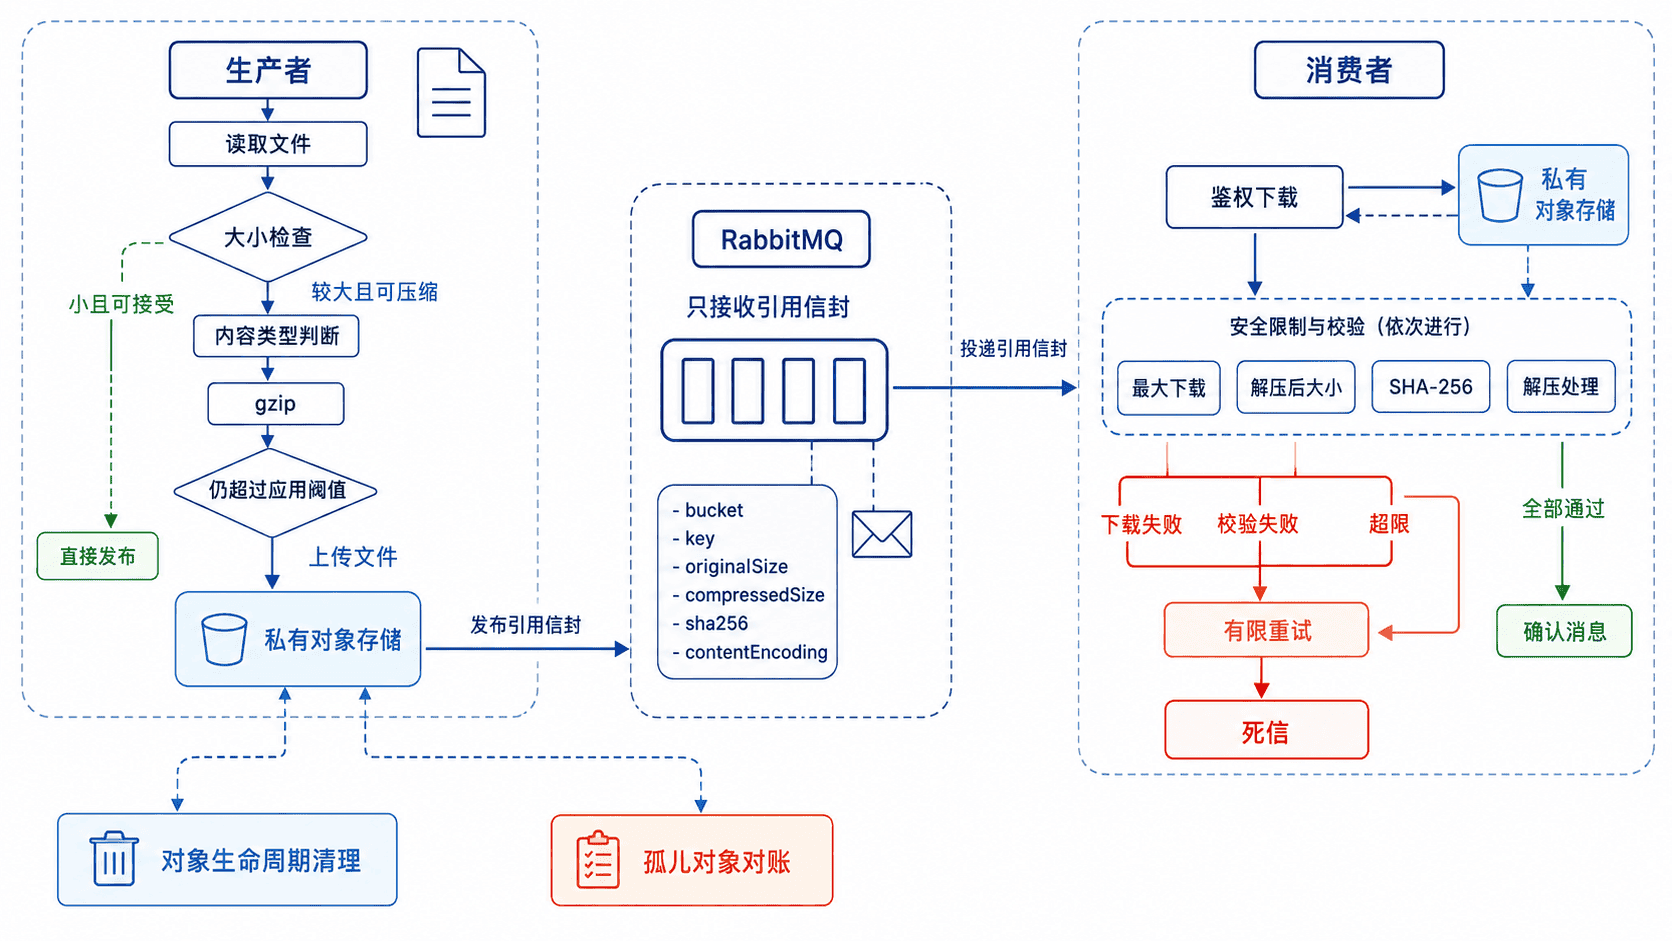
当消息体包含文件、图片、报表或大型 JSON 时,不要直接提高 Broker 上限硬扛。生产者应先做大小门禁:小消息直接发布,可压缩内容按需压缩;超过应用阈值的内容写入私有对象存储,RabbitMQ 只传递短小、可校验的引用信封。
推荐边界
先定义应用级上限,并确保它显著低于 Broker 的 max_message_size。可从 256 KiB 的内联阈值开始压测;文本类负载可以先 gzip,JPEG、MP4、ZIP 等已压缩格式通常不再压缩。对象引用应至少携带存储位置、原始大小、压缩后大小、摘要、内容类型和编码方式。
主示例
下面脚本在负载超过 256 KiB 时先 gzip,再上传到兼容 S3 的私有对象存储,最后只向 RabbitMQ 发布引用信封。运行前需安装 boto3、pika,准备已存在的私有 bucket,并通过默认凭证链授权;配置 AMQP_URL、S3_BUCKET,使用 MinIO 等兼容服务时再设置 S3_ENDPOINT_URL。
import gzip
import hashlib
import json
import mimetypes
import os
import sys
import uuid
from pathlib import Path

import boto3
import pika

INLINE_LIMIT = 256 * 1024
PUBLISH_LIMIT = 512 * 1024
BUFFERED_SOURCE_LIMIT = 64 * 1024 * 1024
QUEUE = "payload.refs"

def main() -> None:
    path = Path(sys.argv[1])
    source_size = path.stat().st_size
    if source_size > BUFFERED_SOURCE_LIMIT:
        raise ValueError("source exceeds buffered example limit; use streaming upload")

    raw = path.read_bytes()
    content_type = mimetypes.guess_type(path.name)[0] or "application/octet-stream"

    if len(raw) <= INLINE_LIMIT:
        body = raw
        mode = "inline"
    else:
        compressed = gzip.compress(raw, compresslevel=6)
        digest = hashlib.sha256(raw).hexdigest()
        key = f"rabbitmq-payloads/{uuid.uuid4()}.gz"

        s3 = boto3.client("s3", endpoint_url=os.getenv("S3_ENDPOINT_URL"))
        s3.put_object(
            Bucket=os.environ["S3_BUCKET"],
            Key=key,
            Body=compressed,
            ContentType=content_type,
            ContentEncoding="gzip",
            Metadata={"sha256": digest, "original-size": str(len(raw))},
        )

        envelope = {
            "schema": "blob-ref-v1",
            "bucket": os.environ["S3_BUCKET"],
            "key": key,
            "contentType": content_type,
            "contentEncoding": "gzip",
            "originalSize": len(raw),
            "compressedSize": len(compressed),
            "sha256": digest,
        }
        body = json.dumps(envelope, separators=(",", ":")).encode()
        mode = "object-reference"

    # 二次门禁防止引用信封或误用路径突破应用发布上限。
    if len(body) > PUBLISH_LIMIT:
        raise ValueError(f"AMQP body too large: {len(body)} bytes")

    connection = pika.BlockingConnection(
        pika.URLParameters(os.environ["AMQP_URL"])
    )
    channel = connection.channel()
    channel.queue_declare(queue=QUEUE, durable=True)
    channel.confirm_delivery()
    channel.basic_publish(
        exchange="",
        routing_key=QUEUE,
        body=body,
        mandatory=True,
        properties=pika.BasicProperties(
            content_type="application/vnd.example.blob-ref+json"
            if mode == "object-reference"
            else content_type,
            content_encoding=None,
            delivery_mode=2,
        ),
    )
    connection.close()

    print(json.dumps({
        "publishedMode": mode,
        "originalBytes": len(raw),
        "amqpBodyBytes": len(body),
    }))

if __name__ == "__main__":
    main()
运行命令:
export AMQP_URL='amqp://guest:guest@127.0.0.1:5672/%2F'
export S3_BUCKET='app-message-payloads'
python publish_large.py ./payload.json
预期输出;实际字节数取决于文件内容:
{"publishedMode": "object-reference", "originalBytes": <BYTES>, "amqpBodyBytes": <BYTES>}看到 object-reference 表示 Broker 接收的是引用信封而不是原始大文件。消费者必须先限制下载字节数和解压后字节数,再校验 sha256,最后解析内容;校验失败不得确认消息。
Broker 大小限制
RabbitMQ 4.3 的 max_message_size 默认值为 16 MiB,配置允许的最大值为 512 MiB。生产环境通常应设置更低的组织级上限,例如 8 MiB,避免错误客户端直接投递超大消息;该配置需要在各节点保持一致并按变更流程重启或滚动生效。
max_message_size = 8388608该限制触发时消息会被拒绝。不要把提高到数百 MiB 当作长期方案,因为单条消息会放大网络传输、磁盘写入、复制、路由副本和消费者内存占用,可能触发流控或内存告警并阻塞整个发布链路。
失败与清理
- 对象上传成功但 RabbitMQ 发布失败会留下孤儿对象。安全替代是使用 outbox 记录上传状态与发布状态,定时对账清理未被引用的对象,并对发布操作使用幂等键。
- 消费者下载失败、摘要不一致或解压后超限时,有限重试后进入死信队列;禁止立即无限重回原队列,否则会形成高频失败循环。
- 多个消费者共享同一引用时,不能在第一个消费者确认后立即删除对象。应使用对象生命周期策略、引用计数或业务完成事件统一清理。
- 引用信封不得放公开 URL、长期签名地址或明文密钥。使用私有 bucket 和消费者工作负载身份授权,必要时生成短期签名地址。
- 示例为受限的缓冲读取并拒绝超过 64 MiB 的源文件。更大文件应采用流式哈希、流式压缩和分片上传,避免生产者自身因整文件入内存而崩溃。
排障清单
先记录生产者看到的原始大小、压缩后大小和最终 AMQP body 大小,再检查 Broker 是否因 max_message_size 拒绝、对象存储上传是否超时、消费者是否具备读取权限。若节点出现内存或磁盘告警,应立即暂停大消息生产者,降低并发与预取,并核对是否仍有客户端绕过引用方案直接发送大 payload。
查询 messages_ready、messages_unacknowledged、消费者数和消息速率。
查看队列指标
用于快速判断队列是在积压、消费处理中,还是没有消费者。先用 rabbitmqctl 读取当前计数,再用 Management HTTP API 获取发布、投递和确认速率;单次快照只反映当前时刻,趋势判断至少连续采样两到三次。
查看当前计数
在 RabbitMQ 节点上执行,-p 指定虚拟主机。messages 等于 ready 与 unacked 之和,便于快速核对总深度。
VHOST='/'

rabbitmqctl -p "$VHOST" list_queues \
  name type state messages_ready messages_unacknowledged messages consumers
预期输出示例,实际队列名和数值会不同:
name	type	state	messages_ready	messages_unacknowledged	messages	consumers
orders	quorum	running	240	12	252	4
retry classic running 0 0 0 0读取方法:messages_ready 持续增长通常表示入队速度超过有效消费速度;messages_unacknowledged 表示已投递但尚未确认;consumers 为订阅该队列的消费者数量。state 不是 running 时,应先处理队列副本或节点可用性问题。
查看消息速率
速率来自 Management HTTP API,需要启用 rabbitmq_management,并安装 curl 与 jq。示例只请求一个队列,避免拉取全部队列造成不必要的统计开销;执行时 curl 会交互式询问密码。
RMQ_API='http://127.0.0.1:15672'
RMQ_USER='ops'
VHOST='/'
QUEUE='orders'

VHOST_ESCAPED=$(jq -rn --arg value "$VHOST" '$value|@uri')
QUEUE_ESCAPED=$(jq -rn --arg value "$QUEUE" '$value|@uri')

curl -fsS --user "$RMQ_USER" \
  "$RMQ_API/api/queues/$VHOST_ESCAPED/$QUEUE_ESCAPED" |
jq '{
  name,
  messages_ready,
  messages_unacknowledged,
  consumers,
  publish_rate: (.message_stats.publish_details.rate // 0),
  deliver_rate: (.message_stats.deliver_get_details.rate // 0),
  ack_rate: (.message_stats.ack_details.rate // 0)
}'
预期输出示例,速率单位为条/秒,实际值随采样周期变化:
{
  "name": "orders",
  "messages_ready": 240,
  "messages_unacknowledged": 12,
  "consumers": 4,
  "publish_rate": 35.6,
  "deliver_rate": 31.2,
  "ack_rate": 30.8
}
指标速查
| 字段 | 读取方法 |
|---|---|
messages_ready |
尚未投递给消费者的消息;持续上升表示积压扩大。 |
messages_unacknowledged |
已投递但未确认的消息;持续上升应检查处理耗时、确认逻辑和预取值。 |
consumers |
当前消费者数;为 0 时 ready 通常只能继续累积。 |
publish_rate |
进入该队列的近期速率。 |
deliver_rate |
投递给消费者及 basic.get 的合计速率。 |
ack_rate |
消费者确认速率;长期低于投递速率会推高 unacked。 |
常见判断
publish_rate长期高于deliver_rate且 ready 上升:消费能力不足、消费者离线或下游变慢。- ready 接近零但 unacked 上升:消息已经发给消费者,重点检查消费耗时、阻塞、确认遗漏和过大的 prefetch。
- consumers 为零:先确认应用实例、vhost、队列名和权限,不要直接清空队列。
- 三个速率均为零但计数非零:可能当前没有流量,也可能统计未启用或采样尚未形成。
风险与边界
rabbitmqctl 返回的是瞬时计数,不能用一次结果判断故障。Management API 的速率依赖统计采样,近期无活动时相关字段可能缺失,示例用 // 0 兼容这种情况。不要在大集群中高频请求整个 /api/queues 列表;应查询单队列或使用 Prometheus 长期采集。
不要把密码直接写入命令行、脚本仓库或环境变量,否则可能进入 shell 历史、进程列表、崩溃转储或日志。示例让 curl 交互式读取密码;自动化场景应使用权限收紧的凭据文件或密钥管理服务,并使用只读监控账号。
兼容性
命令字段适用于现代 RabbitMQ 3.x 与 4.x。不同版本可先执行 rabbitmqctl help list_queues 核对字段;HTTP 速率需要 Management 插件和可读取目标 vhost 的账号。
找出 unacked 持续增长对应的连接、信道和消费者。
定位未确认消息
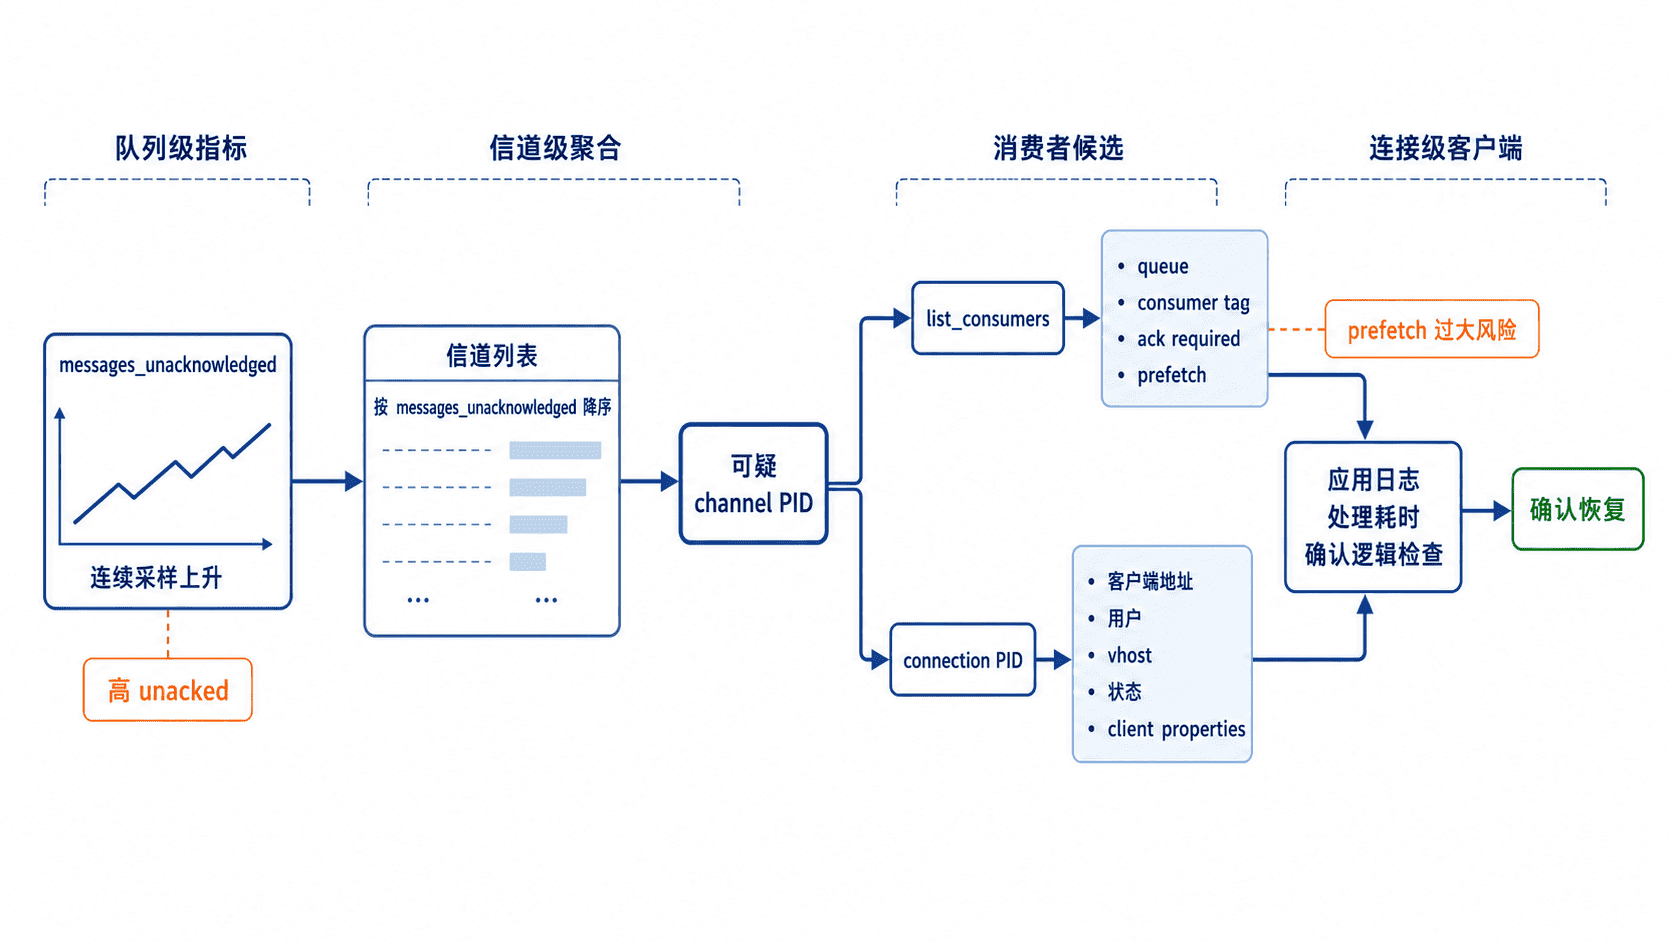
用于找出 messages_unacknowledged 持续增长对应的信道、TCP 连接和消费者。定位顺序是“确认队列趋势 → 按信道找最大 unacked → 用信道 PID 关联消费者 → 用连接 PID 定位客户端”,不要只看单次峰值就重启应用。
确认是否持续增长
先对目标队列连续采样。只有数值持续上升或长期高位不回落,才进入客户端定位;短时接近 消费者数 × prefetch 可能只是正常在途消息。
VHOST='/'
QUEUE='orders'

for sample in 1 2 3; do
  date '+%F %T'
  rabbitmqctl --no-table-headers list_queues -p "$VHOST" \
    name messages_unacknowledged consumers |
  awk -F '\t' -v queue="$QUEUE" '$1 == queue'
  sleep 5
done预期输出示例,<TIME> 和数值按现场变化:
<TIME>
orders	120	4
<TIME>
orders	165	4
<TIME>
orders	213	4
三次采样中消费者数未变而 unacked 连续增加,说明消息已投递到客户端,但处理或确认速度跟不上。
找出可疑信道
messages_unacknowledged 是信道级聚合值。按第七列倒序后,优先检查数值最高且持续不下降的信道,同时记录第一列信道 PID 和第二列连接 PID。
VHOST='/'

rabbitmqctl --no-table-headers list_channels \
  pid connection name user vhost consumer_count \
  messages_unacknowledged prefetch_count |
awk -F '\t' -v vhost="$VHOST" '$5 == vhost' |
sort -t $'\t' -k7,7nr |
head -20
预期输出示例:
<CHANNEL_PID> <CONNECTION_PID> <CHANNEL_NAME> app / 1 180 200该行表示信道有一个消费者、180 条未确认消息、预取上限 200。若 prefetch_count 为 0,表示没有预取上限,更容易在慢消费者上堆积大量在途消息。
关联消费者和连接
把上一步的 PID 逐字填入变量。list_consumers 用信道 PID 找到队列、consumer tag、是否需要确认和 prefetch;list_connections 再用连接 PID 找到客户端地址、账号、vhost、状态及客户端属性。
VHOST='/'
CHANNEL_PID='<CHANNEL_PID>'
CONNECTION_PID='<CONNECTION_PID>'

rabbitmqctl --no-table-headers list_consumers -p "$VHOST" |
awk -F '\t' -v pid="$CHANNEL_PID" '$2 == pid'

rabbitmqctl --no-table-headers list_connections \
  pid name user vhost peer_host peer_port state client_properties |
awk -F '\t' -v pid="$CONNECTION_PID" '$1 == pid'
预期输出示例,端口、PID、consumer tag 和客户端属性会不同:
orders	<CHANNEL_PID>	amq.ctag-<ID>	true	200	[]
<CONNECTION_PID>	10.0.0.25:<PORT> -> 10.0.0.10:5672	app	/	10.0.0.25	<PORT>	running	<CLIENT_PROPERTIES>
第一行确认该信道订阅 orders,使用手动确认且 prefetch 为 200;第二行把问题定位到具体客户端地址和连接。若客户端设置了可读的 connection name,通常可在 client_properties 中进一步对应到应用实例。
排障清单
- 检查消费者日志是否卡在数据库、HTTP 调用、锁等待、线程池或磁盘 I/O。
- 核对成功路径和异常路径是否都执行
ack、nack或reject,以及异常是否被吞掉。 - 对比处理耗时与 prefetch;单条耗时长时先小步降低 prefetch,观察吞吐、内存和 unacked 是否回落。
- 检查消费者是否频繁重连或信道关闭;连接关闭会让未确认消息重新入队并产生 redelivery。
- 多个消费者共享同一信道时,信道级 unacked 无法精确分摊到某个 consumer tag,应结合应用日志、消费耗时指标或改为每消费者独立信道。
风险与边界
不要发现高 unacked 就立即执行 close_connection。关闭连接会同时关闭其全部信道,并把未确认消息重新入队,可能触发重复处理、突发重投和下游雪崩。安全做法是先确认消费者幂等性,暂停或隔离异常实例,降低 prefetch,保存日志和线程栈,再做受控重启。
unacked 高不一定是故障:在稳定吞吐下,它可能长期接近消费者可并行处理的在途窗口。应结合持续时间、ack 速率、处理延迟和 ready 变化判断。CLI 全量扫描信道在超大集群上也有成本,不要以秒级频率长期轮询。
兼容性
示例依赖 Bash 的 $'\t' 语法以及 awk、sort。RabbitMQ 3.x 与 4.x 可用 list_channels、list_consumers 和 list_connections 完成关联;字段有差异时先执行对应的 rabbitmqctl help <command> 核对。
区分生产过快、消费变慢、限流或消费者异常导致的 ready 增长。
排查消息持续积压
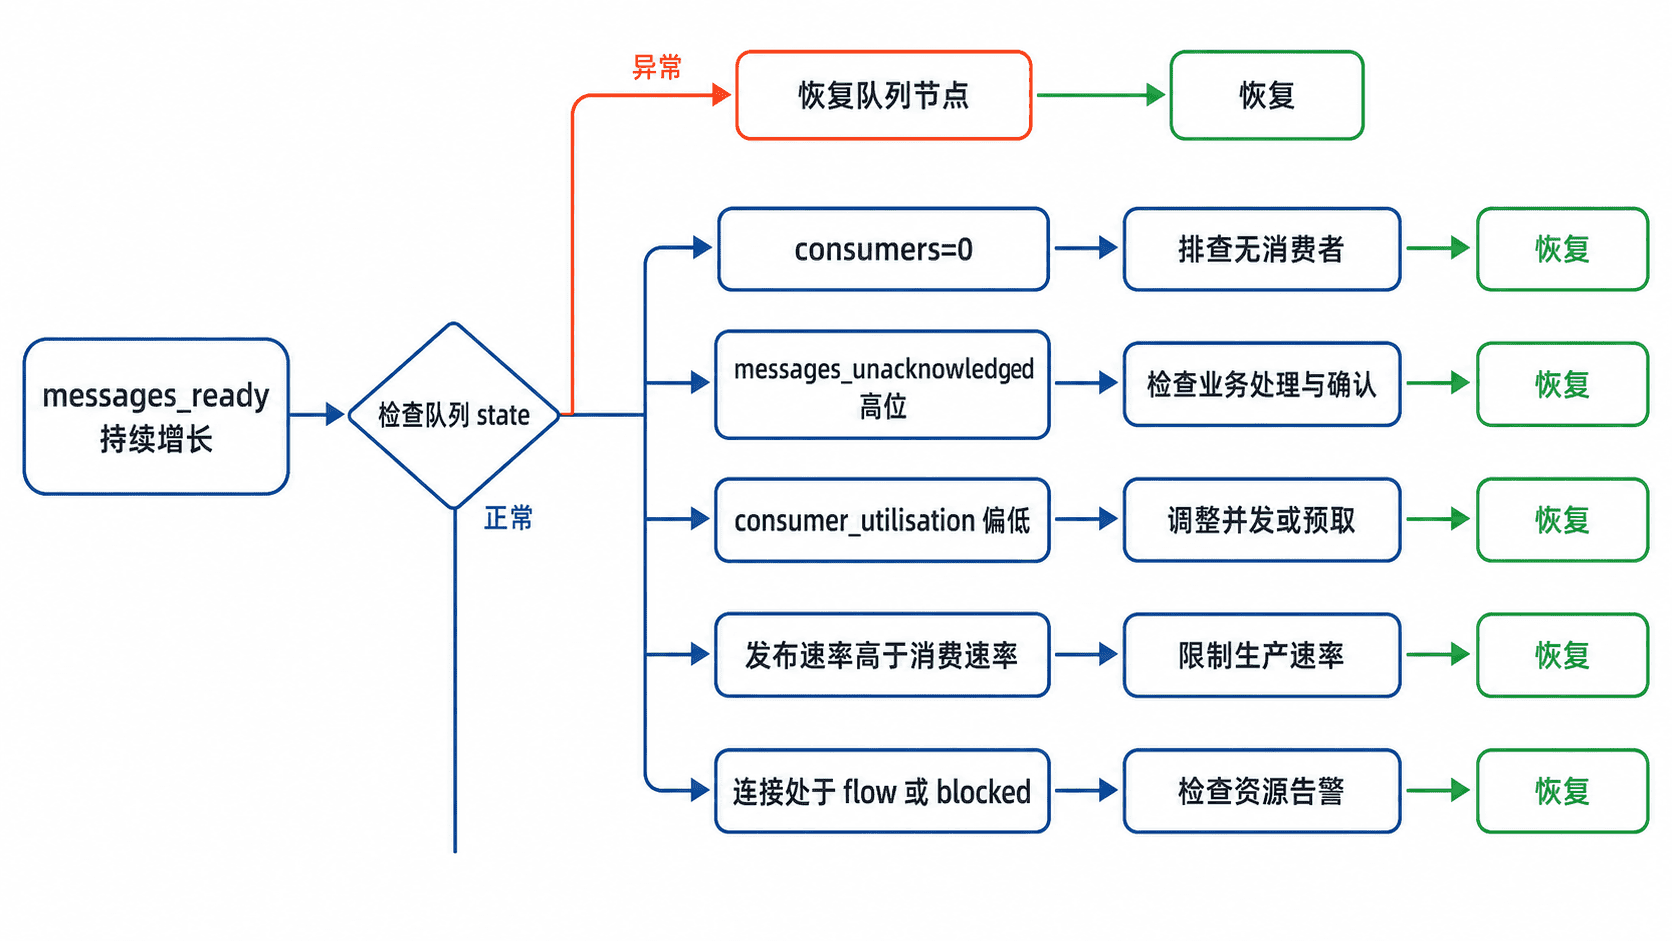
当队列的 messages_ready 持续增长时,先同时观察待投递、未确认、消费者数量和消费能力,再检查发布连接是否被流控。这样可以区分生产过快、消费变慢、确认阻塞、消费者掉线或节点异常,避免一上来就清空队列或盲目扩容。
快速采样
在 RabbitMQ 节点上执行;远程节点需补充 -n <NODE>,并确保 CLI 使用与目标节点一致的 Erlang Cookie。
rabbitmqctl list_queues -p "<VHOST>" name type state messages_ready messages_unacknowledged consumers consumer_utilisation预期输出
Listing queues for vhost <VHOST> ...
name	type	state	messages_ready	messages_unacknowledged	consumers	consumer_utilisation
<QUEUE>	quorum	running	<READY_COUNT>	<UNACKED_COUNT>	<CONSUMER_COUNT>	<UTILISATION>
<READY_COUNT> 等实际值随采样时刻变化。间隔 30~60 秒重复执行:messages_ready 表示尚未投递的消息,messages_unacknowledged 表示已投递但未确认的消息,consumers 为订阅数,consumer_utilisation 取值为 0~1,用于判断增加消费者或调整预取是否可能提升投递能力。
分型定位
ready持续上升、consumers=0:没有有效订阅,转入“队列无消费者”排查。ready上升、unacknowledged较低、消费者存在且利用率偏低:消费处理、网络、并发数或预取值限制了吞吐。unacknowledged长时间高位:消息已到消费者,但业务处理、下游依赖、线程池或确认逻辑变慢、阻塞或异常。- 队列
state不是running:先处理队列领导者不可用、节点故障或同步过程,应用扩容通常无效。 - 消费速率正常但发布速率更高:属于容量不匹配,应先限速生产端,再按下游承载能力增加消费者。
检查流控和资源告警
rabbitmqctl list_connections name user vhost state channels send_pend
rabbitmq-diagnostics alarms
预期输出
name	user	vhost	state	channels	send_pend
<CONNECTION>	<USER>	<VHOST>	flow	<CHANNEL_COUNT>	<SEND_PENDING>
<RESOURCE_ALARM_OR_EMPTY>
发布连接为 flow 表示 RabbitMQ 正在主动降速,通常说明队列、磁盘写入或副本复制跟不上;blocking 或 blocked 还要重点检查内存、磁盘告警。流控是保护机制,不应只通过重连生产者消除。
排障清单
- 对齐同一时间窗口的发布速率、投递速率、确认速率和积压增量,确认增长发生在哪一段。
unacknowledged高时,检查消费者处理耗时、错误率、GC、线程池、数据库与外部接口,并确认异常路径最终会ack、nack或关闭通道。- 消费者存在但吞吐不足时,先小步增加实例或并发;每次调整后观察积压斜率和下游负载,不只看消费者数量。
- 出现资源告警或队列非运行状态时,先恢复磁盘、内存、网络和队列领导者,再处理业务吞吐。
- 恢复标准是
ready不再增长并持续下降,同时确认业务错误率、重投递率和下游延迟没有恶化。
风险与边界
直接执行 purge_queue、删除队列或批量 nack requeue=true 会在积压期间造成数据丢失、重投递风暴或顺序破坏。安全替代方案是先暂停或限速生产端,保留消息统计和样本,再逐步扩容消费者;只有业务明确允许丢弃时才清理消息。
一次性大幅提高预取或消费者并发,会把积压转移到客户端内存、数据库或第三方接口,导致 OOM、锁竞争和级联故障。应按小步增量调整,并以处理延迟、错误率、未确认数和下游容量作为停止条件。
确认消费者进程、vhost、队列名、权限和订阅状态。
排查队列无消费者
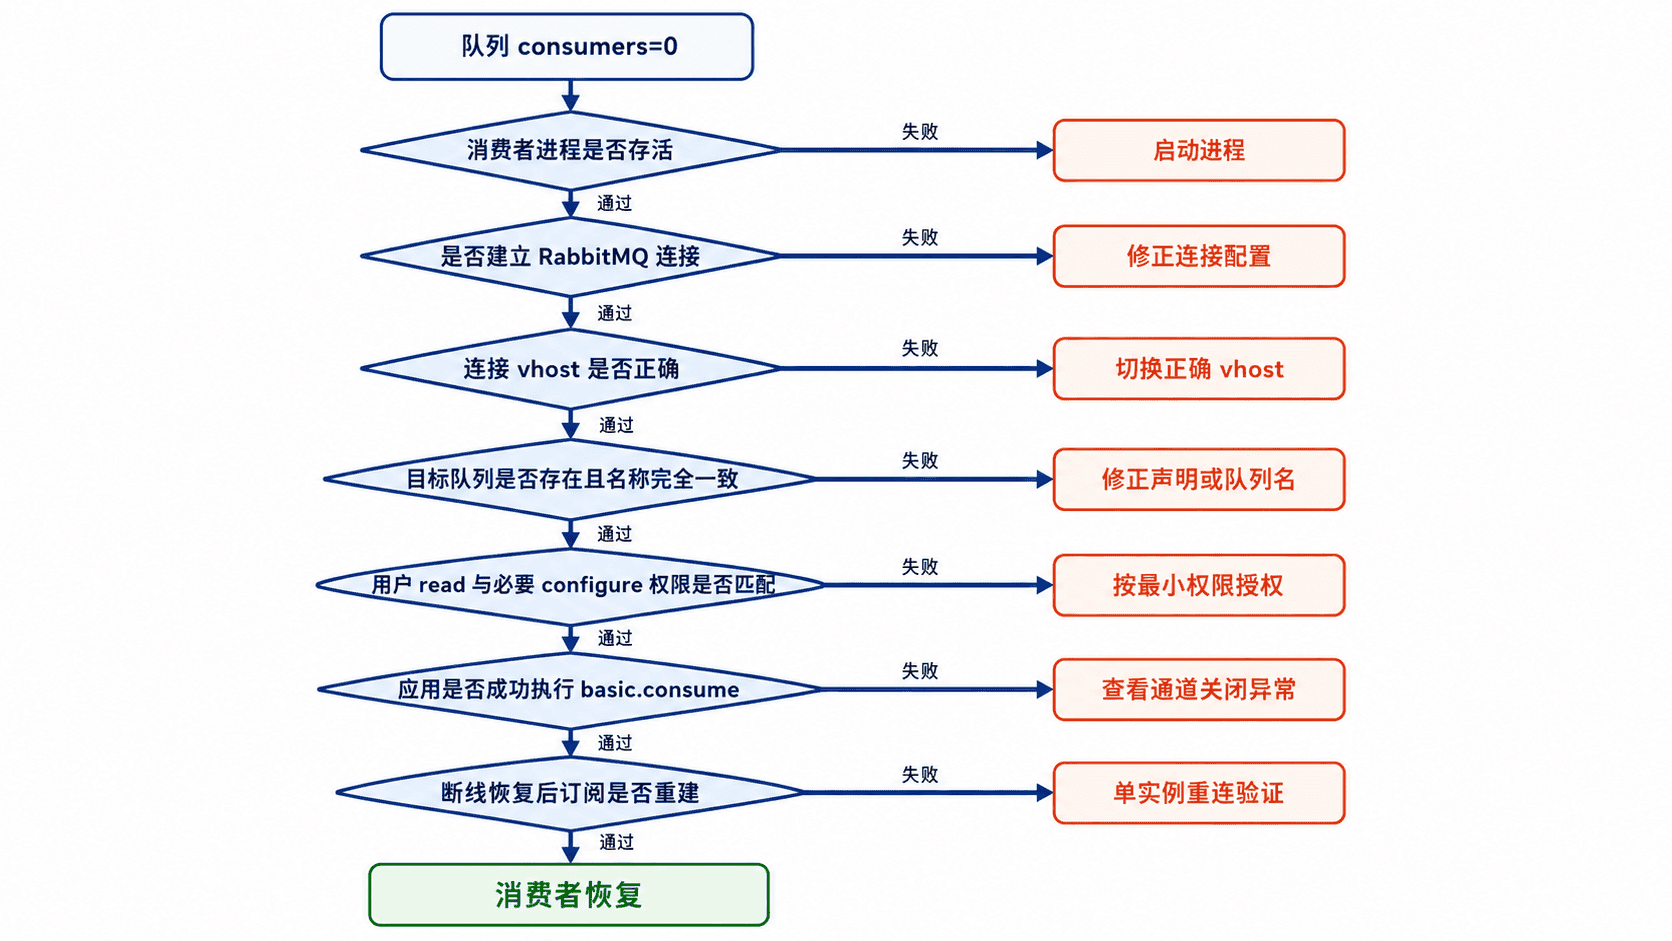
当队列 consumers 为 0 时,按“进程是否运行 → 是否连接正确 vhost → 队列名是否一致 → 用户权限是否匹配 → 是否真正执行订阅”逐层检查。最终以 list_consumers 出现目标队列的订阅行作为恢复依据,而不是只看应用进程存活。
确认队列和订阅现状
rabbitmqctl list_queues -p "<VHOST>" name type state consumers messages_ready messages_unacknowledged
rabbitmqctl list_consumers -p "<VHOST>"
预期输出
name	type	state	consumers	messages_ready	messages_unacknowledged
<QUEUE>	quorum	running	0	<READY_COUNT>	0

queue_name	channel_pid	consumer_tag	ack_required	prefetch_count	arguments
目标队列行存在且 consumers=0,同时消费者列表只有表头或没有 <QUEUE> 行,才是 broker 视角的“无订阅”。若队列不存在,优先检查 vhost、队列名大小写、声明流程和自动删除属性。
检查进程和连接
先确认消费者进程不是退出、反复重启或仅启动了 Web/API 组件。
pgrep -af "<CONSUMER_PROCESS_PATTERN>"
printf 'exit=%s\n' "$?"

rabbitmqctl list_connections name user vhost state channels
预期输出
<PID> <CONSUMER_COMMAND>
exit=0

name	user	vhost	state	channels
<CONNECTION>	<USER>	<VHOST>	running	<CHANNEL_COUNT>
exit=1 表示没有匹配进程。进程存在但没有对应连接时,检查连接地址、DNS、端口、TLS、认证和启动日志;连接存在但 vhost 不符时,修正应用配置。集群环境中 list_connections 只反映目标节点上的连接,必要时对各节点执行或使用集群监控数据核对。
核对权限和订阅错误
rabbitmqctl list_user_permissions "<USER>"预期输出
vhost	configure	write	read
<VHOST>	<CONFIGURE_REGEX>	<WRITE_REGEX>	<READ_REGEX>
消费已有队列至少要求 read 正则匹配队列名;应用若还会声明、删除或修改队列,需要相应 configure 权限。权限存在但仍无消费者时,搜索应用日志中的 ACCESS_REFUSED、NOT_FOUND、PRECONDITION_FAILED、通道关闭、独占消费者冲突和订阅回调异常。进程存活并不代表 basic.consume 已成功。
常见根因
- 应用连接到了默认
/,而队列位于其他 vhost;或 URI 中 vhost 编码、环境变量、Profile 配置不一致。 - 队列名大小写、前后缀或租户标识不一致,消费者订阅了另一个同名模式队列。
- 启动开关关闭了消费模块,健康检查已通过但工作线程没有创建订阅。
- 被动声明目标队列失败后通道关闭,应用只恢复了连接,没有恢复通道和消费者。
- 队列为自动删除或独占队列,连接断开后已删除并重新生成,生产者仍向旧拓扑发送。
验证恢复
修复后重新执行:
rabbitmqctl list_queues -p "<VHOST>" name consumers messages_ready
rabbitmqctl list_consumers -p "<VHOST>"
预期输出
name	consumers	messages_ready
<QUEUE>	<CONSUMER_COUNT_GT_0>	<READY_COUNT>

queue_name	channel_pid	consumer_tag	ack_required	prefetch_count	arguments
<QUEUE>	<CHANNEL_PID>	<CONSUMER_TAG>	true	<PREFETCH_COUNT>	[]
除订阅数大于 0 外,还应确认 messages_ready 开始下降、消费者持续确认消息,并且没有连接重连循环或通道关闭日志。
风险与边界
为快速恢复而直接授予 .* 全权限,会扩大误删、误声明和跨队列访问范围。安全替代方案是让 read、write、configure 正则只匹配该应用需要的资源,并先在单个实例上验证。
同时重启全部消费者会触发重连风暴、未确认消息回队列和重复消费。应先重启一个实例,确认订阅行出现且处理正常,再滚动恢复其他实例;清空队列不会解决无消费者问题,只会造成不可逆的数据丢失。