
消息队列 / 知识点
RabbitMQ 开发与排障手册
手册条目
识别内存高水位、分页和连接阻塞,并安全降低压力。
处理 RabbitMQ 内存告警
用于 rabbitmq-diagnostics alarms 报告内存告警、管理界面出现 Memory alarm,或生产端发布与 confirm 延迟突然升高的场景。目标是先找出告警节点和主要内存类别,再通过限制入口、保持消费、减少未确认消息与连接泄漏让水位回落,而不是先把阈值调高。
告警影响与判断重点
内存水位是触发发布限流的阈值,不是进程的硬上限;超过阈值后,告警会传播为集群级保护,发布连接进入 blocking 或 blocked,纯消费连接仍可继续取消息并确认。RabbitMQ 4.3 文档中的默认阈值约为可用内存的 60%,而 3.13 文档为约 40%,必须以当前版本的有效配置为准。:contentReference[oaicite:0]{index=0}
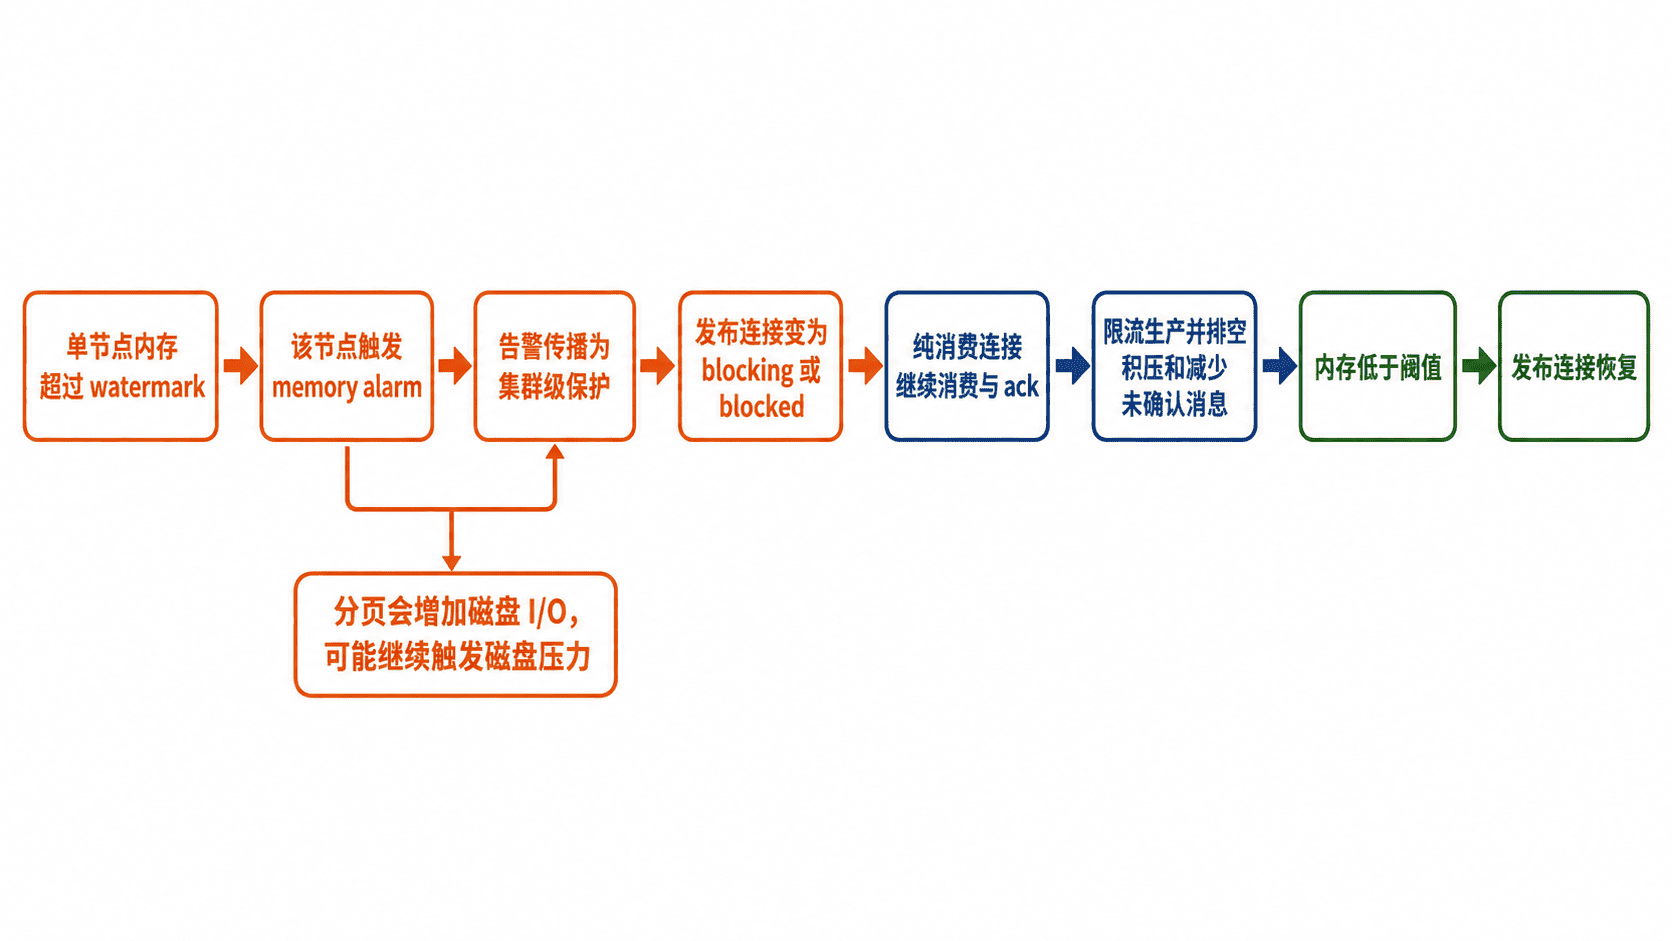
state=flow 通常表示瞬时背压,不等同于资源告警;state=blocked 与集群告警同时出现时,才优先按内存或磁盘保护处理。混合生产与消费的同一连接也可能整体受阻,因此关键消费者最好不要与高流量生产者复用连接。
快速诊断
在发生告警的节点执行以下命令;集群使用长节点名时补充 --longnames 或 -n rabbit@<NODE>。memory_breakdown 应作为定位内存来源的第一步,输出值是采样近似值。:contentReference[oaicite:1]{index=1}
rabbitmq-diagnostics -q alarms
rabbitmq-diagnostics -q memory_breakdown --unit MB
rabbitmqctl -q list_connections name state channels send_pend
rabbitmqctl -q list_channels connection consumer_count messages_unacknowledged messages_unconfirmed prefetch_count
预期输出
<当前集群资源告警列表;无告警时为空>
connection_other: 50.18 mb (22.1%)
allocated_unused: 43.7058 mb (19.25%)
name	state	channels	send_pend
<CONNECTION>	blocked	<CHANNELS>	<SEND_PEND>
connection	consumer_count	messages_unacknowledged	messages_unconfirmed	prefetch_count
<CONNECTION_PID>	<CONSUMERS>	<UNACKED>	<UNCONFIRMED>	<PREFETCH>
connection_* 高通常指向连接或通道数量、TCP 缓冲及客户端泄漏;queue_procs、binary 或队列副本相关类别高,通常与消息体、积压或副本状态有关;messages_unacknowledged 高说明消息已投递但未确认,过大的 prefetch_count 会放大消费者侧和 Broker 侧压力。
安全降压顺序
- 先暂停、降速或按租户限流生产端,避免客户端在阻塞后无上限重试;保留消费者运行,让已入队消息继续被处理和确认。
- 检查未确认消息和消费延迟。若
messages_unacknowledged持续增大,先修复卡住的消费者,再降低新消费者的 prefetch;不要批量关闭通道造成大规模 requeue。 - 若连接或通道类别占比最高,按应用名、用户和来源地址识别泄漏连接,分批关闭并修复连接池;不要直接执行全量关闭连接。
- 若队列或二进制内存占比最高,扩容消费者或临时降低入口速率。只有获得业务确认后才能清空队列;默认做法是排空而不是 purge。
- 若运行在容器中且 RabbitMQ 识别到的可用内存与 cgroup 限额不一致,再评估绝对阈值。绝对值必须为 Erlang VM、内核页缓存、插件和突发留出余量。
持久配置示例用于容器内存上限为 6 GiB、评审后决定在 4 GiB 触发保护的场景。配置文件变更需按部署方式滚动重启并重新验证,不要在告警期间盲目上调。
vm_memory_high_watermark.absolute = 4GiB生效行为与验证:节点重启后在 rabbitmq-diagnostics status 或管理 API 中确认有效 mem_limit,并持续观察 RSS、队列积压和告警状态;绝对阈值是容器环境的优先选择,因为节点不一定总能正确识别 cgroup 限额。:contentReference[oaicite:2]{index=2}
风险与恢复验证
直接提高阈值会在真实内存压力下推迟保护,后果可能是 OOM Killer 终止节点、队列副本重选和连接风暴;安全替代是先限流入口、排空积压、修复泄漏或增加内存。重启节点只能暂时释放内存,并可能把负载和副本恢复压力转移到其他节点,除非已确认滚动容量,否则不要把重启当作首选。
内存分页会把压力转移到磁盘,磁盘空间或 I/O 已紧张时可能进一步触发磁盘告警。恢复后必须确认集群告警为空、连接不再处于 blocked,且内存曲线持续下降而非只在阈值附近反复抖动。
if [ -z "$(rabbitmq-diagnostics -q alarms)" ]; then
  echo "CLUSTER_ALARMS=none"
else
  echo "CLUSTER_ALARMS=present"
fi
rabbitmqctl -s list_connections state | sort | uniq -c
预期输出
CLUSTER_ALARMS=none
<COUNT> running
若仍出现 blocked、内存持续上升或告警短时间反复触发,继续检查生产速率、消费确认、连接泄漏和磁盘 I/O,不要仅依赖一次命令成功判断恢复。
检查磁盘余量、磁盘空闲阈值和持久化写入压力。
处理 RabbitMQ 磁盘告警
用于 rabbitmq-diagnostics alarms 报告磁盘告警、生产端被阻塞,或 Broker 数据盘可用空间接近 disk_free_limit 的场景。处理目标是准确定位 RabbitMQ 数据目录所在分区,先停止空间继续恶化,再安全回收非业务文件、排空积压或扩容磁盘。
触发机制与业务影响
当数据目录所在分区的可用空间低于阈值时,节点触发磁盘告警;任一集群节点触发后,整个集群都会阻塞发布连接,纯消费连接可继续工作。RabbitMQ 4.3 的默认绝对阈值为 50 MB,但官方明确要求生产环境重新评估;阈值过低时,快速分页仍可能在两次检查之间耗尽磁盘并导致节点终止。:contentReference[oaicite:3]{index=3}
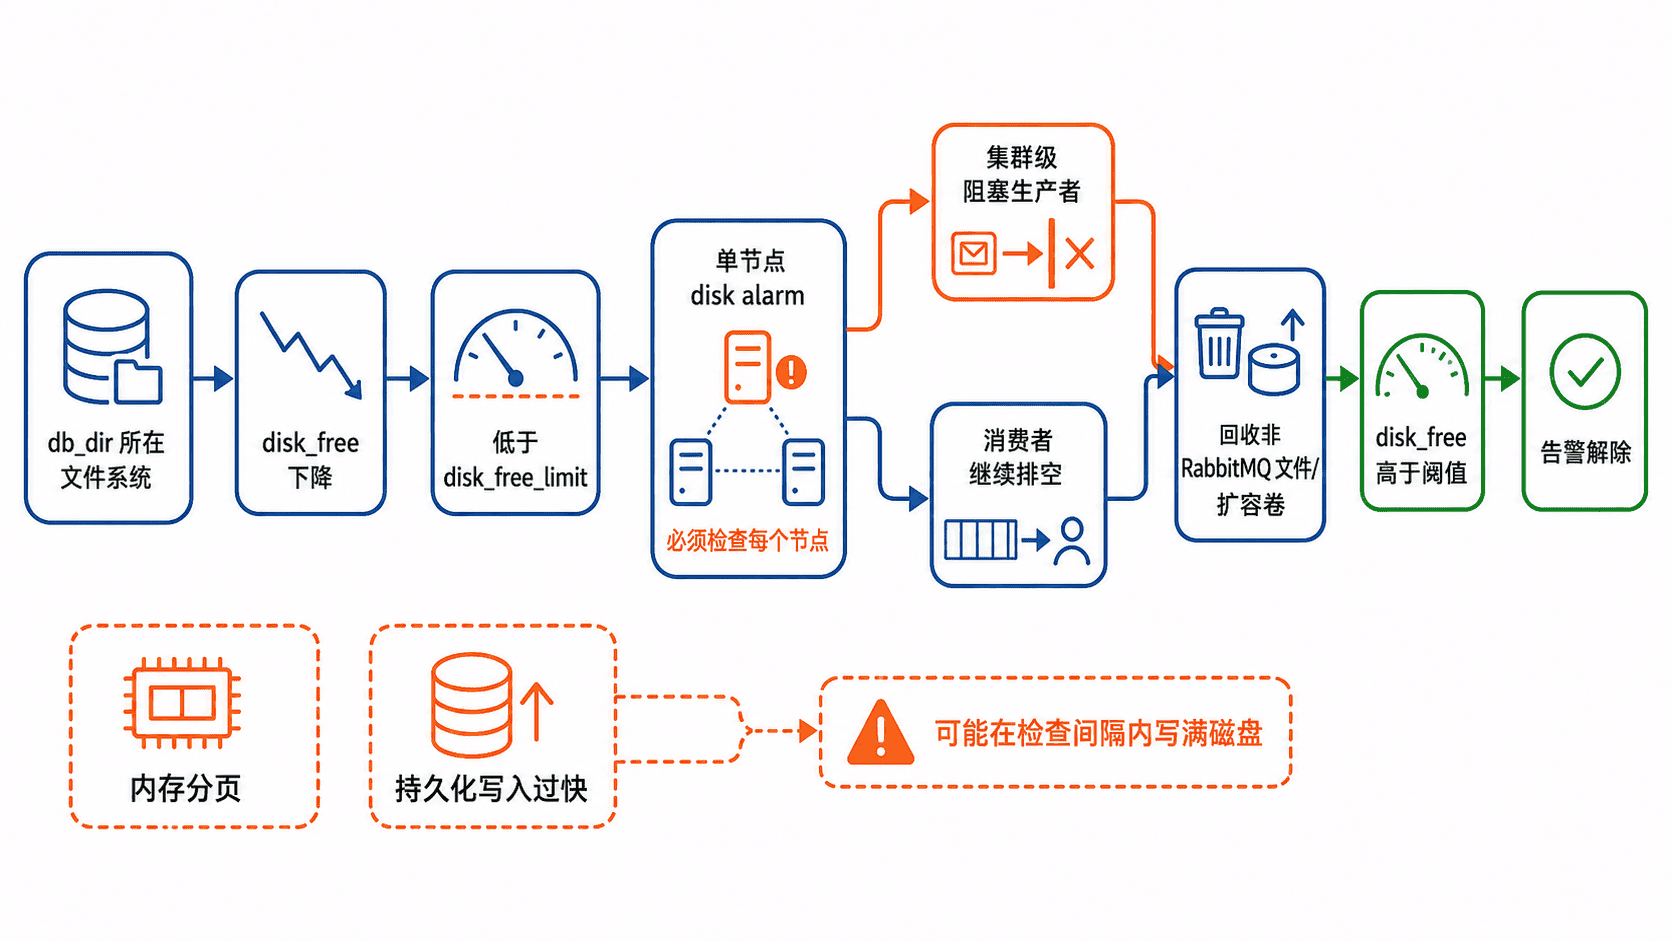
告警监控的是 db_dir 所在文件系统,不是你当前登录目录或主机上空间最大的分区。必须逐节点检查 disk_free、disk_free_limit、disk_free_alarm 和 db_dir;只看集群总容量可能漏掉单节点数据盘满的问题。
定位数据盘与占用来源
以下示例依赖已启用 management 插件、jq,以及具有监控权限的账号。先设置凭据,再读取所有节点的数据库目录和阈值;随后将 <DB_DIR> 替换为目标节点返回的路径,检查文件系统与一级目录占用。HTTP API 字段含义由 RabbitMQ 官方定义。:contentReference[oaicite:4]{index=4}
export RMQ_USER='<MONITOR_USER>'
export RMQ_PASS='<MONITOR_PASSWORD>'

curl -fsS -u "$RMQ_USER:$RMQ_PASS" \
  http://127.0.0.1:15672/api/nodes \
  | jq -r '.[] | [.name, .db_dir, .disk_free, .disk_free_limit, .disk_free_alarm] | @tsv'

df -B1 '<DB_DIR>'
sudo du -xhd1 '<DB_DIR>' | sort -h
sudo lsof +L1 | sort -k7 -n | tail -n 20
预期输出
rabbit@<NODE>	<DB_DIR>	<FREE_BYTES>	<LIMIT_BYTES>	true
Filesystem	1B-blocks	Used	Available	Use%	Mounted on
<DEVICE>	<SIZE_BYTES>	<USED_BYTES>	<FREE_BYTES>	<USE_PERCENT>	<MOUNT>
<SIZE>	<DB_DIR>/<SUBDIR>
<PROCESS> <PID> <USER> <FD> <FILE_TYPE> <DEVICE> <DELETED_BYTES> <DELETED_FILE>读取方法:disk_free_alarm=true 且 disk_free < disk_free_limit 表示该节点已触发告警;df 用于确认实际分区余量;du 用于定位目录占用;lsof +L1 可发现文件已删除但仍被进程占用的空间,这类空间通常要在对应进程安全重启或关闭文件后才会归还。
management 插件不可用时,先用 rabbitmq-diagnostics -q alarms 确认资源告警,再从 rabbitmq-diagnostics status、部署清单或环境配置中找到数据目录,最后对该目录执行同样的 df 和 du 检查。
安全释放压力
先在应用侧暂停或降低发布速率,避免阻塞期间形成高频重试风暴;消费者应继续运行以排空可消费消息。然后优先清理同一文件系统上的非 RabbitMQ 文件,例如确认过保留策略的旧日志、core dump、临时包和备份副本,清理前先记录文件路径、大小与责任人。
若主要空间来自 RabbitMQ 数据,先恢复卡住的消费者并降低新消息入口。Quorum Queue 与 Stream 的段文件回收可能滞后于消费确认,不能因为队列深度下降就假设磁盘立即释放;应持续观察 disk_free 趋势。空间无法在安全窗口内回收时,扩容卷通常比降低告警阈值更可靠。
生产配置应使用易于推理的绝对阈值,并给消息分页、WAL、段合并、日志和运维操作留出余量。下面只表示配置格式,具体值必须根据写入峰值、恢复时间和卷容量评审。
disk_free_limit.absolute = 10GB生效行为与验证:配置重启后,当可用空间低于 10 GB 时触发保护。运行时命令 rabbitmqctl set_disk_free_limit 只保持到下次节点重启,因此需要长期生效时必须同步修改配置文件;绝对阈值优先于相对阈值。:contentReference[oaicite:5]{index=5}
禁止操作与边界
不要在节点运行时手工删除 db_dir 下的队列、消息存储、WAL、索引或 Stream 段文件;触发条件是发现这些目录占用很大,直接删除的后果可能是数据损坏、队列不可用或节点无法启动,安全替代是通过消费者排空、受控删除业务已确认可丢弃的队列,或按官方恢复流程处理。
不要把阈值临时降到当前可用空间以下来“解除”告警。这样只会关闭保护,持久化写入、分页或日志仍可把磁盘写满,最终造成写失败和节点终止;安全替代是限流、清理非业务文件、扩容卷,或把工作负载迁移到具备容量的集群。
du 明显小于 df 已用空间时,优先检查已删除但仍打开的文件、文件系统保留块、快照和容器层。清理日志时不要删除当前正在写入的文件;应使用日志轮转、truncate 的既定运维流程或安全重启持有文件句柄的进程。
恢复确认
空间回升后,至少连续观察一个业务峰值周期;只要任一节点仍有告警,集群发布仍可能受阻。以下命令用集群告警列表和 API 字段共同确认恢复。
if [ -z "$(rabbitmq-diagnostics -q alarms)" ]; then
  echo "CLUSTER_ALARMS=none"
else
  echo "CLUSTER_ALARMS=present"
fi

curl -fsS -u "$RMQ_USER:$RMQ_PASS" \
  http://127.0.0.1:15672/api/nodes \
  | jq -r '.[] | [.name, .disk_free, .disk_free_limit, .disk_free_alarm] | @tsv'
预期输出
CLUSTER_ALARMS=none
rabbit@<NODE>	<FREE_BYTES_ABOVE_LIMIT>	<LIMIT_BYTES>	false
若 disk_free_alarm 已变为 false 但可用空间仍持续下降,应继续保留入口限流并排查写入速率、积压、分页、日志和未释放文件;不要在刚越过阈值时立即恢复满速生产。
识别 memory 或 disk alarm 触发的 connection.blocked 状态。
排查连接被阻塞
当生产者发布突然卡住、超时,或客户端收到 connection.blocked 时,先确认是否由内存或磁盘资源告警触发,再区分短暂的 flow 流控。资源告警只暂停发布方向;集群中任一节点触发告警,都可能让全部节点上的发布连接进入阻塞。:contentReference[oaicite:0]{index=0}
快速定位
在 RabbitMQ 节点上以具备 Erlang Cookie 访问权限的系统用户执行。先查集群告警,再列出连接状态;alarms 无输出表示当前没有资源告警。
rabbitmq-diagnostics -q alarms
rabbitmqctl -q list_connections name peer_host peer_port user vhost state channels send_pend
预期输出示例:
Resource alarm on node rabbit@mq-1: memory
name                                      peer_host  peer_port  user  vhost  state    channels  send_pend
10.0.2.10:5672 -> 10.0.3.21:<PORT>        10.0.3.21 <PORT>     app   /      blocked  4         0
主机名、端口和连接名会不同。看到 memory 或 disk 即可确认资源告警;state=blocked 表示该连接已经尝试发布并被暂停。send_pend 是套接字发送队列大小,只用于判断网络写出是否堆积,不能单独证明资源告警。连接字段及状态值由 list_connections 返回。:contentReference[oaicite:1]{index=1}
状态判读
| 状态 | 含义 | 处理方向 |
|---|---|---|
running |
正常收发 | 继续查客户端超时、网络或确认机制 |
flow |
发布速度暂时超过节点处理能力 | 查队列复制、磁盘 I/O、消费者速度和发布速率 |
blocking |
告警已生效,但连接尚未继续发布 | 处理告警节点,不要等待连接自行恢复 |
blocked |
发布已被暂停 | 先清告警,再验证客户端收到 connection.unblocked |
blocking 与 blocked 都可能由资源告警产生;纯消费连接通常不会被阻塞,消费仍可继续。为了避免生产和消费相互影响,生产者与消费者宜使用独立连接。:contentReference[oaicite:2]{index=2}
按告警类型处理
先收集证据,不要立即修改水位线。内存告警重点看内存分类和积压队列;磁盘告警重点看 RabbitMQ 数据目录所在文件系统,而不是只看根分区。
rabbitmq-diagnostics -q memory_breakdown
rabbitmqctl -q list_queues -p / name messages_ready messages_unacknowledged memory
df -h /var/lib/rabbitmq
预期结果示例:
<内存分类及占用>
name    messages_ready  messages_unacknowledged  memory
orders  <READY>         <UNACKED>                <BYTES>
Filesystem      Size  Used  Avail  Use%  Mounted on
/dev/<DEVICE>   <SIZE> <USED> <AVAIL> <PERCENT> /var/lib/rabbitmq
内存告警优先限流生产者、恢复或扩容消费者、处理异常积压,并在确认容量不足后增加内存。磁盘告警优先清理同文件系统中的无关文件、扩容卷或迁移数据目录;禁止直接删除 /var/lib/rabbitmq 下的队列、Mnesia 或 Raft 文件。集群告警是全局生效的,因此必须逐节点确认告警来源。:contentReference[oaicite:3]{index=3}
验证恢复
所有资源告警清除后,check_alarms 返回零;连接应从 blocked 或 blocking 回到 running。用条件输出固定结果,便于脚本和人工核对。
if rabbitmq-diagnostics -q check_alarms; then
  echo "ALARMS=clear"
else
  echo "ALARMS=active"
fi
rabbitmqctl -q list_connections name state
预期输出:
ALARMS=clear
name                                      state
10.0.2.10:5672 -> 10.0.3.21:<PORT>        running
如果告警已清除但应用仍卡住,检查客户端是否实现阻塞/解除阻塞监听、发布调用超时和自动恢复;必要时在客户端侧重建连接。发布操作在告警期间可能超时或失败,应用应使用 Publisher Confirms 判定哪些消息真正被 RabbitMQ 接收。:contentReference[oaicite:4]{index=4}
风险与边界
不要为快速解封而盲目提高 vm_memory_high_watermark 或降低 disk_free_limit。触发条件是节点已接近内存或磁盘安全边界;继续放宽可能导致 OOM、磁盘写满、节点退出或数据风险。安全替代方案是先降发布速率、恢复消费、释放或扩充资源,再依据容量模型调整阈值。
不要在根因未消除时反复重启节点。重启会中断连接并增加队列恢复、索引加载或副本同步压力;集群内其他节点的告警仍会继续阻塞发布。确认所有节点资源恢复后,再按滚动方式处理客户端或节点重连。
检查 fd 使用量、系统限制和连接数量。
排查文件描述符不足
当日志出现 Too many open files、新连接被拒绝,或节点连接数持续增长时,先比较 RabbitMQ 实际使用量与进程上限,再定位连接泄漏、短连接风暴或过低的服务限制。RabbitMQ 接近可用文件描述符上限时会拒绝新连接,每个客户端连接至少占用一个文件句柄。:contentReference[oaicite:5]{index=5}
快速定位
rabbitmq-diagnostics status 的 File Descriptors 区段同时给出总句柄和套接字的使用量与上限。使用量持续接近上限,且伴随连接失败或相关日志时,才可判定为文件描述符瓶颈。
rabbitmq-diagnostics -q status | sed -n '/File Descriptors/,+4p'预期输出示例:
File Descriptors

Total: 64210, limit: 65439
Sockets: 58000, limit: 58893
Total 包含套接字及 RabbitMQ 打开的其他文件;Sockets 主要对应网络连接。示例已接近上限,剩余余量不足以承受重连峰值。实际值会随 Erlang 版本、节点负载和系统预留量变化。RabbitMQ 官方安装文档也建议通过 rabbitmq-diagnostics status 验证有效限制。:contentReference[oaicite:6]{index=6}
核对运行进程限制
不要只在当前终端执行 ulimit -n,因为 systemd 服务可能使用不同限制。应读取 RabbitMQ Erlang VM 的真实 PID 和 /proc/<PID>/limits;该操作通常需要 root 或 rabbitmq 用户权限。
pid=$(rabbitmq-diagnostics -q status | awk '/OS PID:/ {print $3; exit}')
echo "PID=$pid"
grep -E '^Max open files' "/proc/$pid/limits"
find "/proc/$pid/fd" -maxdepth 1 -type l | wc -l
cat /proc/sys/fs/file-max
预期输出示例:
PID=<PID>
Max open files            65536                65536                files
64210
<KERNEL_FILE_MAX>
第二行依次是进程软限制和硬限制;第三行是当前进程已打开描述符数量;最后一行是内核系统级上限。系统级上限必须高于 RabbitMQ 进程上限,且修改限制不会追溯到已经运行的进程。:contentReference[oaicite:7]{index=7}
定位连接来源
先按客户端 IP 和用户聚合连接,确认是否由单个应用实例、连接池配置或重连风暴造成。-s 抑制表头,便于直接使用 Unix 工具统计。
rabbitmqctl -s list_connections peer_host user | sort | uniq -c | sort -nr | head -n 20

rabbitmqctl -q list_connections name peer_host user vhost state channels
预期输出示例:
<COUNT> 10.0.3.21 app
<COUNT> 10.0.3.22 app
name                                      peer_host  user  vhost  state    channels
10.0.2.10:5672 -> 10.0.3.21:<PORT>        10.0.3.21 app   /      running  <CHANNELS>
同一来源连接数单调增长,通常表示连接未关闭;连接创建和关闭速率都很高,则更像短连接或重连风暴。优先修复客户端:复用长连接、限制连接池、设置指数退避并避免每条消息新建连接。连接泄漏最终会耗尽句柄并增加节点内存。:contentReference[oaicite:8]{index=8}
调整 systemd 限制并验证
以下示例适用于使用 systemd 管理的 Linux 安装。65536 可作为常见起点,生产值应按峰值连接数、队列数量和增长余量计算;官方生产建议至少预留约 50K,并给出“连接数高分位乘 2,再加队列数”的保守估算。:contentReference[oaicite:9]{index=9}
sudo install -d -m 0755 /etc/systemd/system/rabbitmq-server.service.d
sudo tee /etc/systemd/system/rabbitmq-server.service.d/limits.conf >/dev/null <<'EOF'
[Service]
LimitNOFILE=65536
EOF

sudo systemctl daemon-reload
sudo systemctl restart rabbitmq-server
systemctl show rabbitmq-server -p LimitNOFILE
rabbitmq-diagnostics -q status | sed -n '/File Descriptors/,+4p'
预期结果:
LimitNOFILE=65536
File Descriptors

Total: <USED>, limit: <EFFECTIVE_LIMIT>
Sockets: <SOCKETS>, limit: <SOCKET_LIMIT>
只有重启后的 Erlang VM 才会获得新限制。若上限配置超过 65536,还需核对 ERL_MAX_PORTS,否则 Erlang 运行时端口上限可能先成为瓶颈。:contentReference[oaicite:10]{index=10}
风险与边界
提高限制只解决容量不足,不能修复连接泄漏。触发条件是连接数持续增长或高频重连;只扩上限会延后故障,并增加内存和监控开销。安全替代方案是先修复连接生命周期,再根据正常峰值扩容或拆分节点。
重启服务会断开该节点上的客户端连接,并可能触发队列领导者切换或副本恢复。生产集群应先确认副本健康和容量,再逐节点滚动重启;不要直接关闭 /proc/<PID>/fd 下的句柄,也不要通过杀死 beam.smp 释放资源。
容器环境的限制通常由宿主机或容器运行时注入,修改宿主机 shell 的 ulimit 不一定影响现有容器;Windows 主要受 ERL_MAX_PORTS 控制。无论平台如何,都应以节点内的 rabbitmq-diagnostics status 和进程实际限制作为最终验证。:contentReference[oaicite:11]{index=11}
通过连接列表、channel 数量和客户端生命周期定位资源泄漏。
排查连接与信道泄漏
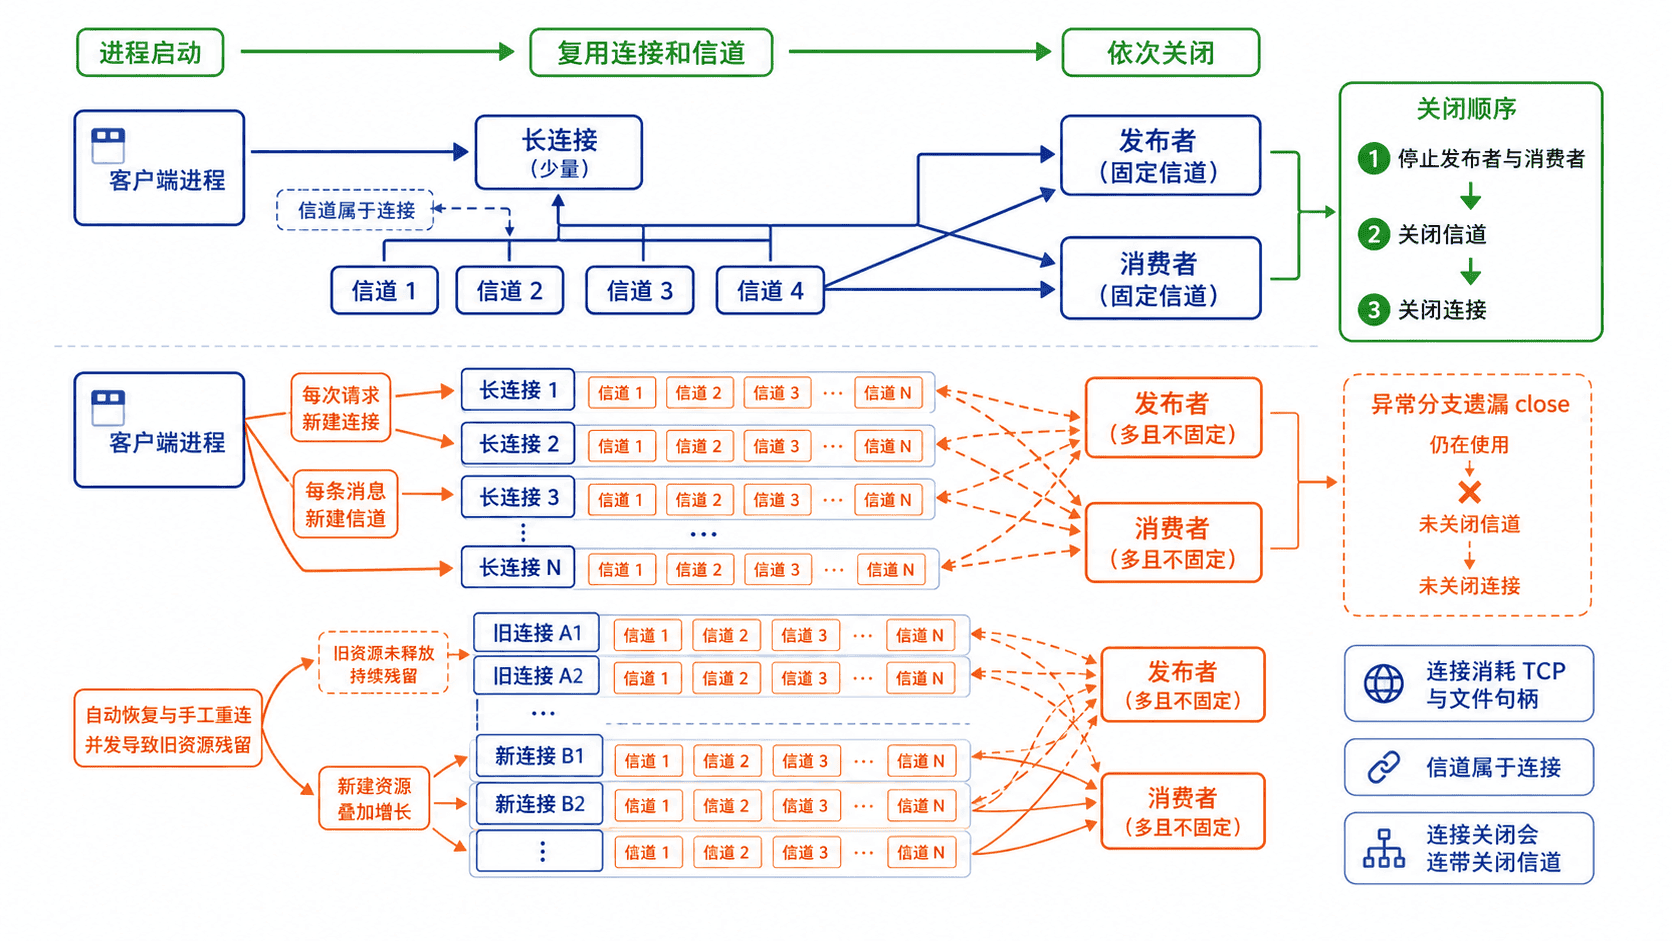
当 RabbitMQ 的连接数或信道数持续上升、节点文件句柄与内存同步增长,并且重启客户端后只短暂恢复时,用本条目定位泄漏来源。先找出连接数或信道数异常集中的应用实例,再区分“资源未关闭”与“频繁创建后正常关闭”的高抖动。
命令定位
先按连接查看信道数量、连接上限、状态和建立时间。pid 是后续关联信道的关键字段,connected_at 为时间戳,实际值会因版本和节点而异。
rabbitmqctl -q list_connections \
  pid name user vhost channels channel_max state connected_at
预期输出:
pid                         name                                      user       vhost   channels  channel_max  state    connected_at
<rabbit@mq-1.1234.0>        10.20.0.15:<PORT> -> 10.20.0.8:5672       order_app  /prod   184       2047         running  <TIME_MS>
<rabbit@mq-2.2781.0>        10.20.0.16:<PORT> -> 10.20.0.9:5672       order_app  /prod   12        2047         running  <TIME_MS>
第一行在同类实例中明显偏高,应继续按其 pid 检查信道。批量环境可按第五列倒序,只看信道最多的连接:
rabbitmqctl -q --no-table-headers list_connections \
  pid name user vhost channels |
  sort -t $'\t' -k5,5nr |
  head -20
预期输出:
<rabbit@mq-1.1234.0>    10.20.0.15:<PORT> -> 10.20.0.8:5672    order_app    /prod    184
<rabbit@mq-2.2781.0>    10.20.0.16:<PORT> -> 10.20.0.9:5672    order_app    /prod    12
再把可疑连接映射到具体信道,判断它们是否承载消费者、未确认消息或发布确认。
LEAK_PID='<rabbit@mq-1.1234.0>'

rabbitmqctl -q --no-table-headers list_channels \
  connection number user vhost consumer_count \
  messages_unacknowledged messages_unconfirmed prefetch_count |
  awk -v pid="$LEAK_PID" '$1 == pid'
预期输出:
<rabbit@mq-1.1234.0>    1    order_app    /prod    1    20    0    20
<rabbit@mq-1.1234.0>    2    order_app    /prod    0    0    0    0
<rabbit@mq-1.1234.0>    3    order_app    /prod    0    0    0    0
大量长期空闲信道通常指向信道未关闭;大量带未确认消息的信道则要同时排查消费处理、确认回调或发布确认积压。
判断泄漏还是高抖动
- 连接泄漏:应用实例数稳定,但同一用户、来源地址或连接名的连接总数持续单调增长,旧连接长期保留;每条连接可能只有少量信道。
- 信道泄漏:连接数基本稳定,少数连接的
channels持续增长并逼近channel_max;list_channels中不断出现新的信道编号。 - 连接或信道抖动:当前总量大致稳定,但打开率和关闭率同时很高。常见原因是按请求创建资源、异常导致信道被协议关闭,或重连循环过于激进。
- 正常扩容:连接和信道随应用实例数、工作线程数同步增加,缩容后会回落,并且每个实例的数量分布接近。
单次快照不能证明泄漏。至少间隔采样数次,确认总量趋势、打开与关闭速率,以及异常是否集中在同一个应用实例。
客户端生命周期核对
- 一个服务进程通常复用长连接或使用有上限的连接池,不应为每次发布、每条消息或每个 HTTP 请求创建 TCP 连接。
- 信道应按工作线程、消费者或有界池复用;异常路径也必须执行关闭。使用语言提供的
try/finally、上下文管理器或资源托管接口。 - 启用客户端自动恢复后,不要再由多个定时任务并发创建替代连接。手工重连必须有单一所有者,并在替换前关闭旧资源。
- 为连接设置可读名称,至少包含应用、实例和用途,例如
order-worker/pod-7/consume,否则只能依赖来源 IP 和用户定位。 - 检查连接池借出后未归还、线程退出但信道仍被池引用、消费者重建后旧订阅未取消等生命周期缺口。
风险与边界
直接关闭可疑连接会同时关闭其全部信道;未确认投递通常会被重新入队,发布中的请求可能失败,业务若未做幂等可能出现重复处理。安全做法是先摘除异常实例流量并正常停机;只有资源即将耗尽时才按单个连接隔离,并同步观察重投递和客户端恢复。
单纯调高 channel_max、文件句柄或节点内存只会推迟故障,不能修复泄漏。大型集群上反复执行全量列表命令也会增加控制面开销,排障时采用低频快照,长期趋势交给 Prometheus 或管理指标。
排障清单
- 对比连接总数、信道总数与应用实例数,确认增长是否合理。
- 用
list_connections找出连接数或信道数异常集中的用户、来源和连接。 - 用连接
pid关联list_channels,区分空闲信道、消费信道和发布确认积压。 - 检查客户端创建、异常、重连、缩容和停机路径是否都能关闭资源。
- 修复后做滚动重启,验证连接与信道数量回落,并持续观察打开率与关闭率是否重新平衡。
- 字段在不同 RabbitMQ 版本可能略有差异,可用
rabbitmqctl help list_connections与rabbitmqctl help list_channels核对当前节点支持项。
结合消费速率、处理时长、prefetch 和 consumer capacity 定位瓶颈。
排查慢消费者
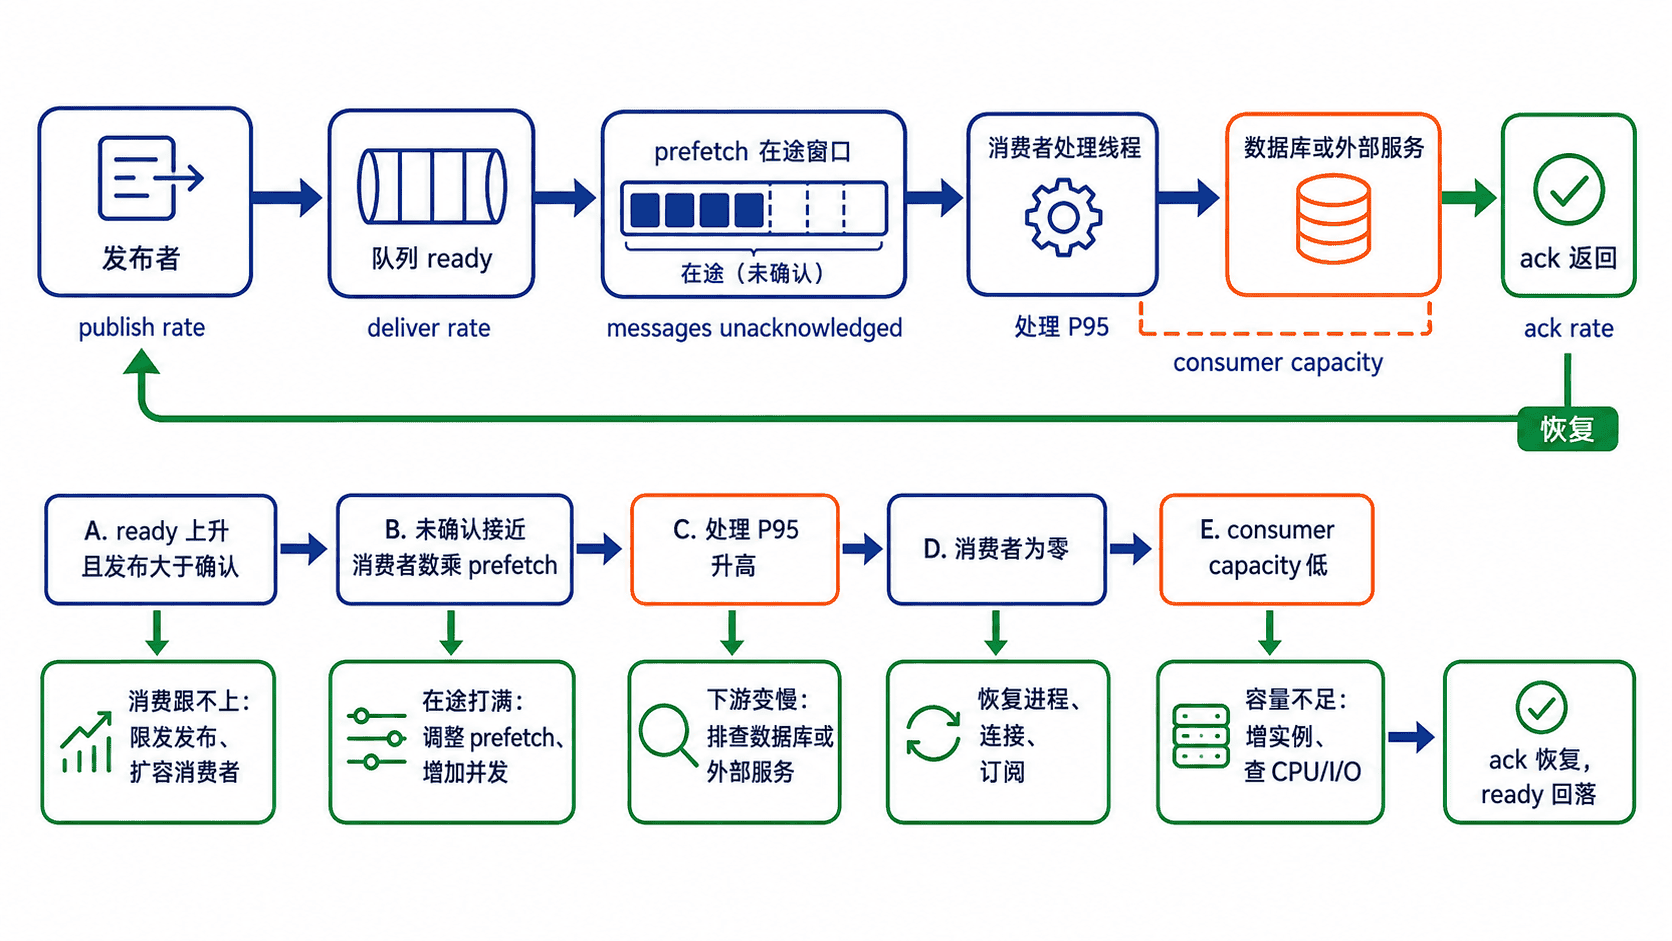
当队列 messages_ready 持续增长、消费者仍在线但端到端延迟升高时,用本条目判断瓶颈来自处理函数、下游依赖、消费者并发、prefetch 或确认时机。关键是连续采样发布速率、投递与确认速率、未确认数和 consumer capacity,而不是只看某一时刻的队列长度。
快速取数
管理 HTTP API 能一次取得队列深度、消费者数、速率和 capacity。下面假设已启用 management 插件,监控账号对目标 vhost 有读取权限;根 vhost 必须编码为 %2F。
export RMQ_API='http://127.0.0.1:15672'
export RMQ_USER='monitor'
export RMQ_PASS='<PASSWORD>'
export VHOST='%2F'
export QUEUE='orders'

curl -sS -u "$RMQ_USER:$RMQ_PASS" \
  "$RMQ_API/api/queues/$VHOST/$QUEUE" |
jq '{
  queue: .name,
  consumers,
  messages_ready,
  messages_unacknowledged,
  consumer_capacity: (.consumer_capacity // .consumer_utilisation // null),
  publish_rate: (.message_stats.publish_details.rate // 0),
  deliver_rate: (.message_stats.deliver_get_details.rate // 0),
  ack_rate: (.message_stats.ack_details.rate // 0)
}'
预期输出:
{
  "queue": "orders",
  "consumers": 4,
  "messages_ready": 12840,
  "messages_unacknowledged": 800,
  "consumer_capacity": 0.42,
  "publish_rate": 320.0,
  "deliver_rate": 180.0,
  "ack_rate": 175.0
}
速率是近期采样结果,实际值会随统计周期变化。这个示例中发布速率长期高于确认速率,ready 持续增长,说明消费端净吞吐不足;consumer_capacity 低于 1 只是扩容或调优提示,不等同于消费者 CPU 使用率。
读取信号
publish_rate > ack_rate且messages_ready连续上升:消费者整体吞吐赶不上入口,先查处理时长和下游容量。messages_unacknowledged接近“在线消费者数 × 每消费者 prefetch”,同时 ready 大于零:在途窗口已满。处理线程忙时是业务或下游慢;线程空闲时再怀疑 prefetch 太小、网络阻塞或调度问题。deliver_rate明显高于ack_rate,未确认数持续增长:消息已经送达,但处理或确认延迟,重点查看消费者线程栈、超时、锁竞争和数据库调用。- 消费者数为零:这是消费者缺失、订阅失败或恢复失败,不是普通的“处理较慢”。
- consumer capacity 接近
1且没有消息流时不代表压测能力充足;该指标在空闲队列上只能说明当前可立即投递。
连续采样三到五个统计周期再下结论。短时突发、批量确认或自动扩缩容都可能让单点速率产生误导。
核对消费者 prefetch
从消费者 API 读取每个订阅的连接、信道、确认模式、prefetch 和 active 状态,确认框架配置是否真正落到 RabbitMQ。
curl -sS -u "$RMQ_USER:$RMQ_PASS" \
  "$RMQ_API/api/consumers/$VHOST" |
jq '.[] |
  select(.queue.name == env.QUEUE) |
  {
    consumer_tag,
    connection: .channel_details.connection_name,
    channel: .channel_details.number,
    ack_required,
    prefetch_count,
    active
  }'
预期输出:
{
  "consumer_tag": "orders-worker-1",
  "connection": "order-worker/pod-7/consume",
  "channel": 1,
  "ack_required": true,
  "prefetch_count": 200,
  "active": true
}若同一队列存在多个对象,应逐个比较。active: false 可能与 Single Active Consumer、消费者故障检测或等待接管有关;不要把注册数量直接当作实际并行处理数量。
处理时长与并发估算
可用近似关系估算最低并行槽位:峰值到达速率 × P95 处理秒数。例如入口为每秒 320 条、P95 处理时间为 0.05 秒,最低约需 16 个并行处理槽位,实际还要为抖动、GC、网络和下游尾延迟留余量。
prefetch 决定每个消费者允许保留多少条未确认消息,不直接等于处理线程数。prefetch 太小会让线程在网络往返间等待;太大则增加内存、失败后的集中重投递和消费者之间的不公平。应小步调整,每次同时观察吞吐、P95/P99、未确认数和进程内存。
高频处置
- 处理函数或下游慢:先优化数据库索引、外部接口超时、锁竞争和序列化;必要时拆分长任务。业务成功后再确认,并保证幂等。
- 并发不足:逐步增加消费者实例或处理线程,但先确认数据库、缓存和第三方接口能承受新增并发;需要严格顺序或启用 Single Active Consumer 时,横向扩容可能不会增加有效吞吐。
- prefetch 太小:在保持手动确认的前提下逐级提高,观察线程是否减少空闲以及 ready 斜率是否下降。不要直接设为
0,因为它表示无限制的未确认投递。 - 确认阻塞:检查批量确认边界、信道线程安全、异常分支和重试循环,避免消息处理完成后迟迟不 ack。
风险与排障清单
盲目增加消费者可能把瓶颈转移到数据库或外部服务,造成级联超时;盲目增大 prefetch 会扩大未确认窗口,实例崩溃时形成重投递洪峰。安全做法是一次只改变一个变量,设置下游并发上限,并以 backlog 斜率、处理延迟、错误率和内存作为验收指标。
排障时依次确认:消费者确实在线且 active;发布、投递、确认速率的长期关系;ready 与 unacknowledged 的变化;每个订阅的 prefetch;应用 P50/P95/P99 处理时长;数据库与外部依赖耗时。修复后应看到 ack_rate 接近或超过 publish_rate,ready 开始持续下降,而不是仅在某个瞬间清零。
临时启用 tracing 或 Firehose,确认消息经过的交换机与队列。
跟踪消息流向
当消息已经发布但消费者未收到、路由键是否命中不确定时,在指定节点和 vhost 临时开启 Firehose。它把发布和投递事件复制到系统交换机 amq.rabbitmq.trace,可看到业务消息进入哪个交换机,以及最终由哪个队列交付给消费者。
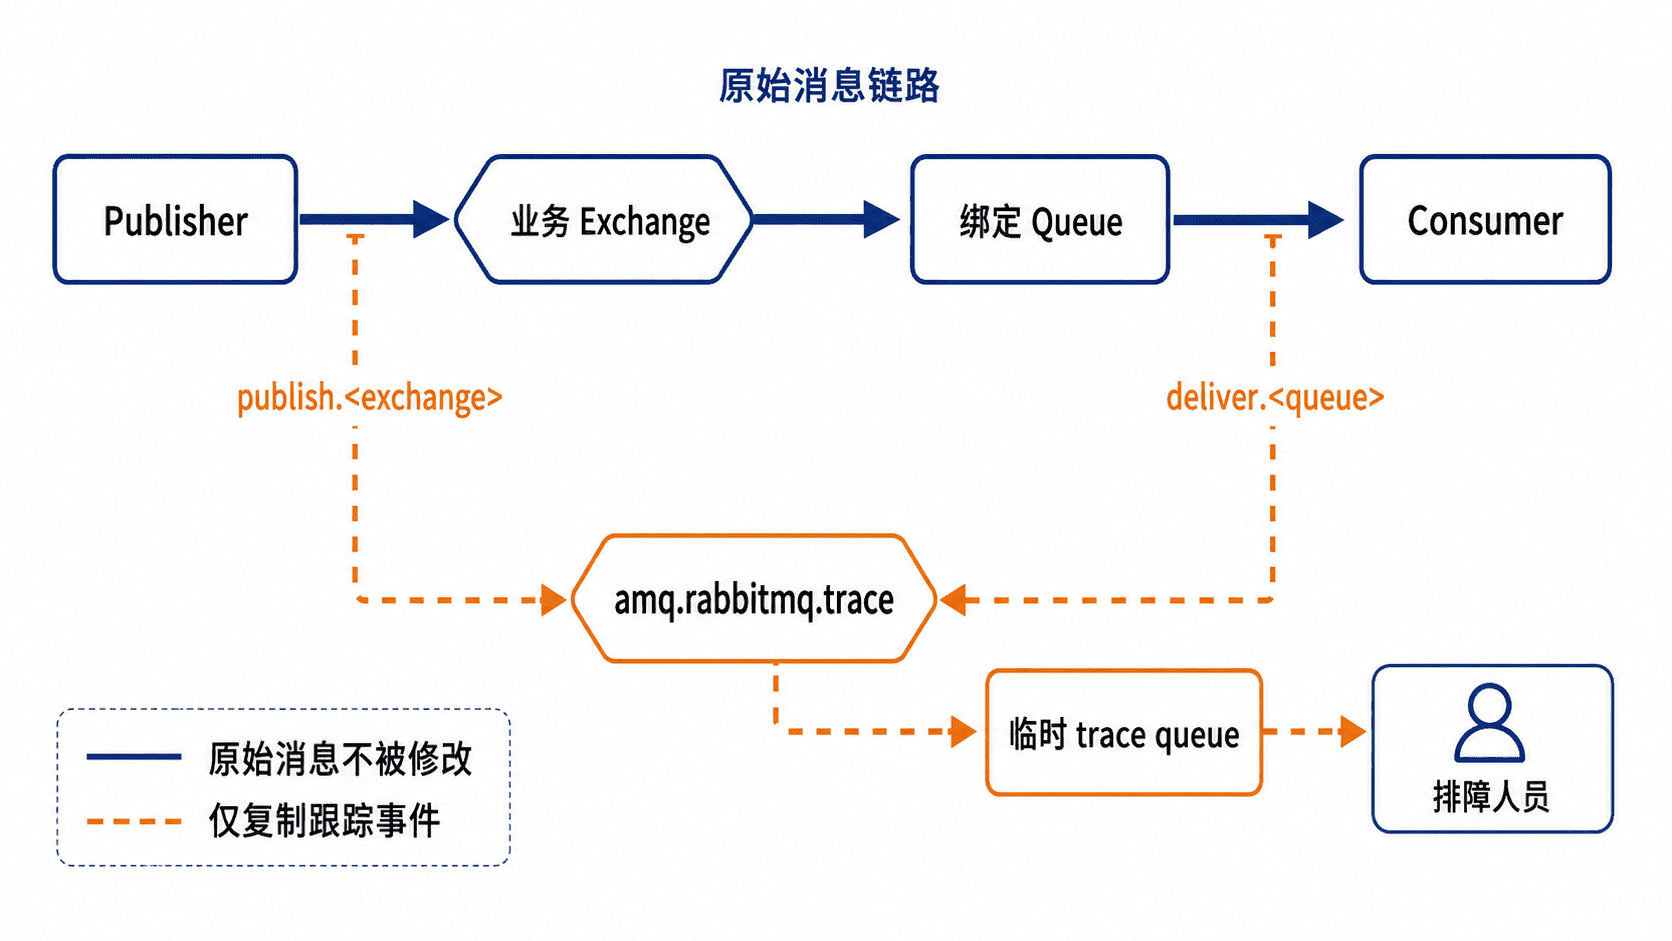
命令定位
Firehose 按节点、按 vhost 生效。集群中先确认消息实际经过的节点;默认 vhost 为 /,远程节点用 -n rabbit@<NODE> 指定。直接消费 amq.rabbitmq.trace 不要求启用 rabbitmq_tracing 插件;需要在管理界面保存 text 或 JSON 跟踪文件时再启用该插件。
完整跟踪流程
以下脚本依赖 Management 插件、curl 和 jq。它先创建 10 分钟闲置过期的 classic 临时队列,再开启 Firehose;即使脚本中断,trap 也会尽力关闭跟踪并删除队列。默认 vhost / 在 HTTP API 路径中编码为 %2F。
#!/usr/bin/env bash
set -euo pipefail

API='http://127.0.0.1:15672'
AUTH='<USER>:<PASSWORD>'
VHOST_NAME='/'
VHOST_ENC='%2F'
NODE='rabbit@<NODE>'
TRACE_QUEUE='trace.tmp'

cleanup_best_effort() {
  sudo rabbitmqctl -n "$NODE" trace_off -p "$VHOST_NAME" >/dev/null 2>&1 || true
  curl -fsS -u "$AUTH" -X DELETE \
    "$API/api/queues/$VHOST_ENC/$TRACE_QUEUE" >/dev/null 2>&1 || true
}
trap cleanup_best_effort EXIT

# 先建队列和绑定,避免开启 Firehose 后丢失最早的跟踪事件。
curl -fsS -u "$AUTH" -H 'content-type: application/json' \
  -X PUT "$API/api/queues/$VHOST_ENC/$TRACE_QUEUE" \
  -d '{"auto_delete":true,"durable":false,"arguments":{"x-queue-type":"classic","x-expires":600000}}' >/dev/null
curl -fsS -u "$AUTH" -H 'content-type: application/json' \
  -X POST "$API/api/bindings/$VHOST_ENC/e/amq.rabbitmq.trace/q/$TRACE_QUEUE" \
  -d '{"routing_key":"#","arguments":{}}' >/dev/null

sudo rabbitmqctl -n "$NODE" trace_on -p "$VHOST_NAME" >/dev/null
echo TRACE_ENABLED
read -r -p '重现一次业务消息后按 Enter 继续...'

curl -fsS -u "$AUTH" -H 'content-type: application/json' \
  -X POST "$API/api/queues/$VHOST_ENC/$TRACE_QUEUE/get" \
  -d '{"count":20,"ackmode":"ack_requeue_false","encoding":"auto","truncate":4096}' |
jq -r '.[] | [
  .routing_key,
  (.properties.headers.exchange_name // "-"),
  ((.properties.headers.routing_keys // []) | join(",")),
  .payload
] | @tsv'

sudo rabbitmqctl -n "$NODE" trace_off -p "$VHOST_NAME" >/dev/null
curl -fsS -u "$AUTH" -X DELETE \
  "$API/api/queues/$VHOST_ENC/$TRACE_QUEUE" >/dev/null
trap - EXIT
echo TRACE_DISABLED_AND_QUEUE_REMOVED
预期输出示例,实际交换机、队列、路由键和载荷会不同:
TRACE_ENABLED
重现一次业务消息后按 Enter 继续...
publish.<EXCHANGE>	<EXCHANGE>	<ROUTING_KEY>	<PAYLOAD>
deliver.<QUEUE>	<EXCHANGE>	<ROUTING_KEY>	<PAYLOAD>
TRACE_DISABLED_AND_QUEUE_REMOVED
输出读取
publish.* 表示消息进入节点;deliver.* 表示消息已从对应队列交付给消费者。只有 publish.* 时,继续检查绑定、队列 messages_ready、消费者数量和权限;没有任何事件时,优先确认节点、vhost、绑定模式和问题重现时间是否一致。
# 会收集该 vhost 的全部发布与投递事件。已知目标时,把绑定键改为 publish.<EXCHANGE> 或 deliver.<QUEUE>。ack_requeue_false 只删除跟踪副本,不会确认或删除原业务消息;truncate 仅限制 HTTP API 返回的载荷长度。
风险与边界
高吞吐节点上长时间使用 # 会额外生成、路由和保存大量跟踪消息,可能增加 CPU、网络、磁盘和队列堆积;跟踪载荷还可能包含订单、令牌或个人信息。安全做法是限定单个节点和 vhost、缩小绑定模式、只覆盖一次问题复现窗口,并在结束后确认已执行 trace_off 和删除临时队列。
Firehose 状态不会在节点重启后保留。它能证明消息发布和向消费者交付的路径,但不能替代 publisher confirm、mandatory return、队列指标和客户端消费日志;需要判断“已入队但尚未投递”时,应结合 messages_ready、messages_unacknowledged 与 consumers 查看。
按节点启动、连接、认证、资源告警和队列错误过滤日志。
查看与过滤 RabbitMQ 日志
当节点启动失败、连接被关闭、认证拒绝、资源告警或队列声明报错时,先定位实际日志输出,再按时间和错误类别缩小范围。不要直接在整个日志目录中盲目搜索,否则轮转文件、旧节点日志和多行异常会混在一起。
定位日志输出
优先让 RabbitMQ 返回当前节点的日志位置,不要假设一定是 /var/log/rabbitmq。容器通常写标准输出;仅启用控制台日志时,rabbitmq-diagnostics log_tail 可能返回 enoent,此时改查容器日志或 systemd journal。
LOG_PATH=$(sudo rabbitmq-diagnostics -q log_location)
printf 'LOG_PATH=%s\n' "$LOG_PATH"
预期输出示例,实际节点名和路径可能不同:
LOG_PATH=/var/log/rabbitmq/rabbit@<NODE>.log集群排查远程节点时,在诊断命令前加 -n rabbit@<NODE>;使用长节点名的集群还需加 --longnames。
按故障类别过滤
下面一次覆盖启动、连接、认证、资源告警和常见队列或频道异常。log_tail 读取当前节点最近 5000 行,不需要直接访问日志文件。
PATTERN='Time to start RabbitMQ|Starting broker|failed to start|accepting AMQP connection|closing AMQP connection|authentication failure|access to vhost .* refused|memory resource limit alarm|disk resource limit alarm|PRECONDITION_FAILED|NOT_FOUND|RESOURCE_LOCKED|channel error'

sudo rabbitmq-diagnostics log_tail -N 5000 2>&1 |
  grep -Eai "$PATTERN"
预期输出示例,时间、连接 ID、地址和用户名均为动态值:
<TIME> [info] accepting AMQP connection <CLIENT_IP>:<PORT> -> <SERVER_IP>:5672
<TIME> [error] user '<USER>' - access to vhost '<VHOST>' refused
<TIME> [warning] memory resource limit alarm set on node rabbit@<NODE>
<TIME> [error] Channel error on connection <CONNECTION_ID>: operation queue.declare caused a channel exception precondition_failed
读取时先按同一时间段和连接 ID 串联事件。authentication failure 指身份校验失败;access to vhost ... refused 指用户已识别但没有 vhost 权限;PRECONDITION_FAILED 常见于同名队列或交换机的 durable、exclusive、auto-delete、类型或参数不一致。
按时间窗口查看 systemd 日志
节点由 systemd 管理且日志写入 journal 时,先限制最近 30 分钟,再应用同一类关键词。这样能避免旧启动记录干扰当前故障。
sudo journalctl -u rabbitmq-server \
  --since '30 min ago' --no-pager -o short-iso |
grep -Eai 'failed to start|accepting AMQP connection|closing AMQP connection|authentication failure|access to vhost .* refused|resource limit alarm|PRECONDITION_FAILED|NOT_FOUND|RESOURCE_LOCKED|channel error'
预期输出示例:
<TIME> <HOST> rabbitmq-server[<PID>]: <LOG_MESSAGE>没有结果时先去掉 grep 确认该时间窗是否有原始日志;需要异常上下文时给 grep 增加 -C 3,避免只看到错误首行而漏掉后续原因。
临时提高日志级别
只有现有 info 日志不足、且能快速复现问题时才临时切到 debug。运行前记录原日志级别,复现一次后立即恢复;下面以常见的 info 为恢复值。
sudo rabbitmqctl set_log_level debug >/dev/null

# 只复现一次目标问题,避免在高流量期间持续采集 debug。
echo REPRODUCE_ONCE

sudo rabbitmqctl set_log_level info >/dev/null
echo LOG_LEVEL_RESTORED
预期输出:
REPRODUCE_ONCE
LOG_LEVEL_RESTORED
运行时修改是临时的,节点重启后不会保留。高流量或磁盘余量不足时开启 debug,可能导致日志暴增、I/O 抖动、轮转加快并淹没有效错误;安全替代方案是先用时间窗、节点名、连接 ID 和错误码过滤,只有仍缺证据时才短时提升级别。
排障清单
- 启动问题先看最早的
failed to start、配置文件路径、端口占用和 Erlang cookie 错误,不要只看最后一行退出信息。 - 连接问题对齐客户端时间、源 IP、目标端口和连接 ID;频繁
closing AMQP connection还需查看心跳、TLS 握手和客户端主动关闭。 - 认证与授权分开判断:密码或证书失败查认证,vhost、资源或 topic 被拒绝查 permissions。
- 内存或磁盘 alarm 出现时同时查看告警设置和清除时间;告警未清除前发布会受流控,单纯重连客户端不能解决。
NOT_FOUND、RESOURCE_LOCKED、PRECONDITION_FAILED优先核对 vhost、资源名和声明参数,避免通过删除生产队列“试错”。
容器部署应查看 docker logs 或 kubectl logs 的标准输出;Windows 使用 rabbitmq-diagnostics.bat -q log_location 定位文件。无论平台如何,先限定节点和时间,再按故障类别过滤。
普通 RabbitMQ 日志不会逐条记录正常消息的路由、投递和确认;需要追踪单条消息时使用 Firehose,而不是长期打开 debug。
根据 access refused、login refused 和权限正则定位访问失败。
排查认证与权限失败
当客户端出现 PLAIN login refused、access to vhost refused 或 ACCESS_REFUSED 时,先区分“凭据未通过”“虚拟主机不可访问”和“资源权限正则不匹配”,再做最小范围修复。
快速定位
服务端日志是第一判断依据:invalid credentials 表示用户名或密码未通过;guest can only connect via localhost 表示远程使用默认 guest;access to vhost 表示用户没有该 vhost 的任何权限;连接已建立后出现 ACCESS_REFUSED,通常是 configure、write 或 read 正则没有匹配实际资源名。
下面示例检查最近日志、验证账号,并从“按用户”和“按 vhost”两个方向核对权限。将节点、用户、vhost 和密码占位符替换为现场值。
NODE='rabbit@rmq-1'
USER='order-app'
VHOST='/orders'

journalctl -u rabbitmq-server --since '-10 min' | grep -E 'login refused|access to vhost|ACCESS_REFUSED' || true

# authenticate_user 只验证用户名和密码,不代表目标 vhost 已授权
rabbitmqctl -n "$NODE" authenticate_user "$USER" '<PASSWORD>'
rabbitmqctl --silent -n "$NODE" list_user_permissions "$USER"
rabbitmqctl --silent -n "$NODE" list_permissions -p "$VHOST"
预期输出示例:
PLAIN login refused: user 'order-app' - invalid credentials
Success
/orders    ^(orders\.exchange|orders\.queue)$    ^orders\.exchange$    ^orders\.queue$
order-app  ^(orders\.exchange|orders\.queue)$    ^orders\.exchange$    ^orders\.queue$
第一行是一次失败日志,后续 Success 说明当前测试密码可通过认证。第三行以 vhost 开头,表示该用户在各 vhost 的权限;第四行以用户名开头,表示该 vhost 下各用户的权限。实际时间、进程 ID 和表头可能不同。
权限正则读取
set_permissions 的三个正则顺序固定为 configure、write、read,匹配的是交换机或队列等资源名称,不是用户名,也不是普通 topic 路由键。.* 表示匹配全部资源,^$ 表示不匹配任何非空资源名;生产环境建议使用 ^ 和 $ 锚定完整名称,避免前缀误匹配。
常见操作对应关系:
- 声明、删除或修改交换机与队列需要 configure 匹配目标资源。
- 向交换机发布消息需要 write 匹配目标交换机。
- 从队列消费或读取消息需要 read 匹配目标队列。
- topic exchange 的路由键限制属于 topic permissions,应另查
list_user_topic_permissions。
最小权限修复
确认应用实际使用 orders.exchange 和 orders.queue 后,可按资源名授予最小权限,并立即回读验证。
rabbitmqctl -n "$NODE" set_permissions -p "$VHOST" "$USER" '^(orders\.exchange|orders\.queue)$' '^orders\.exchange$' '^orders\.queue$'
rabbitmqctl --silent -n "$NODE" list_user_permissions "$USER"
预期输出:
/orders ^(orders\.exchange|orders\.queue)$ ^orders\.exchange$ ^orders\.queue$若应用只消费已有队列且不声明拓扑,可把 configure 收紧为 ^$;若启动时会声明交换机、队列或绑定,则必须保留相应 configure 权限。
风险与边界
直接把三个正则都改成 .* 会在该 vhost 内放大声明、发布和消费权限;触发条件是误用账号或凭据泄露,后果可能是拓扑被改动、消息被读取或写入错误位置。安全替代方案是先从日志提取被拒绝的资源名,再只放开必需名称并回归测试。
authenticate_user 将密码作为命令参数传入,可能被 shell 历史或本机进程查看工具捕获。只在受控管理主机上使用临时或短期凭据,避免在共享终端执行;排查完成后按安全策略清理历史并在需要时轮换凭据。
排障清单
- 用户不存在:执行
rabbitmqctl list_users,确认名称和大小写。 - vhost 不存在或写错:执行
rabbitmqctl list_vhosts name,URI 中/需正确编码。 - 仅远程失败且用户为
guest:不要放开远程 guest,创建独立服务账号。 - 用户密码正确但仍失败:核对客户端连接的 vhost、认证机制和实际连接节点。
- 权限看似正确:检查资源真实名称、正则锚点、topic permissions 以及服务端拒绝日志。
兼容性
上述用户和权限命令适用于 RabbitMQ 内置用户数据库。使用 LDAP、OAuth 2.0、X.509 或自定义认证后端时,CLI 列表可能不能完整反映外部身份与授权规则,应同时检查对应插件配置、身份提供方和服务端日志。
确认集群成员、节点类型、运行节点和网络分区状态。
查看集群状态
当节点失联、发布确认抖动或集群变更后需要确认整体状态时,用 cluster_status 同时核对已知成员、节点类型、当前可达节点和网络分区。该命令只读,适合作为集群排障的第一步。
基本命令
从任一可正常管理的节点执行;使用长节点名时补充 --longnames。rabbitmq-diagnostics 更偏诊断用途,rabbitmqctl cluster_status 可作为等价入口。
NODE='rabbit@rmq-1'
rabbitmq-diagnostics -n "$NODE" cluster_status
预期输出示例:
Cluster status of node rabbit@rmq-1 ...

Disk Nodes
rabbit@rmq-1
rabbit@rmq-2
rabbit@rmq-3

Running Nodes
rabbit@rmq-1
rabbit@rmq-2
rabbit@rmq-3

Network Partitions
(none)

Alarms
(none)
节点名、版本、CPU、监听端口和功能标志等附加段落会随版本和环境变化。关键是对比成员列表与 Running Nodes,并确认 Network Partitions 和 Alarms 没有异常。
输出读取
- Disk Nodes 列出磁盘节点;部分版本或旧集群还可能显示 RAM Nodes。两部分合起来是节点所知的集群成员。
- Running Nodes 是从当前目标节点视角可达并正在运行的成员。成员存在但未出现在这里,通常表示节点停止、主机名解析失败、Erlang 分布端口不通或节点间认证失败。
- Network Partitions 为
(none)表示当前未报告分区;若列出节点组合,说明不同成员看到的集群视图不一致。 - Alarms 显示内存或磁盘等资源告警。节点全部运行并不代表队列副本、stream 副本或业务流量一定健康。
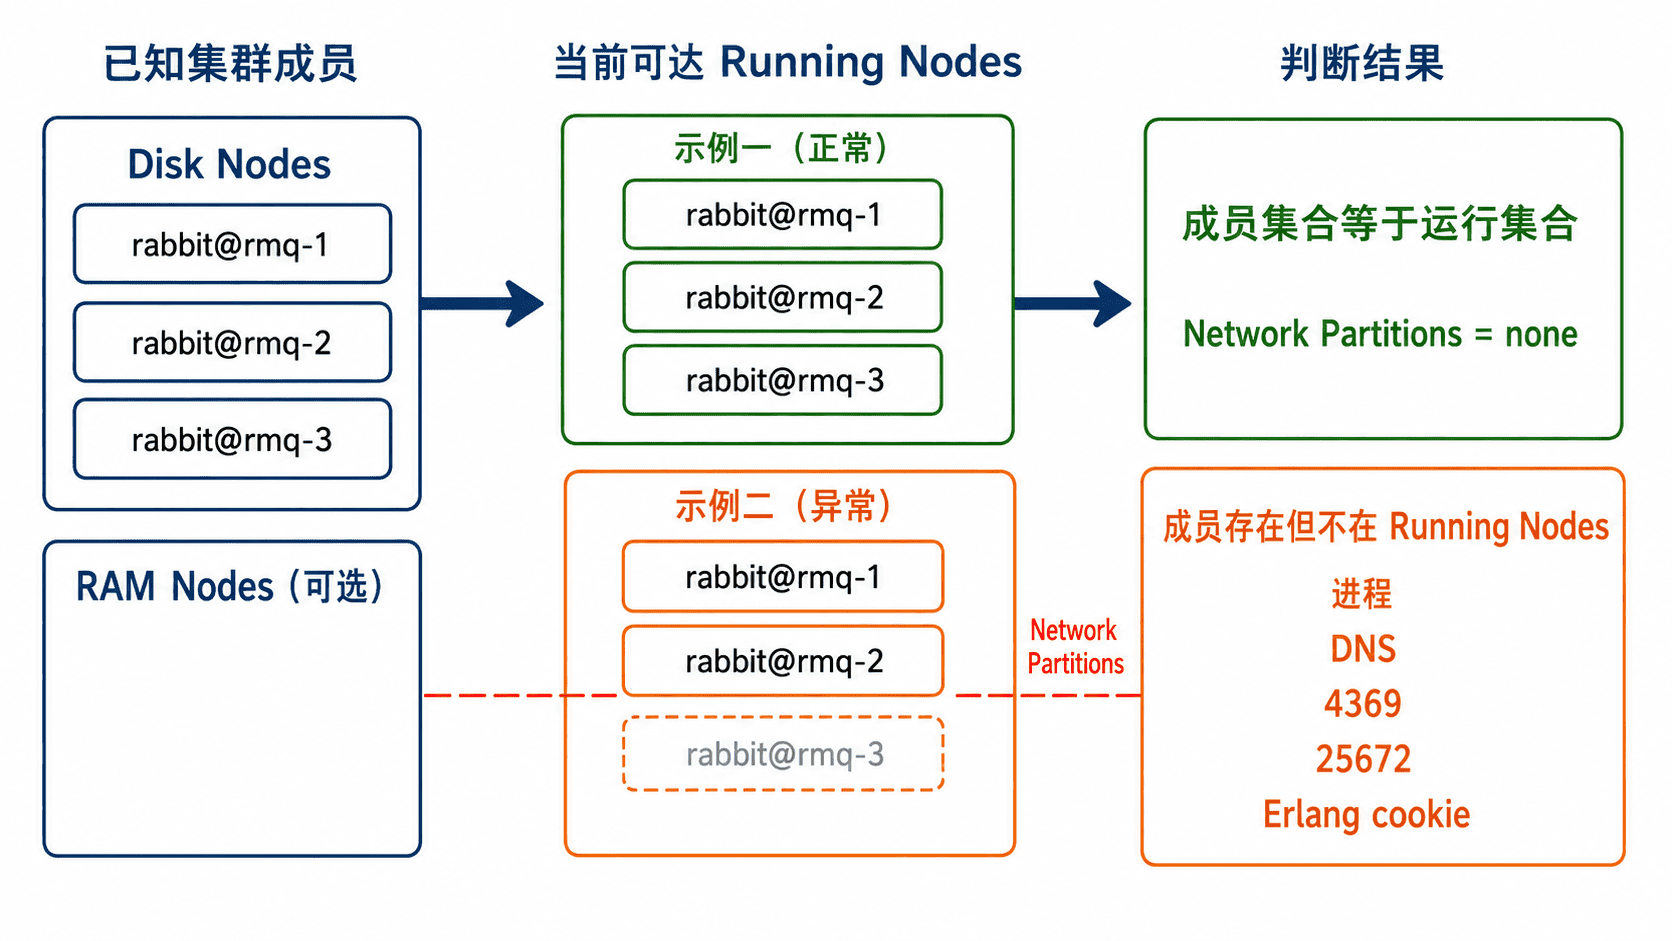
异常判断顺序
先看“成员数是否等于运行数”。若少一个节点,优先到该节点检查 RabbitMQ 进程和日志,再验证节点之间的主机名解析、TCP 4369 与 25672,以及 Erlang cookie 是否一致。CLI 自身报 Erlang distribution failed 时,不要误判为业务账号问题,可执行 rabbitmq-diagnostics erlang_cookie_sources 核对 CLI 使用的 cookie 来源。
如果从两个存活节点执行 cluster_status 得到不同的 Running Nodes 或分区视图,按网络分区处理,先恢复双向网络和名称解析,不要立即重置节点。网络恢复后再次从多个节点核对输出,确认视图收敛。
若所有成员都在 Running Nodes,但 quorum queue 或 stream 仍不可用,应继续检查具体副本:使用 rabbitmq-queues quorum_status --vhost <VHOST> <QUEUE> 或 rabbitmq-streams stream_status --vhost <VHOST> <STREAM>。计划下线节点前,可运行 rabbitmq-queues check_if_node_is_quorum_critical 判断是否会失去在线多数派。
风险与边界
cluster_status 本身不会修改集群,但根据“节点不在 Running Nodes”直接执行 reset、force_reset、join_cluster 或 forget_cluster_node 风险很高。触发条件是把临时网络故障误认为永久成员损坏,后果可能包括节点本地数据被清除、队列或 stream 副本减少,甚至失去多数派。
安全替代方案是先保存各节点输出和日志,恢复进程、DNS、端口与 cookie,再检查 quorum queue 和 stream 副本状态。只有节点确认不可恢复、备份与副本安全性已评估并有变更方案时,才执行成员移除或重建。
兼容性
RabbitMQ 4.3 起元数据存储和分区处理机制与旧版本不同,但 rabbitmq-diagnostics cluster_status 仍用于查看成员与可达节点。较旧版本可能显示 RAM Nodes、不同的 Network Partitions 格式或更多 Mnesia 相关字段;排障时以“已知成员集合、Running Nodes 集合、分区与告警”四类信息为准。
根据业务一致性要求选择分区策略并安全恢复集群。
处理 RabbitMQ 网络分区
用于确认集群是否发生分区、判断仍具多数派的一侧,并在不扩大数据风险的前提下恢复节点。RabbitMQ 4.3 及以上已移除旧式分区策略,处理重点是保住 Raft 多数派、修复节点通信并验证副本追赶;4.2 及更早版本才需要预先选择 pause_minority、autoheal 等策略。
先确认版本和影响面
从任一仍可访问节点查看集群视图。Running Nodes 只表示该观察节点当前可达的成员;同一命令应在分区两侧各执行一次,避免把单向网络故障误判成节点宕机。
rabbitmq-diagnostics cluster_status预期输出示例:
Cluster status of node rabbit@rmq-a ...
Running Nodes
rabbit@rmq-a
rabbit@rmq-b
若原集群还有 rabbit@rmq-c,但它未出现在该侧的 Running Nodes 中,说明当前观察节点无法与它完成集群通信。继续检查日志中的连接丢失、Raft 选举和超时记录,并确认 4369、25672 端口、DNS、TLS 与跨节点时钟没有异常。
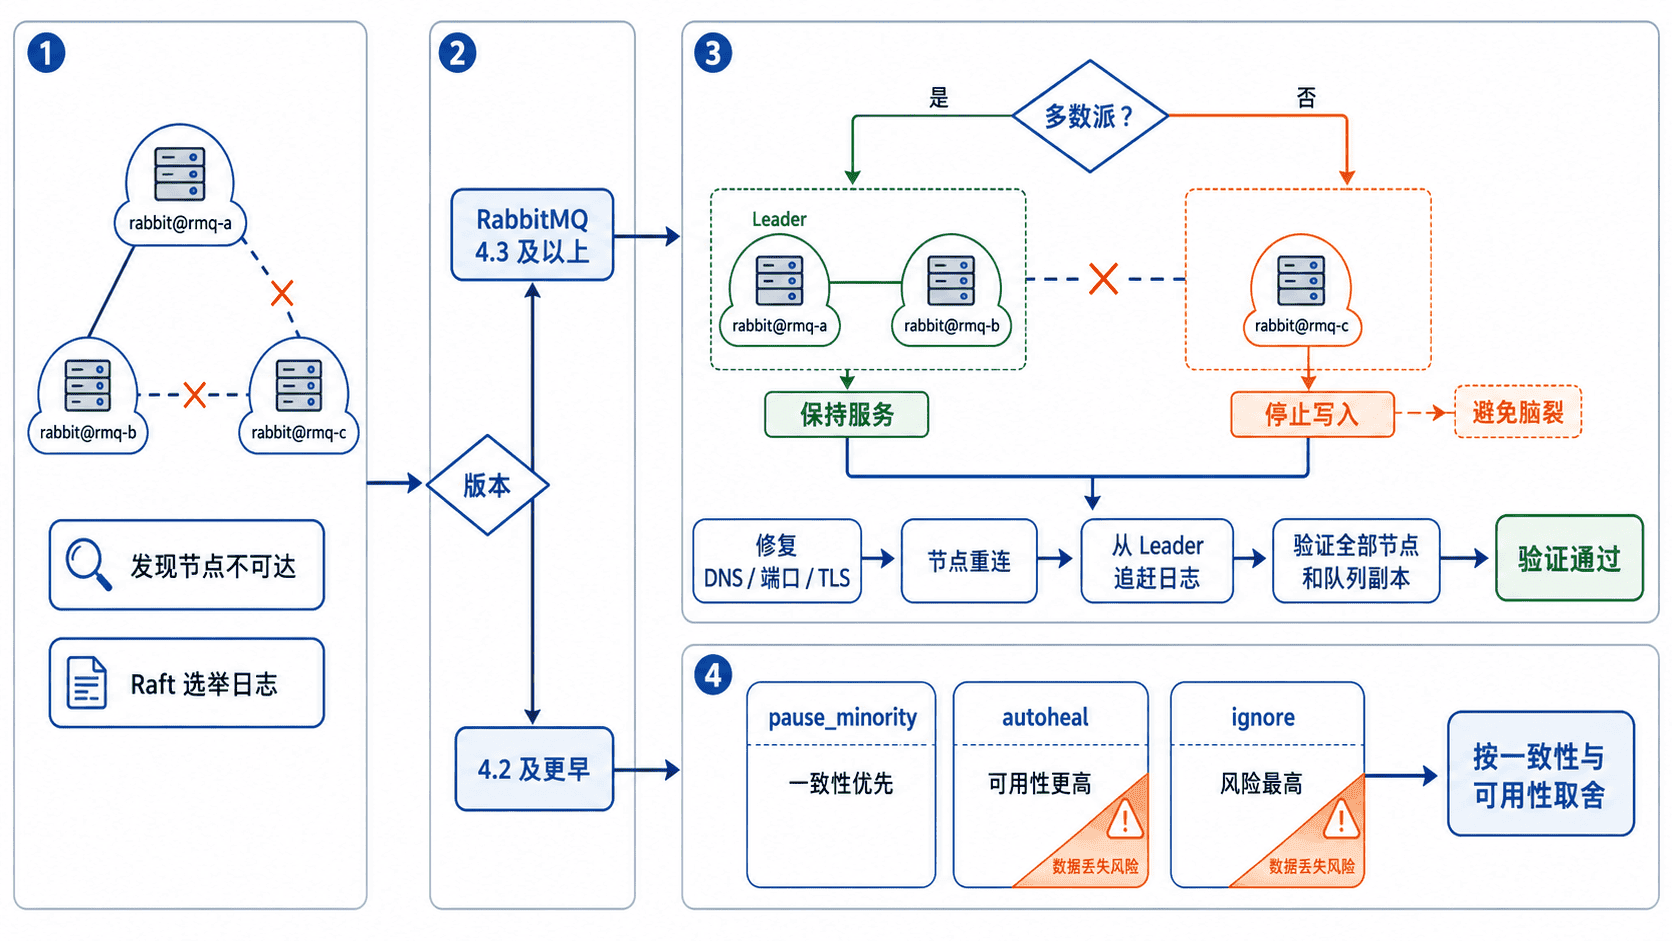
RabbitMQ 4.3 及以上的恢复顺序
先将生产者和消费者导向仍能形成多数派的节点,不要在少数派上强制启动、重建集群或删除成员。多数派可选出新的 Leader;选举期间发布确认可能延迟或返回 basic.nack,未确认的消费消息也可能在新 Leader 上重新投递,因此生产端要基于确认结果重试,消费端必须保持幂等。
修复网络后等待失联节点自动重连和追赶 Raft 日志。长时间分区会产生较大的同步流量,返回节点在追赶完成前不应承担 Leader 或高峰流量。先检查集群成员,再检查关键 quorum 队列的 Leader、Follower 与在线状态。
rabbitmq-diagnostics cluster_status
rabbitmq-queues quorum_status --vhost "/" "orders"
预期结果:
Running Nodes
rabbit@rmq-a
rabbit@rmq-b
rabbit@rmq-c

退出码为 0;orders 的状态中可见一个 Leader,配置的成员均已在线。
实际输出格式会随版本略有差异;判断标准是所有预期节点重新出现在 Running Nodes,关键队列拥有在线多数派,且日志不再持续出现同一队列的反复选举。
RabbitMQ 4.2 及更早版本的策略选择
| 策略 | 适用条件 | 主要后果 |
|---|---|---|
pause_minority |
三个或更多奇数节点,优先一致性 | 少数派暂停服务,通常是旧版本生产集群的首选 |
autoheal |
更看重服务连续性,能接受丢弃失败分区的变化 | 网络恢复后选择获胜分区并重启另一侧,可能丢失拓扑或消息变化 |
ignore |
单机房高可靠局域网,且具备人工恢复预案 | 分区两侧可独立变化,可能形成 split-brain |
pause_if_all_down |
明确指定权威机架或站点 | 配置复杂;锚点分散到两侧时可能无法阻止双边继续运行 |
强一致性业务可在旧版本的 rabbitmq.conf 中使用:
# 仅 RabbitMQ 4.2 及更早版本有效
cluster_partition_handling = pause_minority
生效行为:检测到分区后,不具严格多数派的一侧停止对外服务;网络恢复后节点再恢复。修改后按节点滚动重启并通过故障演练验证,不要直接在未演练的生产集群切换策略。
风险与边界
autoheal 的触发条件是旧版本检测到分区并在连通恢复后选出获胜侧,失败侧会被重启,其独立变化可能丢失;安全替代是优先使用 pause_minority,或升级到基于 Khepri/Raft 的新版本。ignore 在真实分区中可能产生 split-brain,恢复时必须选定权威分区,停止另一侧后再重启,落败侧变化不可保留。
两节点集群无法在断链时形成多数派,pause_minority 还可能让两边都暂停;安全替代是使用三个或五个节点。跨不稳定 WAN 拉伸集群会放大选举、超时和同步问题,应改用 Federation 或 Shovel 连接独立集群。
排障清单
- 在分区两侧分别执行
cluster_status,记录各自可见节点。 - 检查 4369、25672 端口、双向 DNS、Erlang cookie、TLS 和丢包。
- 确认关键 quorum 队列仍有在线多数派,禁止同时重启多数派节点。
- 网络恢复后等待副本追赶,观察磁盘、网络和重复选举。
- 核对生产者确认与消费者幂等,处理
basic.nack和重复投递。 - RabbitMQ 4.3 及以上删除旧
cluster_partition_handling配置;该配置已无实际作用。
将新节点加入现有集群并验证元数据和队列副本分布。
加入 RabbitMQ 集群节点
用于把一个新节点加入现有 RabbitMQ 集群,并确认元数据同步、集群成员可见以及 quorum 队列副本是否按计划落到新节点。RabbitMQ 4.1 及以上可直接执行 join_cluster;加入操作会清除新节点原有的独立集群状态,因此必须先确认该节点没有需要保留的数据。
前置检查
新节点与现有节点必须使用唯一且稳定的节点名,彼此能解析主机名,并使用相同 Erlang cookie。集群通信至少需要双向开放 4369 和 25672;使用 Stream 复制时还要放通 6000~6500。RabbitMQ 与 Erlang/OTP 版本应在官方支持的兼容范围内,集群节点最好使用相同 RabbitMQ 系列和相同 Erlang 主版本。
rabbitmq-diagnostics ping
getent hosts rabbit1
nc -vz rabbit1 4369
nc -vz rabbit1 25672
预期输出示例:
Ping succeeded
<IP> rabbit1
Connection to rabbit1 4369 port [tcp/*] succeeded!
Connection to rabbit1 25672 port [tcp/*] succeeded!
<IP> 为实际解析地址。若 TCP 连通但 join_cluster 报认证失败,执行 rabbitmq-diagnostics erlang_cookie_sources 检查 CLI 使用的 cookie 文件位置和权限,不要把 cookie 明文写入命令历史。
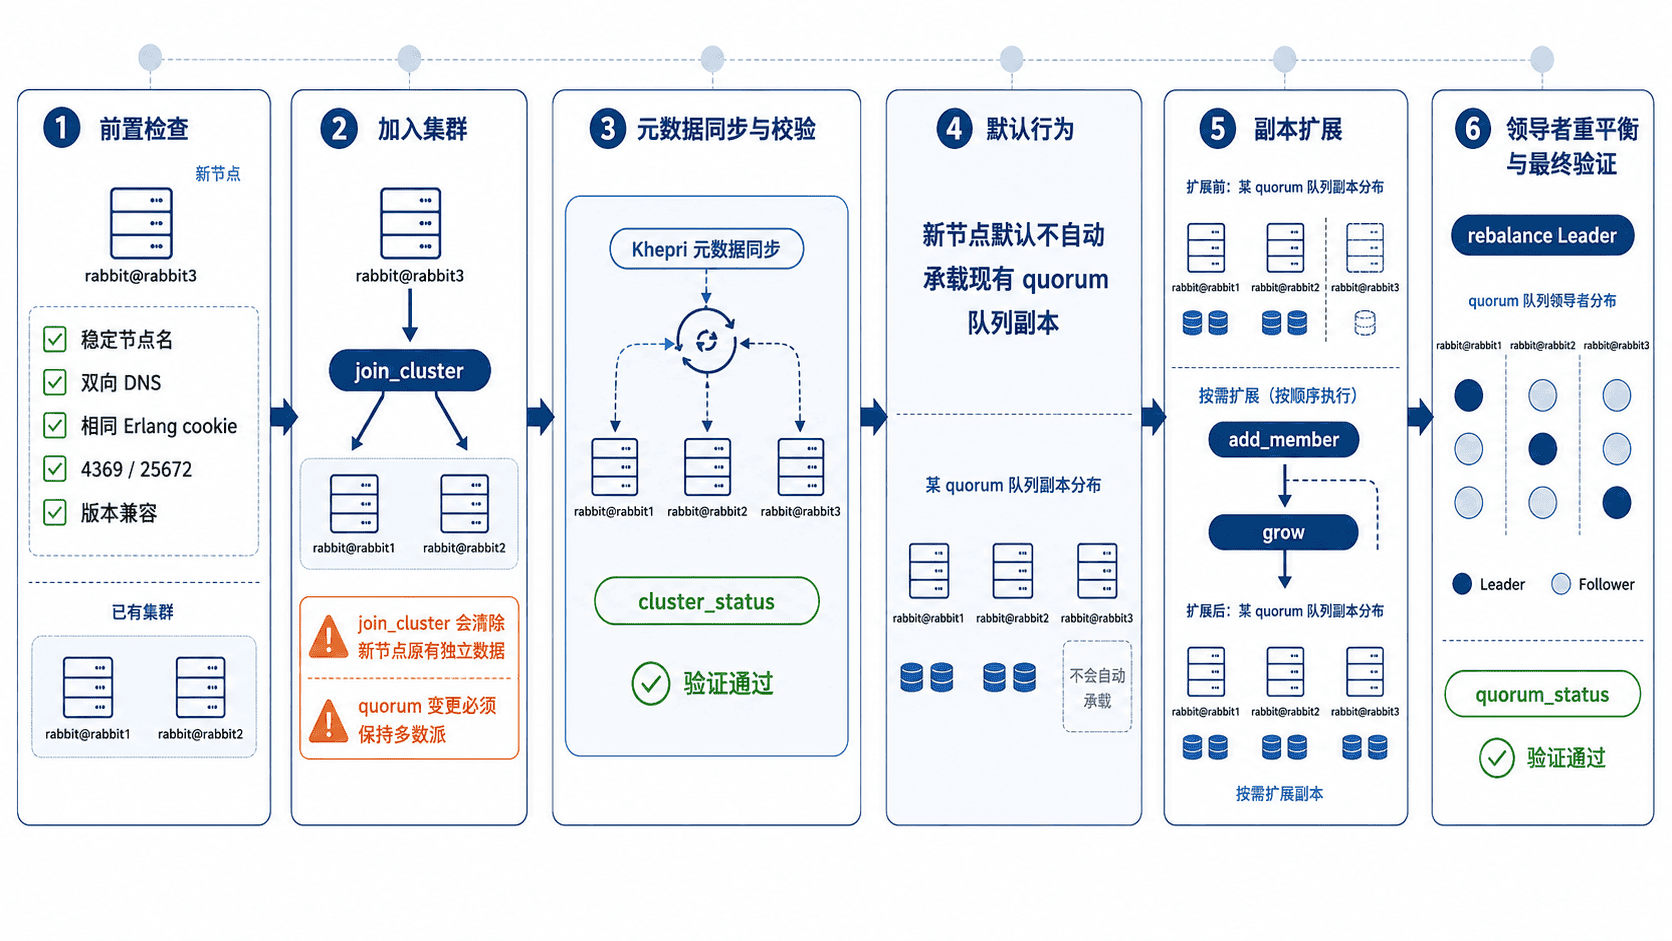
加入节点并验证元数据
以下命令在待加入的新节点 rabbit@rabbit3 上执行。目标参数可以是现有集群中的任一在线节点;该节点会把新节点带入自己所属的整个集群。
# RabbitMQ 4.1+:无需先 stop_app、reset、start_app
rabbitmqctl join_cluster rabbit@rabbit1
rabbitmqctl cluster_status
预期输出示例:
Clustering node rabbit@rabbit3 with rabbit@rabbit1 ...done.
Cluster status of node rabbit@rabbit3 ...
Running Nodes
rabbit@rabbit1
rabbit@rabbit2
rabbit@rabbit3
只有当三个节点都出现在 Running Nodes 中,且新节点日志没有持续的 Khepri 同步、cookie 或节点名错误,才算元数据层加入完成。生产环境优先使用 DNS、Kubernetes、Consul 等 peer discovery 自动组集群;手工 join_cluster 更适合开发、测试或受控恢复。
扩展 quorum 队列副本
加入集群不等于现有 quorum 队列自动在新节点创建副本。未启用连续成员协调时,需要显式添加单个队列成员,或批量把符合条件的队列扩展到新节点;成员变更期间必须保持原队列多数派在线。
# 仅给关键队列增加一个副本
rabbitmq-queues add_member --vhost "/" "orders" "rabbit@rabbit3"

# 验证 Leader、Follower 和成员在线状态
rabbitmq-queues quorum_status --vhost "/" "orders"
预期结果:
退出码为 0;orders 的成员列表包含 rabbit@rabbit3,并且仍有且仅有一个 Leader。批量扩展时可使用 rabbitmq-queues grow "rabbit@rabbit3" "even",它只选择当前副本数为偶数的 quorum 队列,便于把两副本补成三副本。若目标是把所有匹配队列都扩展到新节点,应将选择器改为 all,并配合 --vhost-pattern、--queue-pattern 缩小范围,避免瞬间产生过多磁盘与网络同步。
重新分布 Leader
增加副本只改变队列成员所在节点,不会自动均衡 Leader。确认副本追赶完成、磁盘和网络负载稳定后,再执行 Leader 重平衡。
rabbitmq-queues rebalance quorum预期结果:
退出码为 0;quorum 队列 Leader 在可用集群节点之间重新分布。重平衡可能引发短暂 Leader 切换和客户端延迟。先在低峰期执行,并观察发布确认延迟、消费者重连、磁盘 I/O 与反复选举;只为“让新节点看起来有负载”而立即重平衡没有必要。
风险与边界
join_cluster 的触发条件是把当前节点并入另一个集群,后果是该节点不能同时保留原独立集群的数据与身份;安全替代是先导出 definitions、迁移消息或采用蓝绿迁移,再使用空白节点加入。不要对仍承载独立业务的节点直接执行。
DNS、节点名大小写或 cookie 不一致会导致 Erlang distribution 认证失败;安全做法是先固定 RABBITMQ_NODENAME、核对双向解析并统一 cookie。跨高延迟或高丢包链路加入同一集群会影响 Raft 选举和写入延迟,应改为两个独立集群配合 Federation 或 Shovel。
排障清单
- 新节点名唯一、稳定,短名与 FQDN 模式在所有节点一致。
- 所有节点双向解析成功,4369、25672 端口可达;Stream 场景再检查 6000~6500。
- Erlang cookie 内容一致且文件权限正确,CLI 与服务进程读取的是预期文件。
cluster_status在任一节点都显示完整Running Nodes。- 新节点默认没有现有 quorum 副本;按需执行
add_member或grow。 - 副本追赶完成后再
rebalance quorum,并持续观察发布确认、网络和磁盘负载。 - RabbitMQ 4.0 及更早版本通常需要旧式
stop_app、reset、join_cluster、start_app流程;执行前必须按目标版本文档核对。
在确认节点不可恢复后安全 forget 或 reset 节点。
移除故障节点
用于节点已确认不可恢复、需要从 RabbitMQ 集群成员列表中永久移除的场景。核心原则是先隔离旧节点并确认 Quorum 队列仍有多数副本,再从存活节点执行 forget_cluster_node;reset 只在目标节点仍可操作且允许清空本地数据时使用。
命令定位
rabbitmqctl forget_cluster_node 在存活节点上远程删除一个已离线成员,并移除该节点承载的 Quorum 队列和 Stream 副本。rabbitmqctl reset 在目标节点本机执行,会清空本地消息、集群成员信息、用户、虚拟主机、运行时参数及节点身份,不能当作无损修复命令。
安全操作路径
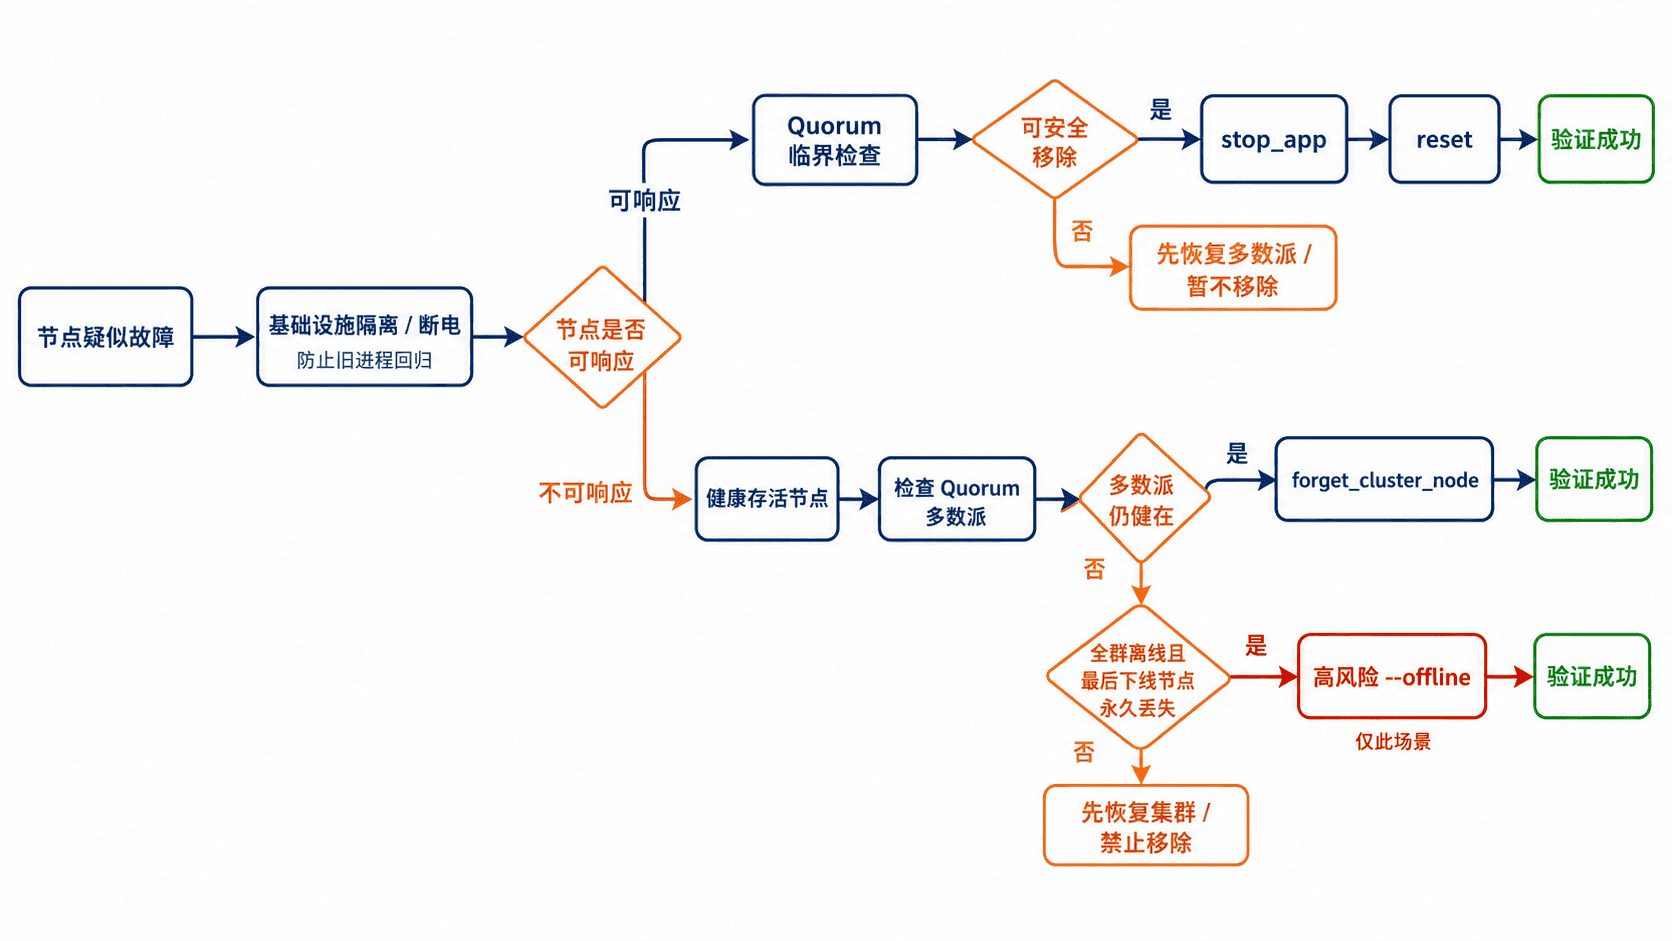
移除前必须在虚拟机、容器编排或网络层“围栏”目标节点,确保旧数据目录不会再次启动并接收流量。计划下线时,应在目标节点仍在线时运行 Quorum 临界检查;若节点已经彻底离线,则逐个检查受影响 Quorum 队列是否仍有领导者和在线多数副本。
高频用法
计划下线前检查目标节点是否为 Quorum 关键节点。退出码为 0 才表示当前检查通过;非零时先补充或恢复副本,不要继续停止节点。
rabbitmq-diagnostics -q -n rabbit@rabbit3 check_if_node_is_quorum_critical >/dev/null
printf 'exit_code=%s\n' "$?"
预期输出:
exit_code=0目标节点已永久离线时,从一个健康存活节点执行 forget_cluster_node,随后确认成员信息中不再出现目标节点。
SURVIVOR='rabbit@rabbit1'
FAILED='rabbit@rabbit3'

# 必须先在基础设施层隔离 FAILED,防止旧进程携带陈旧数据再次启动
rabbitmqctl -n "$SURVIVOR" forget_cluster_node "$FAILED"
rabbitmqctl -q -n "$SURVIVOR" cluster_status | grep -F "$FAILED" || printf 'target_absent\n'
预期输出:
Removing node rabbit@rabbit3 from cluster ...
target_absent
目标节点仍可响应、并且要把它清空后作为全新节点重新部署时,在目标节点上停止应用再重置。执行后本地数据不可恢复,若只是临时维护,不要运行此操作。
TARGET='rabbit@rabbit3'

rabbitmqctl -n "$TARGET" stop_app
rabbitmqctl -n "$TARGET" reset
预期输出:
Stopping node rabbit@rabbit3 ...
Resetting node rabbit@rabbit3 ...
风险与边界
移除节点会同步删除它承载的 Quorum 队列与 Stream 副本。触发条件是执行 forget_cluster_node;若剩余在线副本不足多数,相关队列会不可用,甚至只能通过恢复原节点或备份处理。安全替代方案是先新增并完成副本同步,再做临界检查和移除。
reset 的触发条件是目标节点应用已停止且命令成功执行,后果是本地节点数据与身份被彻底清空。安全替代方案是保留原数据目录快照,或直接销毁旧实例并以空数据目录重建。force_reset 已弃用,并且不支持 Khepri 元数据存储,不应作为常规排障手段。
--offline 只适用于所有节点都离线、最后下线节点永久丢失而集群无法启动的极端情况。误用可能让较旧的节点成为元数据权威并产生不一致;优先恢复正常节点后在线执行 forget_cluster_node。
排障清单
cluster_status仍显示目标节点:确认命令实际连接的是存活集群成员,检查节点名、长短主机名和 Erlang Cookie,并查看前一条命令退出码。- CLI 无法连接存活节点:先处理节点进程、EPMD、主机名解析、端口和 Cookie;不要因为连接失败直接改用
--offline。 - 旧主机重新出现:立即停止服务并隔离数据目录,完成
reset或清空数据后再按新节点加入,禁止带旧状态直接恢复流量。 - 移除后队列不可用:运行
quorum_status检查领导者、timeout或noproc成员以及提交索引,优先恢复多数副本。
兼容性
forget_cluster_node、reset 在 RabbitMQ 3.x 和 4.x 中均常见,但离线恢复和元数据存储行为随版本不同。执行前使用 rabbitmqctl help forget_cluster_node 与 rabbitmqctl help reset 核对当前版本参数;采用长节点名时为 CLI 增加 --longnames。
查看 Quorum 队列成员、在线副本、领导者和同步状态。
检查 Quorum 健康
用于确认 Quorum 队列是否有领导者、哪些副本在线、复制进度是否收敛,以及某个节点能否安全维护。先定位所有 Quorum 队列,再对异常或关键队列运行 quorum_status;维护前额外检查目标节点是否为 Quorum 关键节点。
命令定位
rabbitmqctl list_queues 用于筛出队列类型和运行状态,rabbitmq-queues quorum_status 展示单个队列的 Raft 成员与复制索引,rabbitmq-diagnostics check_if_node_is_quorum_critical 通过退出码判断停止目标节点是否会让队列或 Stream 失去在线多数派。
健康关系
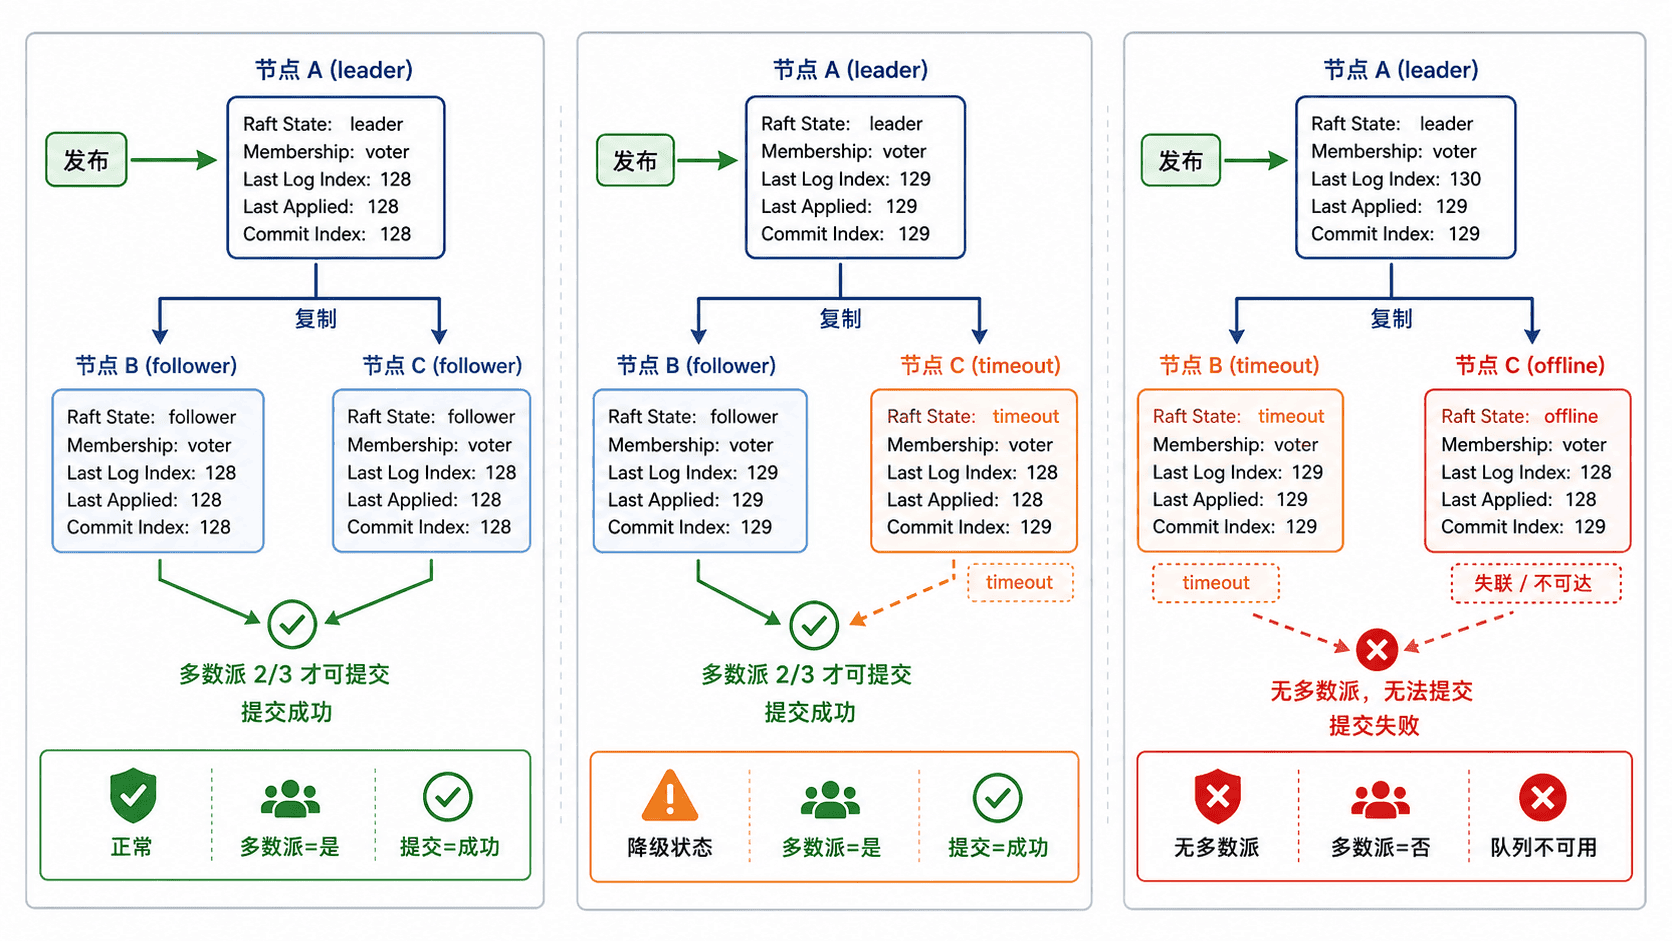
三副本队列至少需要两个在线投票成员,五副本至少需要三个。健康状态通常表现为恰好一个 leader、其余为 follower,并且各成员的日志、应用和提交索引持续前进;timeout、noproc 或长期不变的索引都需要排查。
高频用法
先列出虚拟主机 / 中的队列类型和状态。输出以制表符分列,实际队列名和数量会不同。
rabbitmqctl -q -n rabbit@rabbit1 list_queues -p / name type state预期输出:
name	type	state
orders	quorum	running
对关键队列查看成员、领导者和复制进度。下列索引、任期和版本均为动态值,实际输出使用带边框的表格。
rabbitmq-queues -n rabbit@rabbit1 quorum_status --vhost / orders预期输出:
Status of quorum queue orders on node rabbit@rabbit1 ...
Node Name        Raft State  Membership  Last Log Index  Last Written  Last Applied  Commit Index  Snapshot Index  Term    Machine Version
rabbit@rabbit1   leader      voter       <INDEX>         <INDEX>       <INDEX>       <INDEX>       <SNAPSHOT>      <TERM>  <VERSION>
rabbit@rabbit2   follower    voter       <INDEX>         <INDEX>       <INDEX>       <INDEX>       <SNAPSHOT>      <TERM>  <VERSION>
rabbit@rabbit3 follower voter <INDEX> <INDEX> <INDEX> <INDEX> <SNAPSHOT> <TERM> <VERSION>维护、重启或删除节点前,用退出码做自动化门禁。0 表示当前节点不是 Quorum 关键节点;任何非零值都应中止操作并检查命令输出。
rabbitmq-diagnostics -q -n rabbit@rabbit1 check_if_node_is_quorum_critical >/dev/null
printf 'exit_code=%s\n' "$?"
预期输出:
exit_code=0输出字段说明
| 字段 | 读取方法 |
|---|---|
Node Name |
Quorum 成员所在节点;行数应与预期副本数一致,异常成员仍可能显示为 timeout 或 noproc。 |
Raft State |
正常时一个 leader、其余 follower;没有领导者时队列不能正常处理发布和消费。 |
Membership |
voter 表示投票成员,可计入多数派;新增成员同步期间不要仅凭成员数量判断健康。 |
Last Log Index / Last Written |
反映日志接收和落盘进度;某成员长期落后且不增长,通常是网络、磁盘或进程问题。 |
Last Applied / Commit Index |
已应用状态与多数派已提交位置;两者长期差距扩大说明应用进度异常。 |
Snapshot Index |
快照位置可以暂时不同,不要求各副本完全相等;应结合日志索引是否持续推进判断。 |
Term |
Raft 任期;领导者切换时会增长,频繁变化通常意味着节点抖动或网络不稳定。 |
判定与排障
- 有一个领导者、在线成员达到多数派、索引持续增长:队列可用。少一个 follower 时属于降级状态,避免继续重启或移除其他成员。
- 出现
timeout:检查节点间 DNS、端口、网络延迟和 Erlang Cookie,再检查目标节点 CPU、磁盘延迟与资源告警。 - 出现
noproc:对应 Raft 进程不存在或未启动,查看该节点 RabbitMQ 日志、队列进程崩溃原因和数据目录状态。 - 没有
leader或在线成员不足多数派:停止变更,优先恢复原成员;不要通过删除成员强行“修复”一个已经失去多数派的队列。 - 索引短暂不同但持续收敛通常正常;若
Last Applied或Commit Index数分钟不前进,再收集rabbitmq-diagnostics report和节点日志。
风险与边界
quorum_status 是单队列即时视图,不能替代对全部虚拟主机和全部队列的巡检。只检查一个健康队列可能漏掉其他队列的副本缺失;安全做法是先列出所有 Quorum 队列,再对异常队列逐个检查,并在节点维护前运行 Quorum 临界检查。
仅看到三个成员名不代表三个健康在线副本。timeout、noproc、落后且不推进的新成员不能按正常副本处理;继续停止节点可能让队列失去多数派并不可用。安全替代方案是等待同步完成、恢复故障副本或新增副本后再维护。
兼容性
RabbitMQ 3.x 与 4.x 的 quorum_status 列可能不同,较新版本会显示 Membership、Last Written、Last Applied 等更多字段。自动化不要按固定列宽解析带边框表格,应优先依据命令退出码,并在升级后重新验证字段和脚本。长节点名集群需要为 CLI 增加 --longnames。
在维护或扩容后重新分布 Quorum 队列领导者。
重平衡 Quorum 队列领导者
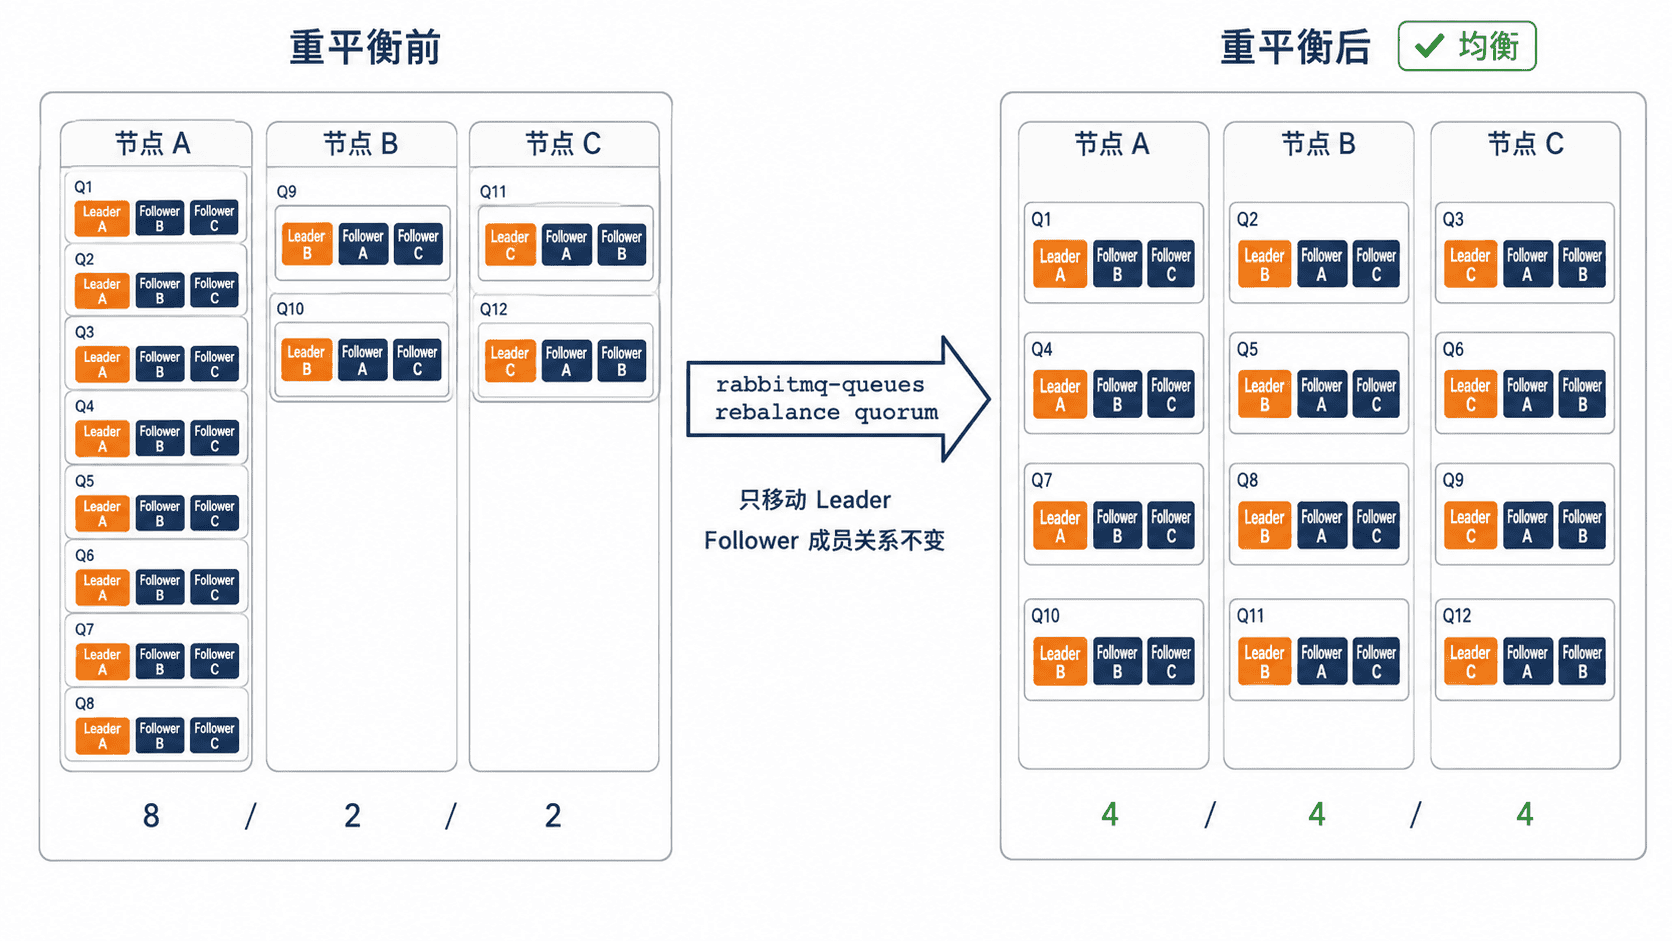
维护、节点重启或扩容后,Quorum 队列领导者可能集中在少数节点。使用 rabbitmq-queues rebalance quorum 可在现有副本成员之间重新分配领导者,降低单节点 CPU、磁盘和网络热点;它不会增加副本、改变复制因子或迁移队列成员。
命令定位
适合在滚动维护结束、节点重新加入或大量队列创建后执行。命令通过 Erlang Cookie 连接目标节点,目标节点必须在线且能访问其他集群成员;远程执行时用 -n rabbit@host 指定节点,集群使用 FQDN 节点名时同时加 --longnames。
基本语法
下面只处理 production 虚拟主机中以 orders. 开头的 Quorum 队列。正则使用首尾锚点,避免误匹配其他 vhost 或队列;-q 抑制非关键提示,并用退出码判断命令是否成功。
set -u

TARGET='rabbit@rmq-1'
rabbitmq-queues -q -n "$TARGET" rebalance quorum \
  --vhost-pattern '^production$' \
  --queue-pattern '^orders\.'
rc=$?

printf 'rebalance_exit=%d\n' "$rc"
exit "$rc"
预期输出
rebalance_exit=0退出码 0 表示重平衡命令完成;实际迁移数量取决于匹配队列、各队列的副本成员和当前领导者分布。部分版本会额外输出各节点领导者统计,因此自动化应以退出码和后续验证为准,不要解析提示文本。
常用参数
quorum:只处理 Quorum 队列;维护后仅需调整此类型时优先使用。all:同时处理支持重平衡的队列和流;范围更大,生产环境先确认影响。--vhost-pattern、--queue-pattern:均为正则表达式。生产操作建议使用^...$或明确前缀,避免默认宽匹配。-n:指定 CLI 连接的 RabbitMQ 节点;-t可设置命令超时,FQDN 节点名需加--longnames。
高频用法
重平衡全部 Quorum 队列时,可省略两个模式参数;维护窗口结束后需要同时处理其他支持类型时,把类型改为 all。
rabbitmq-queues rebalance quorum
rabbitmq-queues rebalance all
预期结果
命令成功时退出码为 0;实际输出和迁移数量随 RabbitMQ 版本及集群状态变化。验证时分别连接每个节点,用 --local 只列出领导者位于该节点的队列。连续执行前后对比,Quorum 队列数量应更接近,但不要求绝对相等。
rabbitmqctl -n rabbit@rmq-1 list_queues --local name type --no-table-headers预期输出示例
orders.created	quorum
orders.paid	quorum
第一列是队列名,第二列是类型;这里只显示领导者位于 rabbit@rmq-1 的队列。对所有节点执行相同命令并统计 quorum 行数,才能判断领导者是否真正分散。
风险与边界
重平衡会触发领导权转移。高负载、磁盘延迟或节点通信抖动时,可能出现短暂发布延迟、确认延后或消费者停顿;安全做法是在低峰期分批限定 vhost 和队列,并确保生产者正确处理 Publisher Confirm 超时或 basic.nack。
命令只能把领导者移到该队列现有副本所在的节点。若新增节点不是任何队列的成员,即使该节点几乎没有领导者也可能无变化;应先用 rabbitmq-queues grow 或 add_member 调整成员,再执行重平衡。不要把“领导者均衡”误认为“副本均衡”。
排障清单
- 无变化:检查筛选正则、队列类型,以及目标节点是否属于相应队列的副本成员。
- 报
nodedown:确认节点名、集群连通性、Erlang 分布端口和目标节点运行状态。 - 报 Cookie 或 challenge 错误:统一 CLI 与服务端 Erlang Cookie 的内容、属主和权限。
- 超时或部分迁移失败:先处理资源告警、网络分区和不响应队列,再查看 RabbitMQ 日志后重试。
RabbitMQ 4.x 已移除经典镜像队列;本条目针对 Quorum 队列。Windows 使用同名 .bat 工具,例如 rabbitmq-queues.bat rebalance quorum。
排空连接和领导者后进入维护模式,减少停机影响。
下线节点维护
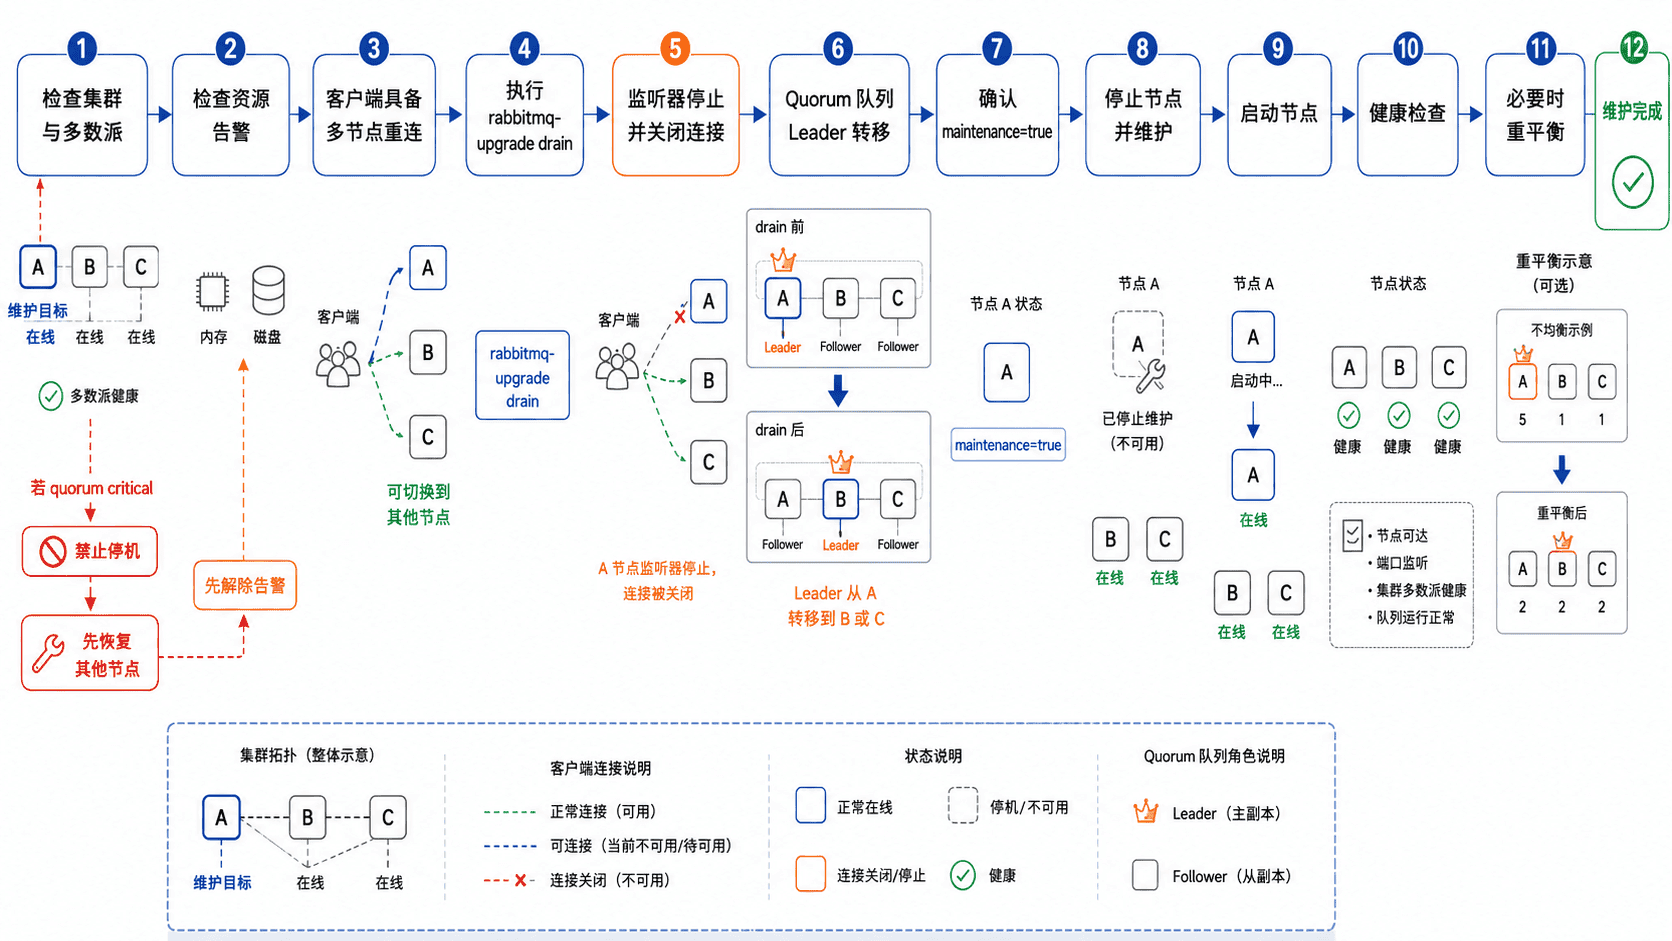
计划重启、升级或更换单个 RabbitMQ 节点时,先检查下线是否会破坏多数派,再执行 rabbitmq-upgrade drain。该操作停止接受新连接、关闭现有客户端连接并尽量转移 Quorum 队列领导者,使随后停机的影响更可控。
前置检查
一次只维护一个节点。三节点集群中若已有另一节点离线,再停一个节点通常会使部分 Quorum 队列或内部 Raft 组件失去多数派。以下检查任一失败都应终止维护,先恢复其他节点、同步副本或解除资源告警。
set -euo pipefail

TARGET='rabbit@rmq-1'

rabbitmq-diagnostics -q -n "$TARGET" \
  check_if_node_is_quorum_critical >/dev/null
printf 'quorum_check=ok\n'

rabbitmq-diagnostics -q -n "$TARGET" check_alarms >/dev/null
printf 'alarm_check=ok\n'
预期输出
quorum_check=ok
alarm_check=ok
check_if_node_is_quorum_critical 返回非零时,表示关闭目标节点可能让某些队列、流或内部组件失去在线多数派;不要强行继续。客户端也必须配置多个节点、负载均衡入口或自动连接恢复,否则 drain 主动关闭连接后应用会中断。
进入维护模式
在仍然在线的目标节点上执行 drain,并使用 JSON 状态字段验证,避免依赖不同版本的自然语言提示。示例需要已安装 jq;命令还要求与服务端一致的 Erlang Cookie,使用 FQDN 节点名时加 --longnames。
set -euo pipefail

TARGET='rabbit@rmq-1'

rabbitmq-upgrade -q -n "$TARGET" drain >/dev/null

rabbitmqctl -n "$TARGET" --formatter=json status \
  | jq -r '"maintenance=" + (.is_under_maintenance | tostring)'
预期输出
maintenance=true进入维护模式后,该节点不再接受客户端流量,已有连接会被关闭,Quorum 队列领导者会尽量转移,并且节点不会被选作新的队列领导者。此时再停止服务,通常比直接终止进程造成的抖动更小。
停机、启动与验证
确认业务连接已经迁移后再停止节点,完成系统补丁、配置调整或 RabbitMQ 升级,然后启动服务。节点重启会自动退出维护模式,不需要额外执行 revive。
set -euo pipefail

TARGET='rabbit@rmq-1'

sudo systemctl stop rabbitmq-server
# 在此处完成维护操作
sudo systemctl start rabbitmq-server

rabbitmq-diagnostics -q -n "$TARGET" ping >/dev/null
printf 'node=running\n'

rabbitmqctl -n "$TARGET" --formatter=json status \
  | jq -r '"maintenance=" + (.is_under_maintenance | tostring)'
预期输出
node=running
maintenance=false
随后检查 rabbitmqctl cluster_status、资源告警、关键队列可用性和应用重连情况。若维护后领导者分布明显倾斜,再执行 rabbitmq-queues rebalance quorum;不要在节点尚未稳定加入集群时立即重平衡。
取消维护
若执行 drain 后决定不重启,可用 revive 恢复监听器和领导者候选资格。已经完成节点重启时无需执行,因为重启会自动退出维护模式。
set -euo pipefail

TARGET='rabbit@rmq-1'

rabbitmq-upgrade -q -n "$TARGET" revive >/dev/null

rabbitmqctl -n "$TARGET" --formatter=json status \
  | jq -r '"maintenance=" + (.is_under_maintenance | tostring)'
预期输出
maintenance=false风险与边界
drain 的触发条件是计划内短时维护,但它会主动关闭目标节点上的全部客户端连接。若生产者或消费者只配置单一地址,后果是连接中断和消息处理暂停;安全替代方案是先验证多节点重连、自动拓扑恢复和未确认消息重试,再逐节点维护。
维护模式不等于永久下线,也不会删除队列副本或移除集群成员。长时间保持 maintenance 状态会浪费容量并使后续故障余量下降;永久退役节点应使用副本迁移、shrink 和集群成员移除流程,而不是只执行 drain。
排障清单
- 多数派检查失败:恢复离线节点,等待副本同步完成,或先增加可用副本;禁止绕过检查直接停机。
- drain 连接失败:核对节点名、Cookie、CLI 端口、DNS 和集群节点可达性。
- 应用未恢复:检查客户端是否配置主机列表、负载均衡、心跳、自动连接恢复和拓扑恢复。
- 重启后节点未就绪:检查
rabbitmq-diagnostics ping、cluster_status、监听器、告警和节点日志。 - drain 后不再维护:执行
rabbitmq-upgrade revive,确认maintenance=false后再恢复流量。
Linux 使用无后缀命令;Windows 使用 rabbitmq-upgrade.bat、rabbitmqctl.bat。在 Kubernetes RabbitMQ Cluster Operator 中,生命周期钩子可能已包含多数派检查,应先核对 Operator 配置,避免重复或冲突的下线逻辑。
导出并恢复用户、vhost、权限、策略和拓扑定义。
备份与恢复定义
用于迁移或重建 RabbitMQ 的用户、vhost、权限、策略、交换机、队列和绑定。定义文件是拓扑与安全配置备份,不包含队列中的消息体;需要恢复消息时,必须另行设计消息存储快照或跨集群复制方案。:contentReference[oaicite:0]{index=0}
命令定位
rabbitmqctl export_definitions 和 import_definitions 不依赖 Management 插件,可直接连接本机节点;在集群内从任一健康节点导出的定义结果等价。执行账号需要能读取 RabbitMQ 节点 Cookie,并具有文件目录的读写权限。:contentReference[oaicite:1]{index=1}
备份并校验
下面导出全局定义,并用 jq 检查关键数组是否存在。<PATH> 替换为仅管理员可读的备份目录。
set -euo pipefail

BACKUP="<PATH>/rabbitmq-definitions.json"

# 定义中含用户密码哈希,先限制新文件权限。
umask 077
rabbitmqctl export_definitions "$BACKUP"

test -s "$BACKUP"
jq -e '
  has("users") and
  has("vhosts") and
  has("permissions") and
  has("policies")
' "$BACKUP"

printf 'validated: %s\n' "$BACKUP"
预期输出
true
validated: <PATH>/rabbitmq-definitions.json
RabbitMQ 还可能打印导出进度,具体文案随版本变化;判断成功以命令退出码为 0、文件非空且 jq 返回 true 为准。导出的用户记录包含密码哈希,应按密钥文件管理,不要提交到代码仓库或普通对象存储桶。:contentReference[oaicite:2]{index=2}
恢复并验证
先在隔离环境校验版本和插件,再导入目标节点。导入完成后检查 vhost、用户、权限、策略及拓扑数量,而不是只看命令是否退出。
set -euo pipefail

BACKUP="<PATH>/rabbitmq-definitions.json"

rabbitmqctl import_definitions "$BACKUP"
printf 'import exit=%s\n' "$?"

rabbitmqctl list_vhosts name
rabbitmqctl list_users
rabbitmqctl --vhost "/" list_permissions
rabbitmqctl --vhost "/" list_policies --formatter=pretty_table
预期输出
import exit=0
Listing vhosts ...
<RESTORED_VHOSTS>
Listing users ...
<RESTORED_USERS>
Listing permissions for vhost "/" ...
<RESTORED_PERMISSIONS>
<RESTORED_POLICIES_TABLE>
<RESTORED_...> 由备份内容决定。还应抽查交换机、队列和绑定;若应用会自动声明拓扑,先确认声明参数与恢复文件一致,避免出现同名资源属性冲突。:contentReference[oaicite:3]{index=3}
风险与边界
- 触发条件:把定义备份误当消息备份。可能后果:恢复后队列存在但历史消息为空。安全替代:为消息数据使用停机一致性快照、受支持的灾备复制或应用级重放。
- 触发条件:备份文件泄露。可能后果:攻击者获得用户名、标签、权限及密码哈希。安全替代:
umask 077、加密存储、最小化访问,并定期轮换凭据。 - 触发条件:直接导入生产集群。可能后果:同名队列参数、插件交换机类型或策略不兼容,导入中断或应用声明失败。安全替代:先在同版本、同插件的临时集群演练,并保存导入前定义。
- 触发条件:从 RabbitMQ 3.13 或更早迁移到 4.x,文件仍含
ha-mode等经典镜像策略。可能后果:策略无效或导入失败。安全替代:导出时移除经典镜像键,并把高可用队列迁移为 quorum queue。经典队列镜像从 4.0 起已移除。:contentReference[oaicite:4]{index=4}
速查:定义恢复只解决“配置与拓扑重建”;消息、证书、Cookie、插件安装和节点配置文件需要单独备份。
用 policy 统一设置 TTL、死信、队列长度和高可用参数。
配置普通策略
用于按队列名正则统一下发消息 TTL、死信交换机、长度上限和溢出行为。普通 policy 属于指定 vhost,并会作用于已存在和后续匹配的对象;同一对象最终只采用一个最高优先级的普通 policy,因此相关参数应合并到同一策略。:contentReference[oaicite:5]{index=5}
基本语法
以下是语法模板,执行前必须替换尖括号占位符。
rabbitmqctl set_policy \
  --vhost "<VHOST>" \
  "<POLICY_NAME>" \
  "<QUEUE_NAME_REGEX>" \
  '<JSON_DEFINITION>' \
  --priority <PRIORITY> \
  --apply-to queues
--vhost 限定作用域;正则匹配队列名;--priority 数字越大优先级越高;--apply-to queues 避免策略误匹配交换机。不同版本的成功提示可能略有差异,最终应通过 list_policies 验证。:contentReference[oaicite:6]{index=6}
主示例
以下策略只匹配默认 vhost 中以 prod. 开头的队列:消息保留 10 分钟,过期或超限消息进入 prod.dlx,最多保留 100000 条 ready 消息;达到上限后拒绝新发布并尝试死信,而不是默认丢弃最旧消息。
set -euo pipefail

rabbitmqctl set_policy \
  --vhost "/" \
  "prod-queue-guard" \
  '^prod\.' \
  '{"message-ttl":600000,"dead-letter-exchange":"prod.dlx","dead-letter-routing-key":"expired","max-length":100000,"overflow":"reject-publish-dlx"}' \
  --priority 10 \
  --apply-to queues

rabbitmqctl --vhost "/" list_policies --formatter=pretty_table
预期输出
Listing policies for vhost "/" ...
name              pattern  apply-to  definition                                   priority
prod-queue-guard  ^prod\.   queues    <TTL_DLX_LENGTH_AND_OVERFLOW_DEFINITION>      10
读取时确认 name、pattern、apply-to 和 priority 正确,并检查 definition 同时包含五个键。message-ttl 单位是毫秒;max-length 只统计 ready 消息,不包含已投递但尚未确认的消息。:contentReference[oaicite:7]{index=7}
常用参数
| 定义键 | 作用 | 生产注意 |
|---|---|---|
message-ttl |
队列内消息最大存活时间,毫秒 | 过期消息不会再交付;配置 DLX 时可转入死信 |
dead-letter-exchange |
指定死信交换机 | 交换机必须已声明,路由和权限也要可用 |
dead-letter-routing-key |
重写死信路由键 | 省略时通常沿用原路由键 |
max-length |
ready 消息数量上限 | 默认超限行为是从队首移除最旧消息 |
max-length-bytes |
ready 消息体总字节上限 | 与 max-length 同时存在时,先达到者生效 |
overflow |
drop-head、reject-publish 或 reject-publish-dlx |
拒绝发布要配合 publisher confirms 识别 basic.nack |
队列声明参数与 policy 同时设置相同限制时,不要假设 policy 一定覆盖应用配置;先检查客户端声明,并在测试队列验证最终生效值。队列长度限制的默认行为、计数口径和拒绝发布语义见官方长度限制规则。:contentReference[oaicite:8]{index=8}
风险与排障
- 触发条件:把正则写成
.*或漏写起止边界。可能后果:策略瞬间影响整个 vhost,大量消息过期、死信或被拒绝。安全替代:先用精确前缀匹配测试队列,再逐步扩大范围。 - 触发条件:多个策略匹配同一队列且优先级相同。可能后果:实际生效策略不确定。安全替代:合并定义,或设置明确且唯一的优先级;使用
rabbitmqadmin policies list_matching_object排查匹配结果。:contentReference[oaicite:9]{index=9} - 触发条件:DLX 不存在、路由无绑定或权限不足。可能后果:死信无法到达目标队列,形成消息丢失风险。安全替代:先声明并验证 DLX、绑定和权限,再启用 TTL 或长度限制。
- 触发条件:直接给大积压队列设置很短 TTL。可能后果:短时间内集中清理或死信,造成磁盘、网络和消费者突发负载。安全替代:分批缩小 TTL、限速死信消费者并观察
messages_ready和磁盘指标。
兼容性
RabbitMQ 3.13 及更早版本曾用 ha-mode、ha-params 等 policy 键配置经典队列镜像;该机制从 RabbitMQ 4.0 起已移除。4.x 的高可用队列应在声明阶段选择 quorum queue,或配置 vhost 默认队列类型,不能用普通 policy 把既有 classic queue 原地变成 quorum queue。:contentReference[oaicite:10]{index=10}
速查:TTL、DLX、长度和溢出可放在一个普通 policy;队列类型与 quorum 副本机制必须单独规划。
使用 operator policy 强制实施平台级资源与安全上限。
配置操作员策略
使用 operator policy 给某个 vhost 内的队列设置平台级上限,适合统一限制消息数量、消息存活时间或队列闲置时间。它不是权限策略,而是高于应用声明和普通 policy 的资源护栏;数值类参数通常取更保守的值。
命令定位
核心命令是 rabbitmqctl set_operator_policy。策略按 vhost 保存,使用正则匹配资源名称,并通过 --apply-to 限定队列类型。再次用相同名称声明会更新策略,list_operator_policies 用于确认当前定义。
高频用法
下面在默认 vhost / 中限制 app. 开头的队列:最多保留 100000 条 ready 消息,消息最长存活 24 小时。先用窄正则上线,避免误伤其他业务队列。
rabbitmqctl set_operator_policy -p / \
  platform-queue-guardrails '^app\.' \
  '{"max-length":100000,"message-ttl":86400000}' \
  --apply-to queues \
  --priority 50

rabbitmqctl list_operator_policies -p /
预期输出
Setting operator policy "platform-queue-guardrails" for pattern "^app\." to "..." with priority "50" for vhost "/" ...
Listing operator policies for vhost "/" ...
vhost  name                       pattern  apply-to  definition                                    priority
/      platform-queue-guardrails  ^app\.   queues    {"max-length":100000,"message-ttl":86400000}  50
读取时确认 vhost、pattern、apply-to 和 definition 都与预期一致;不同版本的表格边框或列间空白可能不同,但字段含义不变。
生效规则
| 来源 | 示例值 | 最终效果 |
|---|---|---|
| operator policy | max-length=100000 |
作为平台上限 |
| 普通 policy | max-length=200000 |
仍取 100000 |
| 应用声明 | x-max-length=50000 |
允许更严格的 50000 |
operator policy 不是强制固定值。应用或普通 policy 设置得更小仍会生效;设置得更大则被 operator policy 压低。新定义传播到大量实体时可能需要短暂时间,不要只看命令返回就立即判定全部队列已更新。
风险与边界
正则写成 .*、阈值过小或直接覆盖生产策略时,可能让大量队列同时触发过期、丢弃或拒绝发布。安全做法是先列出目标队列、使用业务前缀匹配、分批降低阈值,并提前确认 DLX、发布确认和告警是否能覆盖异常。
相同优先级的多条策略若同时匹配同一资源,最终选择可能不确定。避免重叠正则使用相同优先级;确需分层时,用明确的优先级和互斥命名规则。
回滚时删除 operator policy,而不是创建一个“无限大”策略:
rabbitmqctl clear_operator_policy -p / platform-queue-guardrails
rabbitmqctl list_operator_policies -p /
预期输出
Clearing operator policy "platform-queue-guardrails" on vhost "/" ...
Listing operator policies for vhost "/" ...
排障清单
- 策略未命中:检查 vhost、正则转义和队列名称,尤其注意 shell 对反斜杠与引号的处理。
- 限制看似无效:同时检查应用
x-arguments、普通 policy 与 operator policy,数值类参数按更保守值合并。 - 命令成功但队列未变化:等待短暂传播后再查队列参数;大型集群应结合管理 API 或监控抽样验证。
- 删除后仍有限制:继续检查普通 policy 和客户端声明,operator policy 只移除了平台层覆盖。
启用 AMQPS、限制协议版本并校验证书与主机名。
配置 TLS 监听
在 RabbitMQ 上启用 AMQPS 监听,并让客户端校验证书链、主机名和 TLS 版本。示例采用 5671、TLS 1.2/1.3 与双向 TLS;若只需要客户端验证服务端证书,可关闭“必须提供客户端证书”的开关。
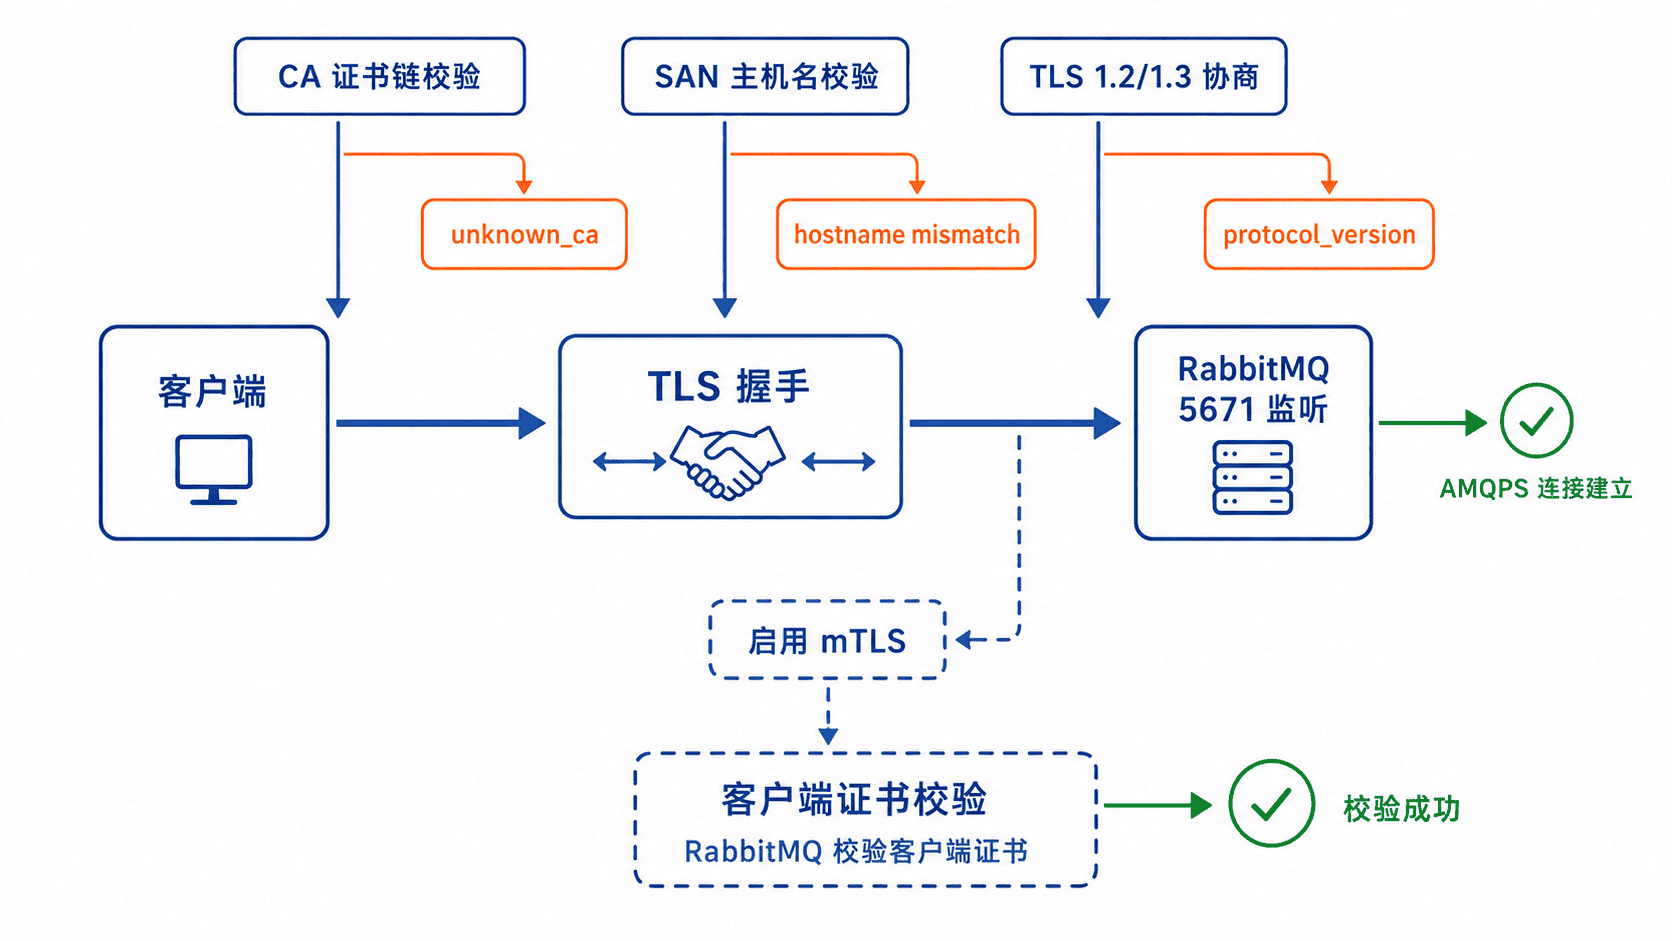
前置条件
服务端证书的 SAN 应包含客户端实际连接的 DNS 名,例如 rabbitmq.example.com,不要只依赖 CN。证书、私钥和 CA 文件必须为 RabbitMQ 进程可读的 PEM 文件,私钥权限应尽量收紧。
配置监听
将以下内容写入 rabbitmq.conf。示例保留现有明文监听用于迁移;全部客户端验证完成后,再启用注释中的 listeners.tcp = none 关闭 5672。
listeners.ssl.default = 5671
# 迁移完成后再取消注释,避免旧客户端立即中断
# listeners.tcp = none

ssl_options.cacertfile = /etc/rabbitmq/tls/ca.pem
ssl_options.certfile   = /etc/rabbitmq/tls/server.pem
ssl_options.keyfile    = /etc/rabbitmq/tls/server-key.pem

ssl_options.versions.1 = tlsv1.3
ssl_options.versions.2 = tlsv1.2

# mTLS:校验客户端证书,并拒绝未提供证书的连接
ssl_options.verify = verify_peer
ssl_options.fail_if_no_peer_cert = true
生效行为:RabbitMQ 在 5671 接受 TLS 1.2 或 1.3;服务端校验客户端证书链。若只做单向 TLS,将 ssl_options.fail_if_no_peer_cert 改为 false,客户端仍必须自行校验服务端 CA 与主机名。
重启与验证
配置变更后按部署方式重启 RabbitMQ 节点。先确认监听器,再用 OpenSSL 验证协议、CA 链、SNI、SAN 主机名和客户端证书;测试主机需要能读取示例中的证书文件。
rabbitmq-diagnostics listeners

openssl s_client \
  -connect rabbitmq.example.com:5671 \
  -servername rabbitmq.example.com \
  -verify_hostname rabbitmq.example.com \
  -CAfile /etc/rabbitmq/tls/ca.pem \
  -cert /etc/rabbitmq/tls/client.pem \
  -key /etc/rabbitmq/tls/client-key.pem \
  -tls1_2 < /dev/null
预期输出
Interface: [::], port: 5671, protocol: amqp/ssl, purpose: AMQP 0-9-1 and AMQP 1.0 over TLS
Verification: OK
Verify return code: 0 (ok)
实际接口地址、协商密码套件和日志时间可能不同。判断成功的关键是出现 amqp/ssl 监听、主机名校验通过,并且返回码为 0 (ok)。
风险与边界
直接设置 listeners.tcp = none 会让仍使用 amqp:// 或 5672 的客户端全部断开。安全替代方案是先双端口运行,完成客户端证书与连接串迁移,再关闭明文端口,并保留快速回滚配置。
设置 fail_if_no_peer_cert = true 会强制所有客户端提供可验证证书;未配置 mTLS 的客户端会在握手阶段失败。仅需服务端身份认证时使用 false,但客户端侧仍应开启 CA 与主机名校验,不能使用“信任所有证书”。
只允许 TLS 1.3 可能阻断旧版 JDK、.NET、OpenSSL 或 Erlang 运行时。迁移期同时允许 TLS 1.2 与 1.3,确认客户端矩阵后再收紧。使用 IP 连接时,证书必须包含对应 IP SAN;否则改用证书中的 DNS 名。
排障清单
- 节点无法启动:检查证书路径、PEM 格式、私钥口令、文件属主与权限,并查看 RabbitMQ 启动日志。
unknown ca:确认双方信任的是签发对端证书的 CA,并补齐中间证书链。hostname mismatch:核对客户端连接名、SNI 和证书 SAN,禁止用跳过主机名校验作为长期方案。protocol version或无共同密码套件:核对 Erlang/OTP、OpenSSL 与客户端支持范围,先恢复 TLS 1.2 兼容再逐步收紧。- 监听存在但 AMQP 客户端失败:OpenSSL 只验证 TLS 握手,还需继续检查客户端认证、vhost 权限和 AMQP 参数。